网关重启后,后台子代理不是白干了——它存着记录,还能自己接着跑
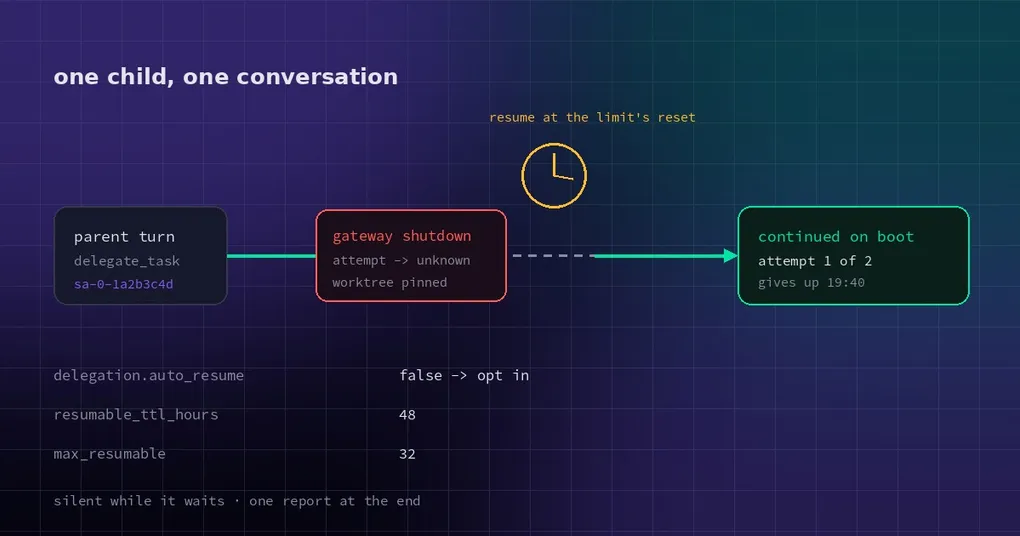
你让一个子代理去改一个跨 12 个文件的重构,它跑了 25 分钟,你已经看到它在改第 8 个文件。这时候你重启了一次网关——升级、换个配置、或者只是它自己崩了。回来一看,那条子代理记录停在 “unknown”,没有总结、没有 diff、没有下一步建议。它到底改到哪了?有没有写坏半个文件?只能自己翻 git 和终端历史。
这类事故的讨厌之处不在于白跑 25 分钟,而在于你失去了“它做到哪一步”这个信息——而这恰恰是重跑时最需要的东西。
重启那一刻,子代理是怎么“消失”的
子代理默认是跟着父会话的进程跑的。网关一停,正在执行的子代理就没有了执行者,Hermes 也无法证明它的最后一次工具调用到底有没有落地——所以结果被记成 unknown,而不是“失败”。失败可以重试,unknown 只能靠人去猜。
以前的处理方式是:接受这个损失,重开一个。现在的做法是,在开始之前就把“能续”这件事记录下来。
每个子代理在 state.db 里有一条持久记录
从 v0.23.2 这个窗口开始,每次派生子代理都会在 profile 的 state.db 里写一条 resumable_subagents 记录:
- 工作区刚准备好时写入启动记录;
- 心跳时更新检查点(终端当前目录变了就记下来);
- 清理跑完之后记下停止原因;
- 如果拥有它的进程直接死了,下次启动时的恢复流程会把它标成“被遗弃”。
记录里最关键的一个字段是“固定”(pin):它把子代理的工作目录——停止时终端所在的目录,以及它自己创建的 worktree——从启动扫描的清理名单里保下来。默认保留 48 小时(delegation.resumable_ttl_hours),每个 profile 最多同时固定 32 个(delegation.max_resumable),超过上限时最老的那个先失去固定。固定结束之后,正常清理会先把这棵树归档到 refs/hermes/archive/ 再删。
没跑完、也不是被你或父代理主动停掉的子代理才会被固定。已完成的、你手动停掉的,都不占这个名额。
resume_mode:它为什么停下,决定了怎么续
记录里有个 resume_mode 字段,说明这条子代理属于哪一类“可以续”的情形:
| resume_mode | 常见原因 | 继续之前要做什么 |
|---|---|---|
AUTO_AT |
用量/速率限制(带重置时间)、临时性 provider 错误 | 等到 failure_resets_at |
AUTO_ON_BOOT |
网关关闭、崩溃、被强杀 | 不需要等;先看一眼 git 状态和最后一次工具调用,再决定副作用要不要重跑 |
ON_FIX |
余额、鉴权、模型权限、账号策略、请求格式错误 | 你先把原因修好 |
REPAIR_THEN_CONTINUE |
会话超出上下文,或者图片/推理片段被拒 | 先把 transcript 修一下 |
HANDOFF |
provider 对这段对话做了安全拒绝 | 换个模型,或者父代理自己接手 |
限流类失败还会带上 failure_resets_at(套餐窗口的话还有 usage_limit),所以你不需要靠猜——什么时候再试能成功,记录里写着。
手动接上:delegate_task 的 continue
最直接的用法是手动续:
{"action": "continue", "subagent_id": "sa-0-1a2b3c4d", "message": "接着改剩下的 4 个文件,已经改过的不要重写"}它做的事比“重开一个”细:
- 用同一个路由重建——模型、provider、profile 和工具集都和原来一致;
- 历史从保存下来的 transcript 里读回来,
message成为下一轮; - 保留原来的
subagent_id和会话(transcript 是追加的,效果类似--resume); - 但它是一次新的后台派发,有自己的
delegation_id,结果照常以完成通知的形式回来。
几个拒绝条件值得记住:还在跑的子代理不能用 continue(用 steer);如果父代理在这期间换了模型,导致继承的路由解析到不同 provider 或端点,也会被拒绝;只有拥有它的对话(或 spawn 树上的祖先)能续它。它启动的后台进程早就没了,所以会给它一个新终端——起点就是它停下时所在的目录和 worktree。
continue 本质上是一次普通派发,所以关掉的会话、并发上限、spawn 深度、全局暂停,都会像拦一次新派生一样拦住它。
自动续:delegation.auto_resume
手动续适合“我知道它挂了”。更常见的情况是你根本不知道它挂了——所以有个开关:
delegation:
  auto_resume: true              # 默认 false
  auto_resume_deadline_minutes: 360
  resumable_ttl_hours: 48
  max_resumable: 32
打开之后,网关每 15 秒检查一次它服务的每个 profile(各自用该 profile 的配置、凭据和 state.db),把到点的记录续上。它走的是和手动 continue 完全相同的认领与续跑路径,续跑时的第一条消息会说明真实原因,比如“你的运行被 provider 限额中断,请从断开处继续”。
会续的只有两类:
AUTO_AT:等过了限流的重置时间;AUTO_ON_BOOT:网关重新起来之后。
不会续的也写得很明确:ON_FIX、REPAIR_THEN_CONTINUE、HANDOFF(这些要么等你修,要么需要换模型);你或父代理主动停掉的;在 auto_resume 关闭期间停下的(这些只给手动 continue 的提示);记录已过期、或 worktree 固定名额被挤掉的;以及嵌套子代理——那种情况下续的是那个编排者本身。
等待期间它是安静的,只在最后说一次
一个被承诺“会自动续”的子代理,停下来时不会给父代理发完成通知——否则父代理会以为活干完了,拿着半截结果继续干。等待期间,你在 delegate_task(action='list') 里会看到它标着 waiting_to_resume,后面跟着类似这样的说明:
waiting to resume at 14:05 (attempt 1 of 2); gives up at 19:40父代理只会在两种时刻听到一次结果:续跑成功后的那一份结果,或者放弃时的一条终态失败。放弃的条件有四个:两次自动尝试用完了;auto_resume_deadline_minutes(默认 360 分钟)从第一次停下算起已经过去;已经知道重置时间会晚于这个截止点(那它会立刻放弃,不白等);或者出现了永久性的原因(比如 worktree 固定被挤掉了)。
那条失败通知不是一句“失败了”——它带着原因、子代理最后的总结、transcript 的尾部,以及手动怎么续(delegate_task(action='continue', subagent_id=..., message=...))或怎么重新派发。这一点挺重要:自动续失败之后,你手上仍然有一份可以接着干的上下文。
三条安全规则,比“能续”本身更重要
不会重复干同一件事。 如果你在它等待期间又派发了一个目标完全相同(忽略首尾空白)的子代理,会被拒绝,并告诉你那个正在等待的 subagent_id、它什么时候续、以及两条出路:等它,或者先 action='stop' 再重新派发。批量子代理里只拒这一个,其他照跑。
不确定的副作用不许重放。 续跑时的第一条消息会提醒子代理:如果它最后一次工具调用没有记录到结果,而且无法确认那次调用到底跑没跑,就不许重试,必须以 BLOCKED: 开头、点名那次调用的方式收尾。这比“看起来成功了”诚实得多。
次数是有限的,而且在跑之前就记上。 每条记录最多 2 次自动尝试,计数在尝试开始之前就写进记录——所以那种“一续就把网关搞崩”的子代理不会无限循环重启。同一个重置时间上的多个子代理也不是一拥而上:每个 provider 端点每轮只起一个,间隔 15 秒。
什么时候该关掉它
auto_resume 默认是关的,原因写在文档里:它会在没人看着的时候花 token,而续跑成功后启动的父代理回合也会花 token。如果你的用量是“按量付费且没有上限”,或者你的子代理经常在同一个错误上失败,先别开——先看清楚失败类型,再决定是修配置还是换模型。
反过来,如果你的痛点是“笔记本合上 / 网关重启 / 夜里限流”这类纯粹的环境中断,那这个开关几乎是为它设计的。
想先理解子代理结果如何唤醒父代理,可以看后台子代理失败唤醒的那篇;想知道并发控制和实时 steer,看子代理实时编排。完整改动在 v0.23.2 版本页。
小结
“子代理跑到一半没了”这件事,以前只能靠重跑解决,代价是重复的 token 和可能重复的副作用。现在这条链路变成:停下时留下记录和工作目录 → resume_mode 说明原因 → 手动 continue 或自动 auto_resume 接上 → 等待期间安静、结束时只报一次 → 不确定的调用标记 BLOCKED 而不是重放。
它不会让崩溃变得不存在,但会把“白干 25 分钟”变成“接着改剩下 4 个文件”。