Un redémarrage du gateway effaçait votre subagent — il tient maintenant un registre et reprend tout seul
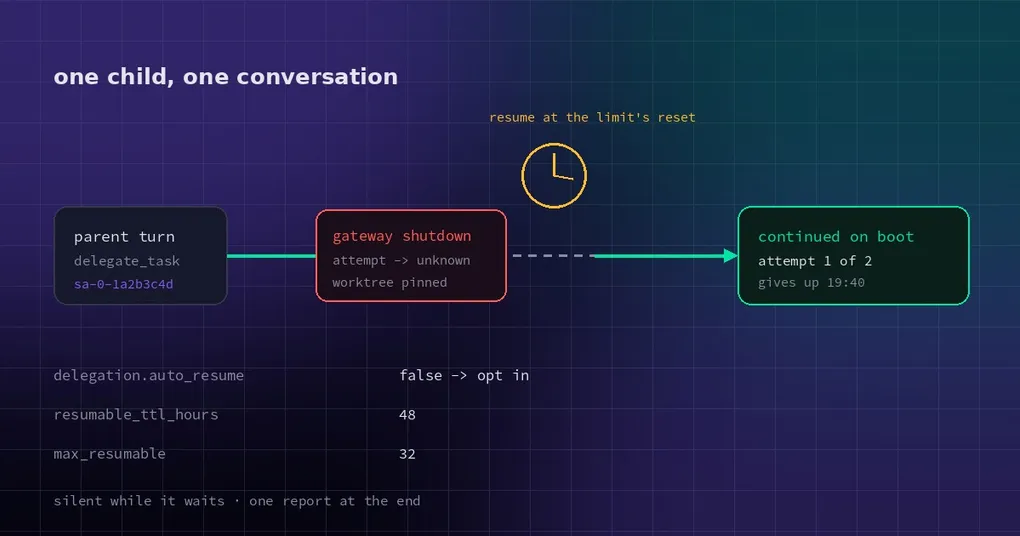
Vous confiez à un subagent un refactor qui traverse douze fichiers. Il tourne depuis 25 minutes et vous le voyez au huitième fichier. Puis vous redémarrez le gateway — une mise à jour, un changement de config, ou simplement une chute. Quand vous revenez, la ligne du subagent dit unknown. Pas de résumé, pas de diff, pas d’indice sur la suite. A-t-il fini les huit fichiers ? A-t-il laissé un fichier à moitié écrit ?
Le plus coûteux n’est pas ces 25 minutes. C’est de perdre la réponse à « jusqu’où est-il allé », exactement l’information dont vous avez besoin pour décider quoi faire maintenant.
Ce qui se passe réellement au redémarrage
Un subagent d’arrière-plan tourne à l’intérieur du processus qui possède la conversation. Quand le gateway s’arrête, l’exécuteur a disparu, et Hermes ne peut pas prouver si le dernier appel d’outil de l’enfant a abouti. Le résultat est donc enregistré comme unknown plutôt que comme un échec. Un échec se retente. unknown signifiait jusqu’ici lire git status à la main et deviner.
Le correctif n’est pas de rendre les crashes impossibles. C’est d’écrire assez de choses avant le crash pour que le travail puisse être repris après.
Chaque enfant a désormais une ligne durable dans state.db
Depuis la fenêtre v0.23.2, chaque subagent lancé tient un registre dans le state.db du profile (la table resumable_subagents) :
record_startquand son workspace est initialisé ;checkpointà chaque heartbeat, et à chaque fois que le répertoire de travail de son terminal bouge ;record_stopaprès l’exécution de son nettoyage ;- et, si le processus propriétaire est mort net, la récupération au démarrage marque le registre comme abandonné.
Le champ qui compte le plus est l’épingle. Un enfant qui n’a pas terminé et que personne n’a arrêté garde son worktree — le répertoire dans lequel son terminal se trouvait à l’arrêt, plus tout worktree qu’il a créé — hors du balayage de démarrage. Cela dure delegation.resumable_ttl_hours (48 heures par défaut), pour au plus delegation.max_resumable enregistrements par profile (32 par défaut) ; au-delà du plafond, le plus ancien perd son épingle en premier. Quand l’épingle expire, le balayage normal archive l’arbre dans refs/hermes/archive/ avant de le supprimer. Les enfants terminés et ceux que vous avez arrêtés ne sont pas épinglés du tout.
resume_mode : pourquoi il s’est arrêté décide comment il continue
Chaque enregistrement porte un resume_mode, qui est la différence entre « retente-le » et « retente-le et perds encore 25 minutes » :
| resume_mode | Cause typique | Ce qu’il faut pour continuer |
|---|---|---|
AUTO_AT |
usage ou rate limit avec une heure de reset, erreurs transitoires du provider | attendre failure_resets_at |
AUTO_ON_BOOT |
arrêt du gateway, crash, kill brutal | rien ; vérifier l’état git et le dernier appel d’outil avant de rejouer les effets de bord |
ON_FIX |
crédits, auth, accès modèle, politique de compte, erreurs de forme de requête | vous corrigez la cause d’abord |
REPAIR_THEN_CONTINUE |
la conversation ne rentre plus, ou une partie image/raisonnement a été refusée | la transcription doit être réparée d’abord |
HANDOFF |
un refus de sécurité du provider sur cette conversation | un autre modèle, ou le parent qui prend la main |
Un échec de limite porte aussi failure_resets_at, et usage_limit quand une fenêtre de plan est en jeu — « quand puis-je réessayer » est donc une valeur dans l’enregistrement, pas une supposition.
Continuer à la main
{"action": "continue", "subagent_id": "sa-0-1a2b3c4d", "message": "finish the remaining 4 files; do not rewrite what is already done"}Ce que cela fait est plus prudent que lancer un enfant tout neuf :
- il reconstruit l’enfant sur la même route — modèle, provider, profile et toolsets ;
- son historique est chargé depuis la transcription enregistrée, et
messagedevient le tour suivant ; - il conserve le même
subagent_idet la même session, donc la transcription s’allonge comme avec--resume; - mais c’est une nouvelle délégation d’arrière-plan avec son propre
delegation_id, donc le résultat arrive comme un completion normal.
Quelques refus valent d’être connus. Un enfant encore en cours ne peut pas être continué — pilotez-le plutôt. Un enfant dont la route héritée résout maintenant vers un autre provider ou endpoint, parce que le parent a changé de modèle depuis, est refusé aussi. Seule la conversation propriétaire, ou un ancêtre dans son arbre de spawn, peut continuer un enfant. Ses processus d’arrière-plan ont depuis longtemps disparu : il obtient un terminal neuf qui démarre dans le répertoire et le worktree où il s’est arrêté.
Une continuation est un dispatch ordinaire, ce qui veut dire qu’un chat fermé, max_concurrent_children, max_spawn_depth et la pause globale de spawn la refusent exactement comme ils refusent un spawn.
La reprise automatique
La continuation manuelle suppose que vous ayez remarqué. L’interrupteur optionnel couvre le cas où vous n’avez pas vu :
delegation:
  auto_resume: true              # défaut : false
  auto_resume_deadline_minutes: 360
  resumable_ttl_hours: 48
  max_resumable: 32
Activé, le gateway passe en revue chaque profile qu’il sert toutes les 15 secondes — chacun sous la configuration, les identifiants et le state.db de ce profile — et continue les enregistrements arrivés à échéance par le même chemin de claim et de continuation que l’action manuelle. Le message de reprise nomme la vraie cause : « Votre exécution a été arrêtée par une limite du provider ; reprenez là où vous en étiez. »
Deux types seulement reprennent automatiquement : AUTO_AT une fois le reset de la limite passé, et AUTO_ON_BOOT une fois le gateway remonté.
Ce qui ne reprend jamais : les enfants ON_FIX, REPAIR_THEN_CONTINUE et HANDOFF (il faut vous, une réparation, ou un autre modèle) ; tout ce que vous ou le parent avez arrêté ; un enfant dont l’arrêt a eu lieu alors que auto_resume était désactivé, ou sous un parent qu’aucun gateway ne sert — ceux-là reçoivent l’indice manuel à la place ; les enregistrements expirés ; ceux dont l’épingle de worktree a été lâchée par le plafond max_resumable ; et les enfants imbriqués, parce que c’est l’orchestrateur qui les a engendrés qui reprend.
Silencieux pendant l’attente, un seul rapport à la fin
Un enfant à qui une reprise automatique a été promise n’envoie aucun completion au parent quand il s’arrête — sinon le parent croirait le travail fini et agirait sur un demi-résultat. Pendant l’attente, delegate_task(action='list') l’affiche comme waiting_to_resume avec une ligne du genre :
waiting to resume at 14:05 (attempt 1 of 2); gives up at 19:40Dans un lot où seuls certains enfants attendent, le completion les liste avec ce même statut, et la vue des délégations échouées ne les compte pas comme des échecs.
Le parent entend une seule fois par enfant : soit le résultat de l’exécution reprise, soit un échec terminal quand l’ordonnanceur abandonne. L’abandon survient quand les deux tentatives automatiques sont consommées, quand delegation.auto_resume_deadline_minutes (360 par défaut) est dépassé depuis le premier arrêt, quand le reset connu tombe après cette échéance (il abandonne tout de suite plutôt que d’attendre pour rien), ou quand une raison définitive apparaît — une épingle de worktree lâchée, par exemple.
Cet échec n’est pas un haussement d’épaules. Il porte la raison, le dernier résumé de l’enfant, la fin de sa transcription, et la façon de le continuer à la main (delegate_task(action='continue', subagent_id=..., message=...)) ou de le relancer. Une reprise automatique qui échoue vous laisse quand même un contexte utilisable.
Trois règles de sécurité qui comptent plus que la reprise
Pas de travail en double. Si vous lancez un nouvel enfant dont l’objectif est exactement celui d’un enfant en attente de reprise (espaces mis à part), le spawn est refusé avec le subagent_id en attente, l’heure de reprise, et les deux issues possibles : attendre, ou faire action='stop' puis relancer. Dans un lot, seule cette tâche est refusée ; ses voisines tournent.
Les effets de bord non confirmés ne sont jamais rejoués. Le message de reprise le dit à l’enfant : si son dernier appel d’outil n’a pas de résultat enregistré et qu’il ne peut pas établir si l’appel a eu lieu, il ne doit pas le répéter, et doit finir avec un résultat commençant par BLOCKED: nommant cet appel. C’est une bien meilleure réponse qu’un doublon plein d’assurance.
Les tentatives sont bornées, et comptées avant d’être exécutées. Au plus deux tentatives automatiques par enregistrement, écrites dans l’enregistrement avant que la tentative commence — ainsi un enfant dont la reprise fait planter le gateway à chaque fois s’arrête au bout de deux démarrages au lieu de boucler. Les enfants qui attendent le même reset démarrent un par endpoint de provider et par passe, à 15 secondes d’intervalle, pas tous ensemble.
Quand le laisser désactivé
auto_resume vaut false par défaut pour une raison : un enfant repris dépense des tokens sans personne qui regarde, et le tour du parent qui démarre sur son résultat aussi. Si votre budget est compté et sans plafond, ou si vos enfants échouent toujours sur la même erreur, laissez-le désactivé jusqu’à savoir à quelle classe d’échec vous avez affaire. Si votre douleur est purement environnementale — capot de portable, redémarrage du gateway, rate limit nocturne — cet interrupteur est fait exactement pour ça.
Pour comprendre comment le résultat d’un enfant réveille le parent, voyez le réveil sur échec d’un subagent d’arrière-plan ; pour la concurrence et le pilotage en direct, l’orchestration live des subagents. L’ensemble des changements est sur la page de release v0.23.2.
La version courte
« La moitié de mon subagent a disparu » n’avait qu’un correctif : le relancer, payer les tokens, espérer que les effets de bord étaient idempotents. Le chemin ressemble maintenant à : un enregistrement durable et un worktree épinglé au moment de l’arrêt → resume_mode qui explique la cause → continue à la main ou auto_resume automatique → silence pendant l’attente, un rapport à la fin → les appels d’outil incertains marqués BLOCKED au lieu d’être rejoués.
Les crashes arrivent toujours. Ce qui change, c’est le coût : au lieu de 25 minutes perdues, il reste quatre fichiers.