Un reinicio del gateway borraba tu subagente; ahora guarda un registro y se reanuda solo
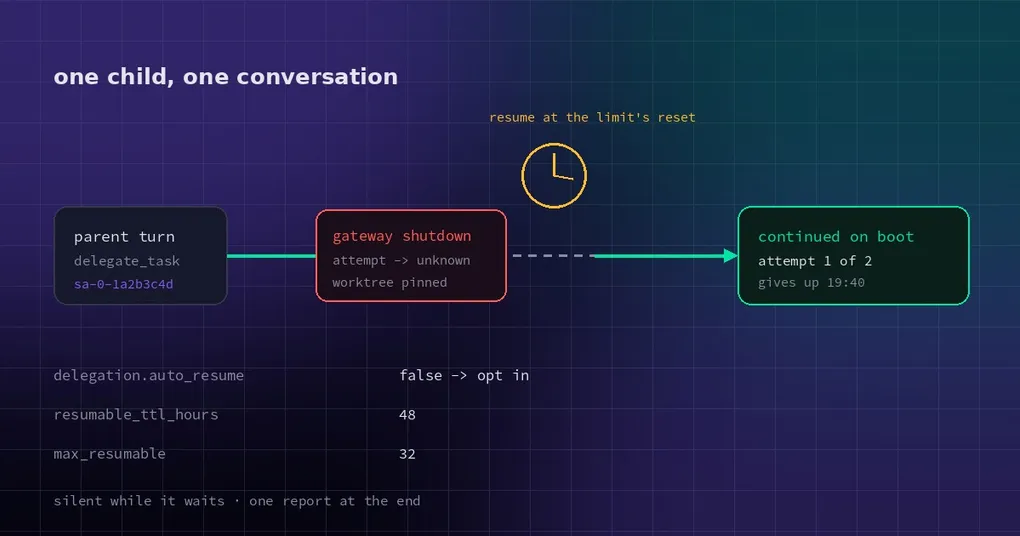
Le pasas a un subagente un refactor que toca doce archivos. Lleva 25 minutos corriendo y lo ves por el archivo ocho. Entonces reinicias el gateway: una actualización, un cambio de config o simplemente se cayó. Cuando vuelves, la fila del subagente dice unknown. Sin resumen, sin diff, sin ninguna pista de qué viene después. ¿Terminó los ocho archivos? ¿Dejó alguno a medio escribir?
La parte cara no son los 25 minutos. Es perder la respuesta a «hasta dónde llegó», que es justo la información que necesitas para decidir qué hacer ahora.
Qué pasa realmente en el reinicio
Un subagente en background corre dentro del proceso que es dueño de la conversación. Cuando el gateway se para, el executor desaparece y Hermes no puede demostrar si la última tool call del hijo llegó a ejecutarse. Así que el resultado se registra como unknown en lugar de «fallido». Un fallo se puede reintentar. unknown significaba hasta ahora que una persona leyera git status y adivinara.
El arreglo no consiste en hacer imposibles los crashes. Consiste en apuntar lo suficiente antes del crash como para poder retomar el trabajo después.
Cada hijo tiene ahora una fila duradera en state.db
Desde la ventana de v0.23.2, cada subagente despachado guarda un registro en el state.db del profile (la tabla resumable_subagents):
record_startcuando se siembra su workspace;checkpointen cada heartbeat, o cada vez que se mueve el directorio de trabajo de su terminal;record_stopdespués de que corra su limpieza;- y, si el proceso dueño murió del todo, la recuperación de arranque marca el registro como abandonado.
El campo que más importa es el pin. Un hijo que no terminó y que nadie paró a mano conserva su worktree (el directorio en el que estaba su terminal al pararse, más cualquier worktree que haya creado) fuera del barrido de arranque. Eso dura delegation.resumable_ttl_hours (48 horas por defecto), para un máximo de delegation.max_resumable registros por profile (32 por defecto); pasado el límite, el más antiguo pierde el pin primero. Cuando el pin caduca, el barrido normal archiva el árbol en refs/hermes/archive/ antes de borrarlo. Los hijos completados y los que paraste tú no se fijan nunca.
resume_mode: por qué se paró decide cómo continúa
Cada registro lleva un resume_mode, que es la diferencia entre «reinténtalo» y «reinténtalo y pierde otros 25 minutos»:
| resume_mode | Causa típica | Qué necesita para continuar |
|---|---|---|
AUTO_AT |
límite de uso o rate limit con hora de reset, errores transitorios del proveedor | esperar a failure_resets_at |
AUTO_ON_BOOT |
apagado del gateway, crash, kill duro | nada; revisa el estado de git y la última tool call antes de repetir efectos secundarios |
ON_FIX |
créditos, auth, acceso al modelo, política de cuenta, errores de forma de la request | primero arreglas tú la causa |
REPAIR_THEN_CONTINUE |
la conversación ya no cabe, o se rechazó una parte de imagen/razonamiento | hay que reparar antes la transcripción |
HANDOFF |
un rechazo de seguridad del proveedor sobre esta conversación | otro modelo, o que el padre se haga cargo |
Un fallo por límite también trae failure_resets_at, y usage_limit cuando hay una ventana de plan de por medio, así que «cuándo puedo volver a intentarlo» es un valor del registro, no una conjetura.
Continuar a mano
{"action": "continue", "subagent_id": "sa-0-1a2b3c4d", "message": "finish the remaining 4 files; do not rewrite what is already done"}Lo que hace es más cuidadoso que despachar un hijo nuevo:
- reconstruye el hijo en la misma ruta: modelo, proveedor, profile y toolsets;
- su historial se carga de la transcripción guardada y
messagepasa a ser el siguiente turno; - mantiene el mismo
subagent_idy la misma sesión, así que la transcripción se amplía igual que con--resume; - pero es una delegación en background nueva, con su propio
delegation_id, así que el resultado llega como una completion normal.
Hay unos cuantos rechazos que conviene conocer. Un hijo que sigue corriendo no se puede continuar: mejor dirigirlo. Un hijo cuya ruta heredada resuelve ahora a otro proveedor u otro endpoint, porque el padre cambió de modelo desde que corrió, también se rechaza. Solo la conversación dueña, o un ancestro de su árbol de spawn, puede continuar a un hijo. Sus procesos en background hace tiempo que no están, así que recibe una terminal nueva que arranca en el directorio y el worktree donde se paró.
Un continue es un dispatch normal, lo que significa que un chat cerrado, max_concurrent_children, max_spawn_depth y la pausa global de spawn lo rechazan exactamente igual que rechazan un spawn.
Reanudación automática
El continue manual da por hecho que te diste cuenta. El interruptor opt-in cubre el caso en el que no:
delegation:
  auto_resume: true              # default: false
  auto_resume_deadline_minutes: 360
  resumable_ttl_hours: 48
  max_resumable: 32
Con el interruptor activo, el gateway revisa cada 15 segundos cada profile que sirve (cada uno con su propia configuración, credenciales y state.db) y continúa los registros que tocan por el mismo camino de claim y continue que la acción manual. El mensaje de reanudación nombra la causa real: «Tu ejecución se paró por un límite del proveedor; sigue donde lo dejaste».
Solo dos clases se reanudan solas: AUTO_AT, cuando ya pasó el reset del límite, y AUTO_ON_BOOT, cuando el gateway vuelve a estar arriba.
Lo que nunca se reanuda: los hijos ON_FIX, REPAIR_THEN_CONTINUE y HANDOFF (esos te necesitan a ti, una reparación o otro modelo); cualquier cosa que hayas parado tú o el padre; un hijo cuyo parón ocurrió con auto_resume desactivado, o bajo un padre que ningún gateway sirve (esos reciben la pista manual); los registros caducados; los registros cuyo pin de worktree se cayó por el límite de max_resumable; y los hijos anidados, porque quien los reanuda es el orquestador que los lanzó.
Silencio mientras espera, un solo informe al final
Un hijo al que se le prometió reanudación automática no manda ninguna completion al padre cuando se para; si no, el padre creería que el trabajo terminó y actuaría sobre medio resultado. Mientras espera, delegate_task(action='list') lo muestra como waiting_to_resume con una línea tipo:
waiting to resume at 14:05 (attempt 1 of 2); gives up at 19:40En un batch en el que solo esperan algunos hijos, la completion los lista con ese mismo estado, y la vista de delegaciones fallidas no los cuenta como fallos.
El padre recibe un aviso por hijo: o el resultado de la ejecución reanudada, o un único fallo terminal cuando el scheduler se rinde. Se rinde cuando se agotan los dos intentos automáticos, cuando han pasado delegation.auto_resume_deadline_minutes (360 por defecto) desde el primer parón, cuando el reset conocido cae después de ese plazo (se rinde de inmediato en lugar de esperar por nada) o cuando aparece un motivo permanente, por ejemplo un pin de worktree perdido.
Ese fallo no es un encogimiento de hombros. Trae el motivo, el último resumen del hijo, la cola de su transcripción y cómo continuarlo a mano (delegate_task(action='continue', subagent_id=..., message=...)) o volver a despacharlo. Que falle la reanudación automática te deja igualmente con contexto utilizable.
Tres reglas de seguridad que importan más que la propia reanudación
Nada de trabajo duplicado. Si despachas un hijo nuevo cuyo objetivo es exactamente el de un hijo que espera para reanudarse (ignorando espacios), el spawn se rechaza con el subagent_id que espera, cuándo se va a reanudar y las dos salidas: esperar, o hacerle action='stop' primero y volver a despachar. En un batch solo se rechaza esa tarea; sus hermanas siguen.
Los efectos secundarios sin confirmar nunca se repiten. El mensaje de reanudación le dice al hijo: si su última tool call no tiene resultado registrado y no puede establecer si se ejecutó, no debe repetirla, y debe terminar con un resultado que empiece por BLOCKED: nombrando esa llamada. Es una respuesta mucho mejor que un duplicado con aspecto de seguridad.
Los intentos tienen tope, y se cuentan antes de ejecutarse. Como mucho dos intentos automáticos por registro, escritos en el registro antes de que el intento empiece, de modo que un hijo cuya reanudación tumba el gateway cada vez se para a los dos arranques en lugar de entrar en bucle. Los hijos que esperan el mismo reset se lanzan de uno en uno por endpoint de proveedor en cada pasada, con 15 segundos entre ellos, no todos a la vez.
Cuándo dejarlo desactivado
auto_resume viene en false por un motivo: un hijo reanudado gasta tokens sin que nadie mire, y el turno del padre que arranca con su resultado también. Si tu presupuesto se factura por uso y no tiene techo, o si tus hijos fallan siempre por el mismo error, déjalo desactivado hasta que sepas con qué clase de fallo estás lidiando. Si tu problema es puramente ambiental (cerrar la tapa del portátil, un reinicio del gateway, un rate limit nocturno), este interruptor está hecho justo para eso.
Para entender cómo el resultado de un hijo despierta al padre, mira el despertar por fallo de un subagente en background; para concurrencia y dirección en vivo, orquestación de subagentes en vivo. El conjunto completo de cambios está en la página del release v0.23.2.
En resumen
«Mi subagente desapareció a medias» tenía antes un solo arreglo: volver a lanzarlo, pagar los tokens y confiar en que los efectos secundarios fueran idempotentes. Ahora el camino es: un registro duradero y un worktree fijado en el momento del parón → resume_mode explicando la causa → continue manual o auto_resume automático → silencio mientras espera, un solo informe al final → las tool calls inciertas marcadas BLOCKED en lugar de repetidas.
Los crashes siguen pasando. Lo que cambia es el coste: en lugar de 25 minutos tirados, son cuatro archivos pendientes.