Ein Gateway-Neustart hat deinen Subagenten früher ausgelöscht — jetzt führt er Akte und steht von selbst wieder auf
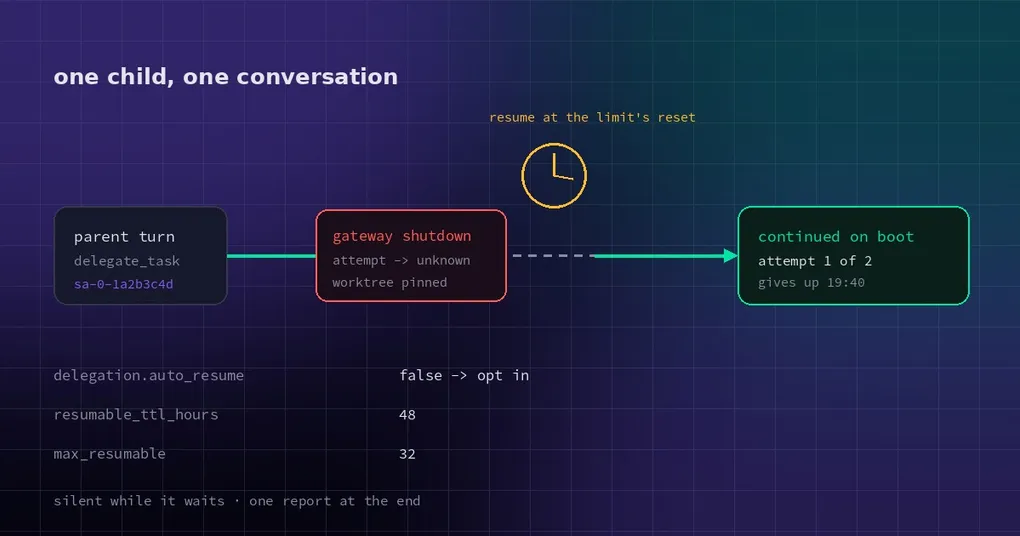
Du gibst einem Subagenten einen Refactor über zwölf Dateien. Nach 25 Minuten läuft er noch, du siehst ihn bei Datei acht. Dann startest du das Gateway neu — ein Upgrade, eine Config-Änderung, oder es ist einfach umgefallen. Als du zurückkommst, steht in der Zeile des Subagenten unknown. Keine Zusammenfassung, kein Diff, kein Hinweis, was als Nächstes kommt. Ist er durch acht Dateien gekommen? Hat er eine halb geschrieben liegen lassen?
Teuer sind nicht die 25 Minuten. Teuer ist der Verlust der Antwort auf „wie weit ist er gekommen“ — und genau die brauchst du, um zu entscheiden, was jetzt zu tun ist.
Was beim Neustart tatsächlich passiert
Ein Hintergrund-Subagent läuft in dem Prozess, dem das Gespräch gehört. Wenn das Gateway stoppt, ist der Executor weg, und Hermes kann nicht belegen, ob der letzte Tool-Call des Kindes noch gelandet ist. Das Ergebnis wird deshalb als unknown festgehalten und nicht als „failed“. Ein Fehler lässt sich wiederholen. unknown hieß früher: ein Mensch liest git status und rät.
Die Lösung besteht nicht darin, Abstürze unmöglich zu machen. Sie besteht darin, vor dem Absturz genug aufzuschreiben, dass die Arbeit danach wieder aufgenommen werden kann.
Jedes Kind hat jetzt eine dauerhafte Zeile in der state.db
Seit dem Fenster von v0.23.2 führt jeder entsandte Subagent einen Eintrag in der state.db des Profils (Tabelle resumable_subagents):
record_start, sobald sein Workspace angelegt ist;checkpointbei jedem Heartbeat, immer wenn sich das Arbeitsverzeichnis seines Terminals bewegt;record_stop, nachdem sein Cleanup gelaufen ist;- und wenn der besitzende Prozess hart gestorben ist, markiert die Boot-Recovery den Eintrag als verwaist.
Das wichtigste Feld ist der Pin. Ein Kind, das nicht fertig geworden ist und nicht von einem Menschen gestoppt wurde, behält seinen worktree — das Verzeichnis, in dem sein Terminal stand, als es stoppte, plus jeden worktree, den es selbst angelegt hat — und bleibt vom Startup-Sweep ausgenommen. Das gilt für delegation.resumable_ttl_hours (Standard: 48 Stunden) und für höchstens delegation.max_resumable Einträge pro Profil (Standard: 32); über der Grenze verliert der älteste zuerst seinen Pin. Läuft der Pin aus, archiviert der normale Sweep den Baum nach refs/hermes/archive/, bevor er ihn entfernt. Fertige Kinder und Kinder, die du gestoppt hast, werden gar nicht gepinnt.
resume_mode: warum es stoppte, entscheidet wie es weitergeht
Jeder Eintrag trägt einen resume_mode, und der ist der Unterschied zwischen „nochmal versuchen“ und „nochmal versuchen und weitere 25 Minuten verbrennen“:
| resume_mode | Typische Ursache | Was zum Weitermachen nötig ist |
|---|---|---|
AUTO_AT |
Usage- oder Rate-Limit mit Reset-Zeitpunkt, vorübergehende Provider-Fehler | auf failure_resets_at warten |
AUTO_ON_BOOT |
Gateway-Shutdown, Absturz, Hard-Kill | nichts; Git-Zustand und letzten Tool-Call prüfen, bevor Seiteneffekte erneut laufen |
ON_FIX |
Credits, Auth, Modellzugriff, Account-Policy, Fehler im Request-Aufbau | du behebst zuerst die Ursache |
REPAIR_THEN_CONTINUE |
das Gespräch passt nicht mehr, oder ein Bild-/Reasoning-Teil wurde abgelehnt | das Transcript muss zuerst repariert werden |
HANDOFF |
eine Safety-Verweigerung des Providers für dieses Gespräch | ein anderes Modell, oder das Elternteil übernimmt |
Ein Limit-Fehler trägt zusätzlich failure_resets_at, und usage_limit, wenn ein Plan-Fenster im Spiel ist — „wann kann ich es erneut versuchen“ ist damit ein Wert im Eintrag und keine Schätzung.
Von Hand fortsetzen
{"action": "continue", "subagent_id": "sa-0-1a2b3c4d", "message": "finish the remaining 4 files; do not rewrite what is already done"}Was dabei passiert, ist sorgfältiger als ein frisch entsandtes Kind:
- es baut das Kind auf derselben Route wieder auf — Modell, Provider, Profil und Toolsets;
- seine History wird aus dem gespeicherten Transcript geladen, und
messagewird der nächste Turn; - es behält dieselbe
subagent_idund Session, das Transcript wächst also so an, wie es--resumetut; - es ist aber eine neue Hintergrund-Delegation mit eigener
delegation_id, das Ergebnis kommt also als normale Completion an.
Ein paar Ablehnungen solltest du kennen. Ein Kind, das noch läuft, lässt sich nicht fortsetzen — steuere es stattdessen. Ein Kind, dessen geerbte Route inzwischen auf einen anderen Provider oder Endpoint auflöst, weil das Elternteil seit dem Lauf das Modell gewechselt hat, wird ebenfalls abgelehnt. Nur das besitzende Gespräch oder ein Vorfahr in seinem Spawn-Baum darf ein Kind fortsetzen. Seine Hintergrundprozesse sind längst weg, es bekommt also ein frisches Terminal, das in dem Verzeichnis und worktree startet, in dem es gestoppt ist.
Ein Continue ist ein ganz normaler Dispatch, was heißt: ein geschlossener Chat, max_concurrent_children, max_spawn_depth und die globale Spawn-Pause lehnen ihn genauso ab wie einen Spawn.
Automatisches Fortsetzen
Manuelles Fortsetzen setzt voraus, dass du es gemerkt hast. Der Opt-in-Schalter deckt den Fall ab, in dem du es nicht gemerkt hast:
delegation:
  auto_resume: true              # Standard: false
  auto_resume_deadline_minutes: 360
  resumable_ttl_hours: 48
  max_resumable: 32
Ist er an, prüft das Gateway alle 15 Sekunden jedes Profil, das es bedient — jeweils unter der eigenen Konfiguration, den eigenen Credentials und der eigenen state.db des Profils — und setzt die fälligen Einträge über denselben Claim- und Continue-Pfad fort wie die manuelle Aktion. Die Resume-Nachricht benennt die echte Ursache: „Your run was stopped by a provider limit; continue where you left off.“
Nur zwei Arten laufen automatisch weiter: AUTO_AT, sobald der Reset des Limits vorbei ist, und AUTO_ON_BOOT, sobald das Gateway wieder oben ist.
Was nie weiterläuft: ON_FIX-, REPAIR_THEN_CONTINUE- und HANDOFF-Kinder (die brauchen dich, eine Reparatur oder ein anderes Modell); alles, was du oder das Elternteil gestoppt hat; ein Kind, dessen Stopp passierte, während auto_resume aus war, oder unter einem Elternteil, das kein Gateway bedient — diese bekommen stattdessen den manuellen Hinweis; abgelaufene Einträge; Einträge, deren worktree-Pin die max_resumable-Grenze verdrängt hat; und verschachtelte Kinder, weil der Orchestrator, der sie gestartet hat, derjenige ist, der fortsetzt.
Still, solange es wartet, ein Bericht am Ende
Ein Kind, dem ein automatisches Fortsetzen zugesagt wurde, schickt dem Elternteil beim Stoppen keine Completion — sonst würde das Elternteil die Arbeit für erledigt halten und auf ein halbes Ergebnis reagieren. Während es wartet, zeigt delegate_task(action='list') es als waiting_to_resume mit einer Zeile wie:
waiting to resume at 14:05 (attempt 1 of 2); gives up at 19:40In einem Batch, in dem nur ein Teil der Kinder wartet, listet die Completion sie mit demselben Status auf, und die Ansicht der fehlgeschlagenen Delegationen zählt sie nicht als Fehlschläge.
Das Elternteil hört pro Kind genau einmal: entweder das eigene Ergebnis des fortgesetzten Laufs oder einen terminalen Fehlschlag, wenn der Scheduler aufgibt. Aufgegeben wird, wenn die beiden automatischen Versuche verbraucht sind, wenn seit dem ersten Stopp delegation.auto_resume_deadline_minutes (Standard: 360) vergangen ist, wenn der bekannte Reset nach dieser Frist liegt (dann gibt er sofort auf, statt auf nichts zu warten), oder wenn ein dauerhafter Grund auftaucht — ein verlorener worktree-Pin zum Beispiel.
Dieser Fehlschlag ist kein Schulterzucken. Er trägt den Grund, die letzte Zusammenfassung des Kindes, das Ende seines Transcripts und den Weg, es von Hand fortzusetzen (delegate_task(action='continue', subagent_id=..., message=...)) oder neu zu entsenden. Ein gescheitertes automatisches Fortsetzen lässt dich also trotzdem mit brauchbarem Kontext zurück.
Drei Sicherheitsregeln, die wichtiger sind als das Fortsetzen selbst
Keine doppelte Arbeit. Wenn du ein neues Kind entsendest, dessen Ziel exakt das Ziel eines wartenden Kindes ist (Leerraum mal außen vor), wird der Spawn abgelehnt — mit der wartenden subagent_id, dem Zeitpunkt des Fortsetzens und den zwei Wegen nach vorn: warten, oder es zuerst mit action='stop' stoppen und neu entsenden. In einem Batch wird nur diese eine Aufgabe abgelehnt; ihre Geschwister laufen.
Unbestätigte Seiteneffekte werden nie wiederholt. Die Resume-Nachricht sagt dem Kind: Hat sein letzter Tool-Call kein festgehaltenes Ergebnis und kann es nicht klären, ob der Aufruf gelaufen ist, darf es ihn nicht wiederholen und muss mit einem Ergebnis enden, das mit BLOCKED: beginnt und den Aufruf benennt. Das ist eine deutlich bessere Antwort als ein selbstsicher wirkendes Duplikat.
Versuche sind begrenzt und werden vor dem Lauf gezählt. Höchstens zwei automatische Versuche pro Eintrag, eingetragen bevor der Versuch startet — ein Kind, dessen Fortsetzen das Gateway jedes Mal zum Absturz bringt, hält also nach zwei Boots an, statt in einer Schleife zu hängen. Kinder, die auf denselben Reset warten, werden pro Durchlauf eins pro Provider-Endpoint gestartet, 15 Sekunden auseinander, nicht alle gleichzeitig.
Wann du es besser aus lässt
auto_resume steht aus gutem Grund auf false: Ein fortgesetztes Kind verbraucht Token, während niemand hinschaut, und der Elternturn, der auf sein Ergebnis reagiert, ebenso. Wenn dein Budget abgerechnet und nicht gedeckelt ist, oder wenn deine Kinder immer wieder am selben Fehler scheitern, lass es aus, bis du weißt, mit welcher Fehlerklasse du es zu tun hast. Wenn dein Ärger rein umgebungsbedingt ist — Laptopdeckel zu, Gateway-Neustart, ein nächtliches Rate-Limit —, dann ist dieser Schalter genau dafür gebaut.
Wie das Ergebnis eines Kindes das Elternteil aufweckt, steht in Hintergrund-Subagent und Failure-Wake; zu Nebenläufigkeit und Live-Steuerung in Subagenten live orchestrieren. Der komplette Änderungssatz steht auf der v0.23.2-Release-Seite.
Die Kurzfassung
„Mein halber Subagent ist verschwunden“ hatte früher genau eine Antwort: nochmal laufen lassen, die Token bezahlen, hoffen, dass die Seiteneffekte idempotent waren. Der Weg sieht jetzt so aus: dauerhafter Eintrag und gepinnter worktree im Moment des Stopps → resume_mode erklärt die Ursache → manuelles continue oder automatisches auto_resume → Stille während des Wartens, ein Bericht am Ende → unsichere Tool-Calls werden als BLOCKED markiert statt wiederholt.
Abstürze passieren weiterhin. Was sich ändert, sind die Kosten: statt 25 verbrannten Minuten sind es vier übrige Dateien.