Um restart do gateway apagava seu subagent — agora ele guarda um registro e se retoma sozinho
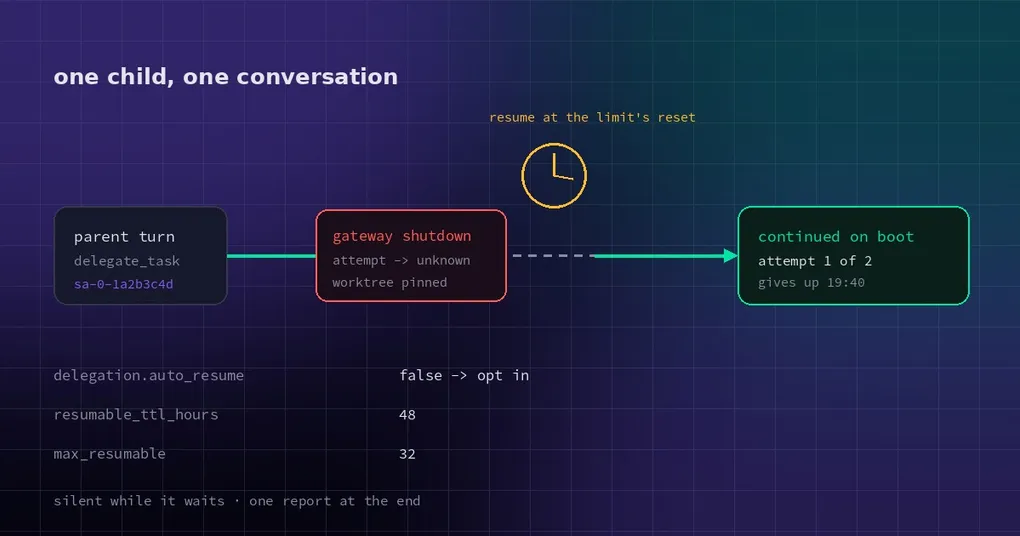
Você entrega a um subagent um refactor que atravessa doze arquivos. Ele está rodando há 25 minutos e você consegue vê-lo chegar ao oitavo arquivo. Aí você reinicia o gateway — uma atualização, uma mudança de configuração, ou ele simplesmente caiu. Quando você volta, a linha do subagent diz unknown. Sem resumo, sem diff, sem dica do que vem depois. Ele passou pelos oito arquivos? Deixou algum pela metade?
A parte caro não são os 25 minutos. É perder a resposta para “até onde ele chegou”, que é exatamente a informação de que você precisa para decidir o que fazer agora.
O que acontece de fato no restart
Um subagent em background roda dentro do processo que é dono da conversa. Quando o gateway para, o executor sumiu, e o Hermes não consegue provar se a última chamada de ferramenta do filho chegou a acontecer. Por isso o desfecho é registrado como unknown em vez de “failed”. Uma falha dá para repetir. unknown costumava significar uma pessoa lendo git status e adivinhando.
A solução não é tornar crashes impossíveis. É anotar o suficiente antes do crash para que o trabalho possa ser retomado depois.
Cada filho agora tem uma linha durável no state.db
Desde a janela da v0.23.2, cada subagent despachado mantém um registro no state.db do profile (a tabela resumable_subagents):
record_startquando o workspace dele é preparado;checkpointa cada heartbeat, sempre que o diretório de trabalho do terminal dele muda;record_stopdepois que a limpeza dele rodou;- e, se o processo dono morreu de vez, a recuperação de boot marca o registro como abandonado.
O campo que mais importa é o pin. Um filho que não terminou e não foi parado por uma pessoa mantém o worktree — o diretório em que o terminal dele estava quando parou, mais qualquer worktree que ele tenha criado — fora da varredura de startup. Isso dura delegation.resumable_ttl_hours (48 horas por padrão), para no máximo delegation.max_resumable registros por profile (32 por padrão); passando o limite, o mais antigo perde o pin primeiro. Quando o pin acaba, a varredura normal arquiva a árvore em refs/hermes/archive/ antes de removê-la. Filhos concluídos e filhos que você parou não recebem pin nenhum.
resume_mode: por que parou decide como continua
Cada registro carrega um resume_mode, que é a diferença entre “tentar de novo” e “tentar de novo e desperdiçar mais 25 minutos”:
| resume_mode | Causa típica | O que continuar exige |
|---|---|---|
AUTO_AT |
limite de uso ou rate limit com hora de reset, erros transitórios do provider | esperar por failure_resets_at |
AUTO_ON_BOOT |
desligamento do gateway, crash, kill forçado | nada; conferir o estado do git e a última chamada de ferramenta antes de repetir efeitos colaterais |
ON_FIX |
créditos, auth, acesso a modelo, política de conta, erros de formato da requisição | você conserta a causa primeiro |
REPAIR_THEN_CONTINUE |
a conversa não cabe mais, ou uma parte de imagem/raciocínio foi rejeitada | o transcript precisa ser reparado antes |
HANDOFF |
uma recusa de segurança do provider sobre esta conversa | outro modelo, ou o pai assume |
Uma falha por limite também carrega failure_resets_at, e usage_limit quando há uma janela de plano envolvida — então “quando posso tentar de novo” é um valor no registro, não um palpite.
Continuar na mão
{"action": "continue", "subagent_id": "sa-0-1a2b3c4d", "message": "termine os 4 arquivos restantes; não reescreva o que já está feito"}O que isso faz é mais cuidadoso do que despachar um filho novo:
- ele reconstrói o filho na mesma rota — modelo, provider, profile e toolsets;
- o histórico dele é carregado do transcript salvo, e
messagevira o próximo turno; - ele mantém o mesmo
subagent_ide a mesma sessão, então o transcript cresce como acontece com--resume; - mas é uma nova delegação em background, com seu próprio
delegation_id, então o resultado chega como uma completion normal.
Algumas recusas valem conhecer. Um filho que ainda está rodando não pode ser continuado — use steering nele. Um filho cuja rota herdada agora resolve para outro provider ou endpoint, porque o pai trocou de modelo desde que ele rodou, também é recusado. Apenas a conversa dona, ou um ancestral na árvore de spawn, pode continuar um filho. Os processos em background dele já sumiram há muito tempo, então ele ganha um terminal novo começando no diretório e no worktree em que parou.
Um continue é um despacho comum, o que significa que chat fechado, max_concurrent_children, max_spawn_depth e a pausa global de spawn recusam exatamente como recusariam um spawn.
Retomada automática
O continue manual assume que você percebeu. O interruptor opt-in cobre o caso em que você não percebeu:
delegation:
  auto_resume: true              # padrão: false
  auto_resume_deadline_minutes: 360
  resumable_ttl_hours: 48
  max_resumable: 32
Com ele ligado, o gateway confere a cada 15 segundos todos os profiles que serve — cada um sob a configuração, as credenciais e o state.db daquele profile — e continua os registros que estão no prazo pelo mesmo caminho de claim e continue da ação manual. A mensagem de retomada nomeia a causa real: “Sua execução foi interrompida por um limite do provider; continue de onde parou.”
Só dois tipos retomam automaticamente: AUTO_AT depois que o reset do limite passou, e AUTO_ON_BOOT depois que o gateway voltou.
O que nunca retoma: filhos ON_FIX, REPAIR_THEN_CONTINUE e HANDOFF (esses precisam de você, de um reparo ou de outro modelo); qualquer coisa que você ou o pai tenha parado; um filho cuja parada aconteceu com auto_resume desligado, ou sob um pai que nenhum gateway serve — esses recebem a dica manual em vez disso; registros expirados; registros cujo pin de worktree o limite de max_resumable derrubou; e filhos aninhados, porque o orquestrador que os gerou é justamente quem retoma.
Silêncio enquanto espera, um relatório no fim
Um filho que prometeu retomada automática não envia completion ao pai quando para — senão o pai acharia que o trabalho terminou e agiria sobre meio resultado. Enquanto espera, delegate_task(action='list') o mostra como waiting_to_resume com uma linha assim:
waiting to resume at 14:05 (attempt 1 of 2); gives up at 19:40Num lote em que só alguns filhos estão esperando, a completion os lista com esse mesmo status, e a visão de delegações falhas não os conta como falha.
O pai ouve uma vez por filho: ou o resultado da própria execução retomada, ou uma falha terminal quando o agendador desiste. Desistir acontece quando as duas tentativas automáticas se esgotam, quando delegation.auto_resume_deadline_minutes (padrão 360) passou desde a primeira parada, quando o reset conhecido cai depois desse prazo (ele desiste na hora em vez de esperar por nada), ou quando aparece um motivo permanente — um pin de worktree perdido, por exemplo.
Essa falha não é um encolher de ombros. Ela carrega o motivo, o último resumo do filho, a cauda do transcript dele e como continuá-lo na mão (delegate_task(action='continue', subagent_id=..., message=...)) ou despachá-lo de novo. Uma retomada automática que falha ainda deixa você com contexto utilizável.
Três regras de segurança que importam mais que a retomada em si
Nada de trabalho duplicado. Se você despacha um filho novo cujo objetivo é exatamente o objetivo de um filho esperando para retomar (ignorando espaços em branco), o spawn é recusado, com o subagent_id que está esperando, quando ele vai retomar e os dois caminhos possíveis: esperar, ou dar action='stop' nele primeiro e despachar de novo. Num lote, só aquela tarefa é recusada; as irmãs rodam.
Efeitos colaterais não confirmados nunca são repetidos. A mensagem de retomada avisa o filho: se a última chamada de ferramenta dele não tem resultado registrado e ele não consegue estabelecer se a chamada rodou, ele não pode repeti-la, e precisa terminar com um resultado começando por BLOCKED: nomeando aquela chamada. Isso é uma resposta muito melhor do que uma duplicata com cara de confiança.
As tentativas são limitadas, e contadas antes de rodarem. No máximo duas tentativas automáticas por registro, gravadas no registro antes de a tentativa começar — assim um filho cuja retomada quebra o gateway toda vez para depois de dois boots em vez de entrar em loop. Filhos esperando o mesmo reset são iniciados um por endpoint de provider a cada passagem, com 15 segundos de intervalo, não todos de uma vez.
Quando deixar desligado
auto_resume vem false por um motivo: um filho retomado gasta tokens sem ninguém olhando, e o turno do pai que recebe o resultado dele também. Se seu orçamento é medido e sem teto, ou se seus filhos insistem em falhar no mesmo erro, deixe desligado até saber com qual classe de falha você está lidando. Se o seu sofrimento é puramente ambiental — tampa do notebook, restart do gateway, um rate limit noturno —, esse interruptor foi feito exatamente para isso.
Para entender como o resultado de um filho acorda o pai, veja o despertar em falha de subagent em background; para concorrência e steering ao vivo, orquestração ao vivo de subagents. O conjunto completo de mudanças está na página da release v0.23.2.
A versão curta
“Metade do meu subagent desapareceu” costumava ter um único conserto: rodar de novo, pagar os tokens, torcer para os efeitos colaterais serem idempotentes. O caminho agora é: registro durável e worktree fixado no momento da parada → resume_mode explicando a causa → continue manual ou auto_resume automático → silêncio enquanto espera, um relatório no fim → chamadas de ferramenta incertas marcadas como BLOCKED em vez de repetidas.
Crashes ainda acontecem. O que muda é o custo: em vez de 25 minutos desperdiçados, são quatro arquivos restantes.