回复一个字一个字往外蹦,然后突然没了:Hermes 用一天修掉 10 个投递坑
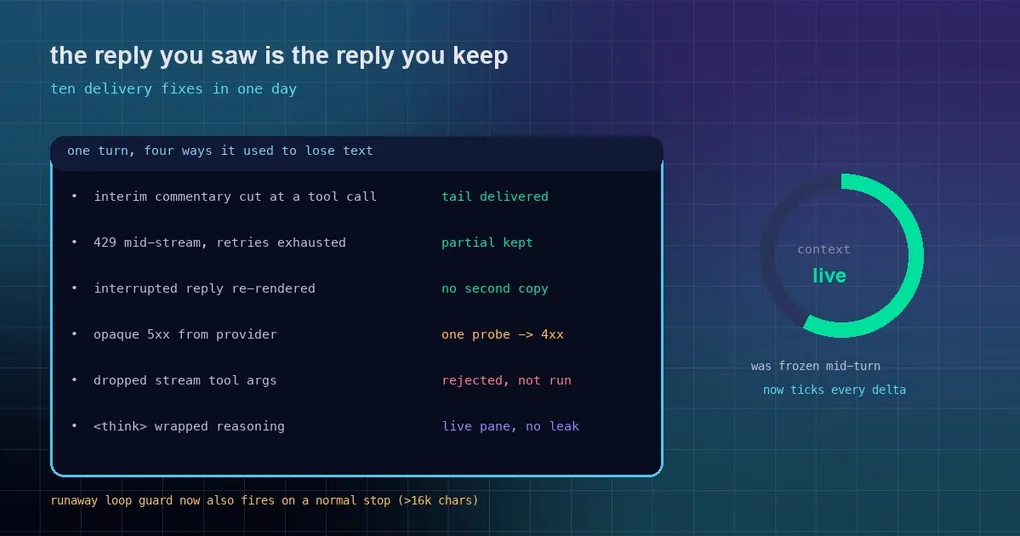
你盯着屏幕,回复一个字一个字往外蹦,突然停住了。几秒后它换了个说法重新开始——而你刚才已经读过的那半段,没了。另一种更气人的版本:你切到另一个会话看一眼,再切回来,同一条回复出现了两遍,一条是冻结的、一条还在长。还有第三种:右下角的上下文用量表从回合开始就没动过,你完全不知道离上限还有多远。
这些都不是模型变笨,是投递层的问题:文本已经在你的屏幕上出现过,但收尾逻辑觉得“这不算数”。2026 年 9 月 24 日,Hermes 集中合入了一批修复(10 个 PR,从早到晚),本篇按“你会怎么撞上它”的顺序逐条讲。
一、已经交给你的半截回复,不该被撤回
症状:流式过程中撞上 429 限流或者网络错误,重试几次后失败。你之前已经看到的那部分内容,随着失败一起消失了;历史里还留下几段看起来像孤儿消息的碎片。
机制:重试耗尽时,旧的收尾逻辑直接构造错误响应,已经在流里投递出去的内容不在它的考虑范围里。
修复(PR #121628):收尾前先执行一次 settle_delivered_partial,把已投递文本保留在错误响应里;同时 collapse_continuation_trail 把前几次重试留下的继续片段合并成一条消息(只处理当前用户消息之后的消息,回合索引无效时不做任何事)。同一批修复还顺手解决了另一半问题:当 transform_llm_output 插件改写了最终回复时,桌面上那个流式气泡现在会显示改写后的文本,和 state.db 里存的一致——以前气泡里留的是改写前的内容,刷新一下才对得上。
二、被打断的回复不该再渲染一遍
症状(经典 CLI):你在回复中途插入了一条消息,或者回复被工具调用打断。结果你之前已经看到过的文字,又作为一个整块 Panel 打印了一遍。
机制:发生工具调用切换时,流状态被重置,而“这次最终响应里有多少已经流式展示过”这个信息没有跨过重置保留下来。
修复(PR #121601):新增 _streamed_text_this_turn 记录真正流式输出过的文本,它能跨过 _reset_stream_state,每个用户回合只重置一次;只有当本回合确实被打断、且最终响应内容包含在这段已流式文本里(忽略空白差异)时,才抑制那个 Panel。「Operation interrupted: waiting for model response」、重试/退避提示这类没有流式展示过的状态消息仍然正常出 Panel。
同一个 PR 还修了两个相关的老毛病:开着 show_reasoning: true 时,推理字段独立的模型现在会正常流式输出答案,而不是等回合结束一次性砸出来(推理框在第一个正文 token 到达时就关闭);stdout 被管道接走、没有 TTY 时,Python 会做块缓冲,日志消费者会连续几分钟看不到任何东西——现在 headless 运行会对 stdout 做行缓冲。
三、桌面端的滚动不再“往上飘”,切会话不再出现两条回复
症状:你停在底部看回复生长,内容一多,整个视图往上飘,下一次滚动更新才弹回底部;或者你中途切到别的会话再切回来,同一条回复变成两条。
机制:前一个问题出在流式内容增长时没有钉住位置。后一个问题是激活流程既从已提交的部分重建了会话记录,又保留了本地那条还在长的实时行。
修复(PR #121602):用一个 ResizeObserver 把“停在底部”的读者(data-editing 内联编辑打开时跳过)持续钉在底部,底部判定走 threadScrollStateFromMetrics,指标来自与恢复观察器共用的 readThreadScrollResizeMetrics(),且清除元素通过 ref 读取,所以每次滚动事件不做 DOM 遍历。第二个问题:仍在流式输出的 dump 会折叠进同一回合已提交的部分,折叠只在“这部分确实提交于本回合内”成立时发生(两个时间戳都在,且部分不比回合起点更旧)。
四、上下文用量表要动起来
症状:回合进行中,上下文用量表一直冻在回合开始时的数字,回合结束才跳一下;回合结束之后,它有时还会退回上一个回合的分类明细。
机制:agent 忙碌时,表优先使用空闲时抓的 /context 快照(那是在回合开始前取的),于是流式过来的 session.usage 增量永远到不了表面;回合结束后一次失败或缓慢的空闲刷新,会把回合之前的快照又恢复回来。
修复(PR #121638):忙碌时改用实时流式的 $currentUsage;回合开始时让空闲快照失效,并且把“快照是否过期”的判断收进 use-context-breakdown 一个地方——只有不在忙碌、且是同一个会话时才返回分类明细,所以 ContextUsagePanel 也不会在第一个忙碌渲染里画出回合前的分类。这一条修的是 #70871 的“表被冻住”那一半(TUI/桌面端忙碌卡死那一半不在本次范围内)。
五、看不懂的 5xx 先探一次,没有状态码的流内错误要分类
症状 A:某个 provider 对你的流式请求返回一个光秃秃的 500/502/503,什么信息都没有。同样的请求不走流式却能返回一个带可操作信息的 4xx。你永远只看到那个没用的 5xx。
修复 A(PR #121541):流式请求拿到 5xx 时,用同样的 kwargs 做一次非流式探测(每 60 秒窗口最多一次,用 time.monotonic() 记时)。如果它返回 4xx,就把那个错误原地抛出;如果它成功,就把响应通过一个纯函数 _replay_final_response 回放。会话不会被切到非流式,也不会被“记住”。探测期间会暂停流式陈旧看门狗(_stream_stale_timeout = inf,用 try/finally 恢复),所以它不会被判超时,也不会记一次警告;一旦 /stop 正在等待,探测直接跳过。同一个 PR 还把 jiter 解析器在损坏的 SSE 块上抛出的 ValueError(“EOF while parsing…“这类)重新归类为暂时性 provider 错误去重试,而不是当成本地 bug 结束回合。
症状 B:错误是在流里面来的,HTTP 状态是 200,所以分类器把它当成“未知/可重试”,该失败转移的时候在重试。
修复 B(PR #121547):流内 SSE 错误对象里的数字 code(例如 403)现在会被当作 HTTP 状态读取——只有 400–599 的整数才算数,所以 {code: 200} 和符号型 code 不会误判;上游封禁于是被正确分类成鉴权错误(不重试)而不是“暂时不可用”。同时,没有状态码的模板渲染错误(比如 LM Studio 的 Jinja 报错)归为 format_error,让回合走失败转移而不是直接死掉;辅助客户端也开始在没有状态码的流式结构化错误上回退到下一个 provider。
六、重复守卫现在对所有结束路径生效
症状:模型陷入循环,吐了大约 35 万个字符的重复内容,然后正常地结束了——于是这个循环被当成答案完整交付给你。
机制:is_repetition_dominated 的窗口计数在循环周期和窗口对不齐时几乎抓不到东西;而且它只在 finish_reason=length 这条路径上跑。
修复(PR #121600):在原有的窗口计数扫描之外,或上一个周期性重复检测器,带计数器、带噪声、交错的循环现在都能识别。表格、编号列表、CSV 这类“内容本来就该有重复行”的不会被误判。性能上还是线性的:50 万字符的最坏情况 0.16 秒(原来 0.26 秒)。停止路径只在回复至少 16,000 字符且看起来像失控循环时才中止(STOP_PATH_MIN_CHARS = 16_000),所以你要求的重复(“Hello world…” 打 50 遍、模板化 YAML、代码里重复的日志行)照常交付,失败原因会被打上标记。
同一批还堵了一个更隐蔽的洞:被丢弃的流里重建出来的工具参数,现在也要过同一个守卫——退化的模型输出以前可能被当终端命令执行,现在会被拒绝。
七、模型把思考写在正文里时,两件事都要对
思考标签的别名(PR #121659):MiniMax-M3 把推理包在中文标签里(思考、反思、推理、推敲)。THINK_TAG_NAMES 只认识英文的,于是推理文字直接出现在回复正文里。现在这四个标签进了统一列表,流式清洗器、CLI 与 gateway 过滤器、最终响应的 strip_think_blocks 都从这一份列表构建。同一个 PR 还修了一个“半截评论被吃掉”的问题:给聊天平台的中途点评在工具调用边界被切断时,以前会因为前缀匹配被判定为“已经流式发过”而丢掉最后一段;现在最后一段会正常发出。
行内推理送进实时推理面板(PR #121770):对把推理写在 <think> 块里的模型,桌面端的推理面板以前是空的,reasoning_content 也一直是空。现在清洗器会把剥掉的文本暴露出来,作为推理增量转发——但只在同一个请求里 provider 没有自己推过原生推理时才发,所以推理不会显示两遍。最终字段方面,如果整个请求里没有任何推理增量到达,就用既有的 extract_reasoning 从原始内容里补 reasoning_content,而且只读当前这次响应,所以一次 API 调用的推理不会漏进下一次。
八、Codex 与 Responses 通道的看门狗也补齐了
修复(PR #121542):三件事。Codex app-server 的进度通知以前只往界面推,不刷新回合存活计时,于是一个健康的 Codex 长回合会被 600 秒的存活看门狗杀掉——现在非空的文本/推理/输出增量以及工具与消息项的起止都会刷新活动时间,空的增量和 keepalive 不算。xAI 等其他托管 codex_responses 通道现在也拿到 openai-codex 早就有的大上下文陈旧/TTFB 让步参数(90K token 左右被误杀的请求会好起来)。cron 的“达到最大迭代数”总结调用以前直接调 _run_codex_stream,一个开着却不出数据的流永远不会被判陈旧,cron 任务就那样挂着——现在它和其他调用一样受可中断看门狗约束。
这些修复现在的发布状态
必须说清楚:这一批 PR 在 2026 年 9 月 24 日下午合入 main(约 UTC 16:56 到 17:23),而 v0.21.5 的 tag(v2026.9.24)是当天上午 UTC 10:09 发布的。所以它们不在 v0.21.5 里,目前只在 main 上。想拿到需要走 git 安装并跟进 main,或者等下一个 tag。
这一点值得单独提醒,是因为“哪天修好的”和“从哪个版本能拿到”是两件事——尤其在这个项目上,补丁 tag 是给下游分发用的,合并时间和 tag 时间经常只差几个小时。
你可以做的自查
- 如果你在同一个会话里反复看到同一条回复出现两遍,先看它是不是发生在“流式过程中切换会话”之后——这正是 PR #121602 修的那一类。
- 如果你经常在 429 之后丢失已经读到的内容,这条修复(#121628)对你的价值最大。
- 如果你的某个 provider 总是返回没有信息量的 5xx,可以在拿到新版本后重试同一个请求:现在你应该能看到它真正的 4xx 报错。
- 如果你的模型是 MiniMax-M3 且推理跑到正文里,检查升级后回复正文是否干净。
相关的既存机制,站内还有两篇可以对着看:重复回复的投递台账 讲的是“同一条回复被投递两次”,上下文用量表的口径 讲的是表上的数字到底代表什么。这一批修复的窗口归属,见 v0.21.5 发版页 与 v0.21.5 窗口自查指南。
小结
十个修复有一个共同的主题:屏幕上已经出现过的东西,收尾逻辑必须承认它发生过。流式投递比看起来难的地方不在“把字打出来”,而在断线、重试、打断、切换这四种收尾路径上,每一处的处理方式都不太一样。这一批把它们对齐了。