Viste salir la respuesta en streaming y luego desapareció: 10 bugs de entrega que Hermes arregló en un día
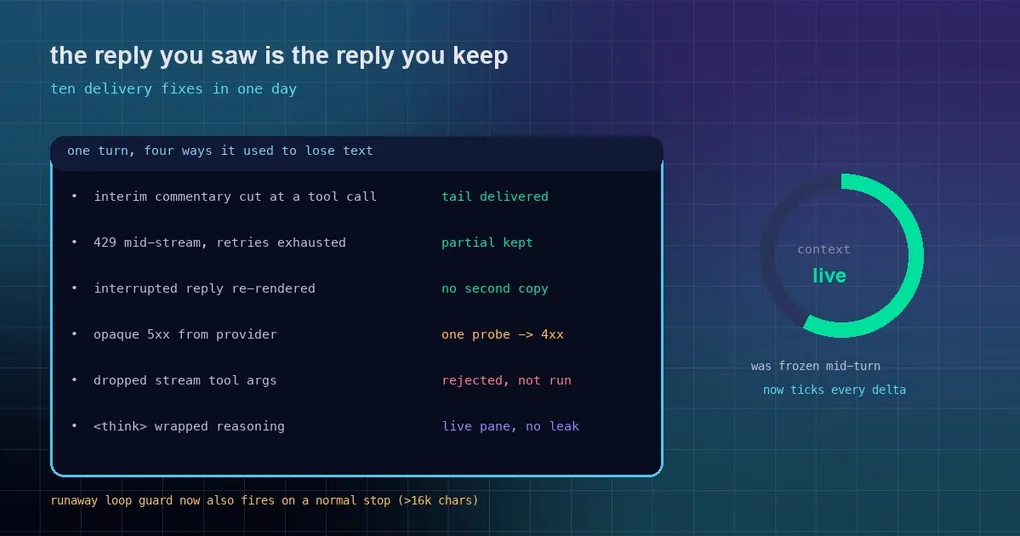
Estás viendo cómo la respuesta sale en streaming palabra a palabra, y de pronto se para. Unos segundos después arranca de nuevo con otras palabras, y la mitad que ya leíste ha desaparecido. Hay una versión todavía más irritante: cambias a otra session un segundo, vuelves, y la misma respuesta aparece dos veces, una copia congelada y otra que sigue creciendo. Y una tercera: el medidor de contexto de la esquina no se mueve en todo el turno, así que no tienes ni idea de lo cerca que estás del límite.
Nada de eso es el modelo volviéndose más tonto. Es la capa de entrega: el texto llegó a tu pantalla, pero la lógica de cierre decidió que no contaba. El 24 de septiembre de 2026, Hermes fusionó una serie de arreglos para exactamente esta clase de fallos: diez PR de la mañana a la noche. Aquí están, en el orden en que es probable que te los encuentres.
1. Una respuesta parcial ya entregada no debería retirarse
Síntoma: un stream recibe un 429 o un error de red, se agotan los reintentos y la parte que ya habías visto desaparece con el fallo. El historial queda con fragmentos que parecen mensajes huérfanos.
Mecanismo: cuando se agotaban los reintentos, el constructor de error final montaba la respuesta de error sin tener en cuenta lo que ya se había entregado en el stream.
Arreglo (PR #121628): settle_delivered_partial ahora se ejecuta una vez antes de cada uno de los dos constructores de error finales, de modo que el texto entregado se conserva en la respuesta de error, mientras que collapse_continuation_trail fusiona los fragmentos de intentos anteriores en un solo mensaje (solo mira los mensajes posteriores al mensaje de usuario actual, y no hace nada cuando no hay un índice de turno válido). La misma tanda cubre la otra mitad: cuando un plugin transform_llm_output reescribe la respuesta final, la burbuja del stream ahora muestra el texto reescrito, coincidiendo con lo que se guarda en state.db; antes la burbuja conservaba el texto previo a la reescritura hasta refrescar.
2. Una respuesta interrumpida no debería renderizarse una segunda vez
Síntoma (CLI clásica): interrumpes a mitad de respuesta, o la respuesta pasa a una llamada de herramienta, y el texto que ya viste pasar en streaming se imprime otra vez como un único Panel de golpe.
Mecanismo: la transición a una llamada de herramienta reiniciaba el estado del stream, y «cuánto de la respuesta final de este turno ya se había emitido en streaming» no sobrevivía al reinicio.
Arreglo (PR #121601): _streamed_text_this_turn registra el texto que realmente se emitió en streaming. Sobrevive a _reset_stream_state y se reinicia una vez por turno de usuario; el Panel se suprime solo cuando el turno se interrumpió de verdad y la respuesta final está contenida en ese texto emitido (ignorando los espacios en blanco). Los mensajes de estado que nunca pasaron por el stream («Operation interrupted: waiting for model response», avisos de reintento/backoff) siguen mostrando su Panel.
El mismo PR arregla dos quejas antiguas relacionadas: con show_reasoning: true, las respuestas de modelos de razonamiento con campo separado ahora se emiten en streaming en lugar de volcarse en un bloque al final del turno (el cuadro de razonamiento se cierra en el primer token de contenido), y la salida estándar canalizada y sin TTY ahora usa buffer por líneas: el buffer por bloques de Python hacía que las ejecuciones headless parecieran colgadas durante minutos.
3. El transcript del escritorio deja de desviarse, y cambiar de session a mitad de stream deja de duplicar una respuesta
Síntoma: estás abajo del todo en una respuesta que va creciendo, la vista se desplaza hacia arriba según llega contenido y vuelve de golpe en la siguiente actualización de scroll; o te vas a otra cosa y vuelves a mitad de stream y la misma respuesta aparece dos veces.
Mecanismo: lo primero era crecimiento sin anclaje durante el streaming. Lo segundo era que la activación reconstruía el transcript a partir de la respuesta parcial confirmada y a la vez mantenía la fila local en vivo.
Arreglo (PR #121602): un ResizeObserver mantiene anclado al lector que está fijado abajo a medida que crece el contenido emitido en streaming (se omite mientras hay una edición inline abierta; la comprobación de fondo se hace vía threadScrollStateFromMetrics, y las métricas vienen de un readThreadScrollResizeMetrics() compartido con el elemento de holgura leído mediante un ref, así que no hay recorrido del DOM en cada evento de scroll). Para el duplicado: un volcado que aún está en streaming se pliega sobre la respuesta parcial confirmada del mismo turno, y el plegado solo ocurre cuando esa parcial se confirmó realmente durante este turno (ambas marcas de tiempo presentes y la parcial no anterior al inicio del turno).
4. El medidor de contexto debería moverse durante el turno
Síntoma: durante un turno, el medidor de uso de contexto se queda congelado en el valor de inicio del turno y solo salta al terminar; después del turno, a veces retrocede al desglose del turno anterior.
Mecanismo: mientras el agent estaba ocupado, el medidor prefería la instantánea de /context en reposo tomada antes del turno, así que los ticks session.usage emitidos por el stream nunca le llegaban; después, un refresco en reposo fallido o lento podía restaurar la instantánea previa al turno.
Arreglo (PR #121638): mientras está ocupado, el medidor usa el $currentUsage en vivo del stream; la instantánea en reposo se invalida cuando arranca un turno, y la decisión de «¿está obsoleta esta instantánea?» vive en un solo sitio (use-context-breakdown), que devuelve un desglose solo cuando no está ocupado y para la misma session, de modo que ContextUsagePanel tampoco puede pintar las categorías previas al turno en el primer render ocupado. Esto cubre la mitad del medidor congelado de #70871; la mitad del cuelgue por estar ocupado en TUI/escritorio queda fuera de alcance.
5. Sondear un 5xx opaco una vez, y clasificar los errores dentro del stream que no traen estado
Síntoma A: un provider responde a tu petición en streaming con un 500/502/503 pelado y nada más, mientras que la misma petición sin streaming devuelve un 4xx con un mensaje útil. Tú solo ves el 5xx inservible.
Arreglo A (PR #121541): ante un 5xx en streaming, _StreamingCall hace una sonda sin streaming con los mismos kwargs, como máximo una vez por ventana de 60 segundos (time.monotonic()). Si devuelve un 4xx, ese error se lanza en el sitio; si tiene éxito, la respuesta se reproduce a través de un _replay_final_response puro. La session no cambia a modo sin streaming y no se fija ningún estado. La sonda suspende el watchdog de stream obsoleto (_stream_stale_timeout = inf en try/finally) para que no la maten por obsolescencia ni cuente como strike, y se omite cuando hay un /stop pendiente. El mismo PR reclasifica el ValueError del parser jiter ante un fragmento SSE corrupto («EOF while parsing…») como error transitorio del provider que conviene reintentar, en lugar de un bug local que termina el turno.
Síntoma B: el error llega dentro del stream con HTTP 200, así que el clasificador lo trata como desconocido/reintentable y reintenta donde debería conmutar a otro provider.
Arreglo B (PR #121547): el code numérico de un objeto de error SSE dentro del stream (por ejemplo 403) ahora se lee como el estado HTTP —solo cuentan los enteros 400–599, así que {code: 200} y los códigos simbólicos quedan fuera—, y un baneo del upstream se clasifica como auth (sin reintento) en lugar de «temporalmente no disponible». Los errores de renderizado de plantilla sin estado (los fallos de Jinja de LM Studio, por ejemplo) pasan a ser format_error, así que el turno conmuta a otro provider en lugar de morir, y el cliente auxiliar ahora también cae al siguiente provider ante errores estructurados de stream sin estado.
6. El guardián de repeticiones ahora se dispara en todas las rutas de finalización
Síntoma: el modelo entra en bucle, emite unos 350.000 caracteres de repetición y luego termina con normalidad, así que el bucle te llega como respuesta.
Mecanismo: el conteo por ventanas de is_repetition_dominated se perdía casi todos los bucles reales cuando el periodo del bucle no encajaba con la ventana, y solo se ejecutaba en la ruta finish_reason=length.
Arreglo (PR #121600): un detector de secuencias periódicas se combina con OR con el escaneo por ventanas existente, así que los bucles con contadores, ruido o intercalado también se marcan. El contenido con filas distintas (tablas, listas numeradas, CSV) sigue sin marcarse. Sigue siendo lineal: un peor caso de 500.000 caracteres tarda 0,16 s frente a los 0,26 s de main. La ruta de parada solo aborta cuando la respuesta tiene al menos 16.000 caracteres (STOP_PATH_MIN_CHARS = 16_000) y parece un bucle descontrolado, así que la repetición que tú has pedido («Hello world…» cincuenta veces, YAML con plantillas, líneas de log repetidas en un bloque de código) se sigue entregando, con el motivo del fallo marcado.
La misma tanda cierra un agujero peor: los argumentos de herramientas reconstruidos a partir de un stream caído ahora pasan por el mismo guardián: la salida degenerada del modelo que antes podía ejecutarse como comando de terminal ahora se rechaza.
7. Cuando el modelo escribe su razonamiento inline, las dos mitades tienen que estar bien
Alias de tags (PR #121659): MiniMax-M3 envuelve su razonamiento en nombres de tag en chino (思考, 反思, 推理, 推敲). THINK_TAG_NAMES solo conocía los ingleses, así que el texto de razonamiento aparecía en la respuesta. Los cuatro están ahora en la lista compartida a partir de la cual se construyen el scrubber del streaming, los filtros de CLI y gateway, y el strip_think_blocks final. El mismo PR arregla un problema de cola truncada: el comentario provisional cortado en un límite de llamada de herramienta se marcaba como «ya emitido» por coincidencia de prefijo, y se perdía el último fragmento; ahora sí se entrega.
Razonamiento inline en el panel en vivo (PR #121770): con los modelos que meten el razonamiento dentro de bloques <think>, el panel de razonamiento del escritorio se quedaba vacío y reasoning_content en blanco. Ahora el scrubber expone el texto que ha eliminado y se reenvía como delta de razonamiento, solo cuando el provider no ha emitido razonamiento nativo en la misma petición, así que el razonamiento nunca se muestra dos veces. En cuanto al campo final, cuando no llega ningún delta de razonamiento, _finish_chat_stream rellena reasoning_content a partir del contenido en bruto con el extract_reasoning existente, leyendo únicamente la respuesta actual para que el razonamiento de una llamada a la API no se filtre a la siguiente.
8. Los watchdogs de Codex y Responses reciben el mismo trato
Arreglo (PR #121542): tres cosas. Las notificaciones de progreso del app-server de Codex se emitían en streaming a la interfaz pero nunca refrescaban la vitalidad del turno, así que un turno de Codex largo y sano moría a manos del watchdog de vitalidad de 600 s; ahora los deltas de texto/razonamiento/salida no vacíos y el inicio y cierre de elementos de herramienta o mensaje refrescan la actividad, mientras que los deltas vacíos y los keepalives se ignoran. Los transportes alojados codex_responses de xAI y otros ahora reciben las adaptaciones de stale/TTFB para contexto grande que openai-codex ya tenía, que es lo que estaba matando peticiones sanas de ~90K tokens en xAI Responses. Y el resumen de máximo de iteraciones de cron, que llamaba directamente a _run_codex_stream, ahora queda acotado por el mismo watchdog interrumpible que el resto de llamadas: antes, un stream abierto que nunca producía datos no moría nunca por obsolescencia, así que el trabajo de cron simplemente se colgaba.
Estado del release: conviene ser preciso
Estos PR se fusionaron en main la tarde del 24 de septiembre de 2026 (aproximadamente 16:56–17:23 UTC), mientras que el tag v0.21.5 (v2026.9.24) se publicó esa mañana a las 10:09 UTC. Por tanto, no están en la v0.21.5; viven solo en main. Para tenerlos hace falta una instalación por git que siga main, o esperar al siguiente tag.
Esa distinción merece decirse aparte, porque «cuándo se arregló» y «en qué versión puedo conseguirlo» son preguntas distintas, y en este proyecto suelen diferir por solo unas horas, ya que los tags de patch existen para la distribución posterior y no para anunciar funciones.
Qué comprobar en tu propia instalación
- Si has visto la misma respuesta aparecer dos veces en una session, comprueba si ocurrió justo después de cambiar de session a mitad de stream: ese es el caso de #121602.
- Si pierdes habitualmente texto que ya habías leído después de un 429, #121628 es el que más te importa.
- Si un provider te responde una y otra vez con un 5xx sin información, reintenta la misma petición en una build más nueva: ahora deberías ver su error 4xx real.
- Si tu modelo es MiniMax-M3 y el razonamiento se filtra al cuerpo de la respuesta, comprueba que el cuerpo queda limpio después de actualizar.
Para los mecanismos vecinos, merece la pena leer dos artículos ya publicados en paralelo: el ledger de entrega de respuestas duplicadas cubre una respuesta entregada dos veces, y la guía del ancla de uso de contexto explica qué significan de verdad los números de ese medidor. Para ver dónde cae esta ventana en un release, consulta la página del release v0.21.5 y la guía de autocomprobación de la ventana v0.21.5.
La versión corta
Diez arreglos, un solo tema: todo lo que ya ha aparecido en pantalla tiene que ser reconocido por la lógica de cierre. La entrega en streaming es difícil justo donde no lo parece: no en imprimir los caracteres, sino en las cuatro formas en que puede terminar un turno (desconexión, reintento, interrupción, cambio de session), cada una de las cuales trataba el texto entregado de forma distinta. Esta tanda las alinea.