Vous avez vu la réponse arriver en streaming — puis elle a disparu : 10 bugs de livraison corrigés par Hermes en une journée
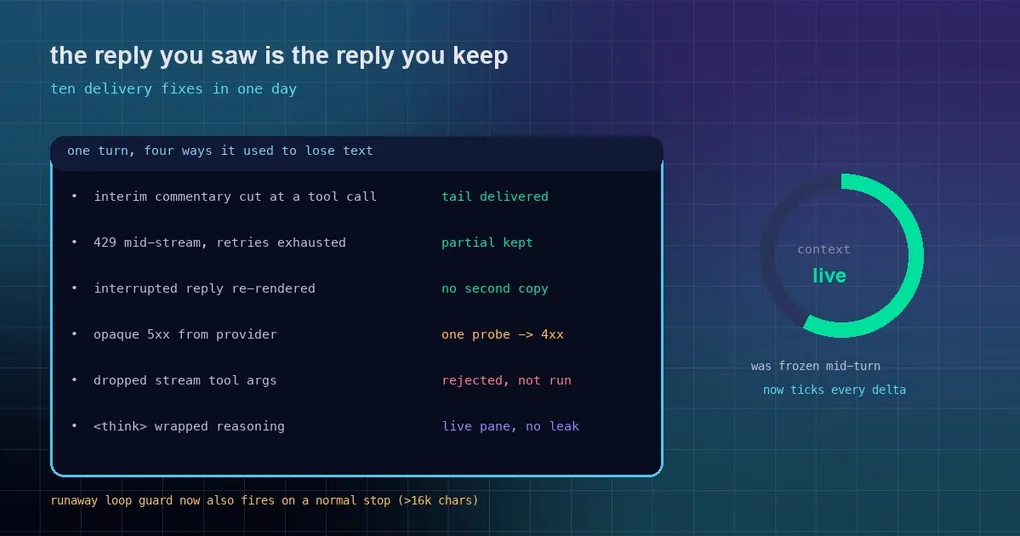
Vous regardez une réponse arriver mot par mot, et puis elle s’arrête. Quelques secondes plus tard elle reprend avec une formulation différente — et la moitié que vous veniez de lire a disparu. Il existe une version plus irritante : vous passez une seconde sur une autre session, vous revenez, et la même réponse apparaît deux fois, une copie figée et une qui grossit encore. Et une troisième : la jauge de contexte dans le coin ne bouge jamais pendant un tour, donc vous ignorez à quel point vous êtes près de la limite.
Rien de tout cela n’est le modèle qui devient plus bête. C’est la couche de livraison : le texte a atteint votre écran, mais la logique de finalisation a décidé qu’il ne comptait pas. Le 24 septembre 2026, Hermes a fusionné une série de correctifs pour exactement cette classe de problèmes — dix PR du matin au soir. Les voici dans l’ordre où vous avez le plus de chances de les rencontrer.
1. Une réponse partielle déjà livrée ne doit pas être reprise
Symptôme : un stream tombe sur un 429 ou une erreur réseau, les retries s’épuisent, et la partie que vous aviez déjà vue disparaît avec l’échec. L’historique reste avec des fragments qui ressemblent à des messages orphelins.
Mécanisme : quand les retries étaient épuisés, le constructeur d’erreur final construisait la réponse d’erreur sans tenir compte de ce qui avait déjà été livré dans le stream.
Correctif (PR #121628) : settle_delivered_partial s’exécute désormais une fois avant chacun des deux constructeurs d’erreur finaux, donc le texte livré est conservé dans la réponse d’erreur, tandis que collapse_continuation_trail fusionne les fragments des tentatives précédentes en un seul message (il ne regarde que les messages postérieurs au message utilisateur courant, et ne fait rien quand il n’y a pas d’index de tour valide). Le même lot traite l’autre moitié : quand un plugin transform_llm_output réécrit la réponse finale, la bulle streamée affiche désormais le texte réécrit, en accord avec ce qui est stocké dans state.db — auparavant la bulle gardait le texte d’avant réécriture jusqu’à un rafraîchissement.
2. Une réponse interrompue ne doit pas être rendue une seconde fois
Symptôme (CLI classique) : vous intervenez au milieu de la réponse, ou la réponse enchaîne sur un appel d’outil, et du texte que vous avez vu arriver en streaming est imprimé à nouveau dans un seul Panel massif.
Mécanisme : une transition vers un appel d’outil réinitialisait l’état du stream, et « quelle part de la réponse finale de ce tour a déjà été streamée » ne survivait pas à la réinitialisation.
Correctif (PR #121601) : _streamed_text_this_turn enregistre le texte qui a réellement été streamé. Il survit à _reset_stream_state et est réinitialisé une fois par tour utilisateur ; le Panel n’est supprimé que lorsque le tour a vraiment été interrompu et que la réponse finale est contenue dans ce texte streamé (espaces ignorés). Les messages de statut qui n’ont jamais été streamés — « Operation interrupted: waiting for model response », les avis de retry/backoff — obtiennent toujours leur Panel.
La même PR corrige deux plaintes connexes de longue date : avec show_reasoning: true, les réponses des modèles à raisonnement en champ séparé sont désormais streamées au lieu d’être déversées en un bloc à la fin du tour (la boîte de raisonnement se ferme au premier token de contenu), et la sortie pipée sans TTY est maintenant bufferisée ligne par ligne — le buffering par blocs de Python faisait auparavant passer les exécutions headless pour un blocage de plusieurs minutes.
3. La transcription du desktop cesse de dériver, et changer de session en plein stream cesse de dupliquer une réponse
Symptôme : vous êtes en bas d’une réponse qui grandit, la vue dérive vers le haut à mesure que le contenu arrive et se replace d’un coup à la mise à jour de scroll suivante ; ou vous changez de session en plein stream et la même réponse apparaît deux fois.
Mécanisme : le premier cas était une croissance non épinglée pendant le streaming. Le second était l’activation qui reconstruisait la transcription à partir du partiel commité tout en conservant la ligne live locale.
Correctif (PR #121602) : un ResizeObserver maintient un lecteur épinglé en bas pendant que le contenu streamé grandit (ignoré quand une édition en ligne est ouverte, contrôle du bas via threadScrollStateFromMetrics, métriques issues d’un readThreadScrollResizeMetrics() partagé avec l’élément de dégagement lu via une ref, donc aucun parcours du DOM à chaque événement de scroll). Pour le doublon : un dump encore en cours de streaming se replie dans le partiel commité du même tour, et ce repli n’a lieu que si ce partiel a réellement été commité pendant ce tour (les deux timestamps présents et le partiel pas plus ancien que le début du tour).
4. La jauge de contexte doit bouger pendant un tour
Symptôme : pendant un tour, la jauge d’utilisation du contexte reste figée à la valeur du début de tour et ne saute qu’à la fin ; après le tour, elle retombe parfois sur la répartition du tour précédent.
Mécanisme : pendant que l’agent était occupé, la jauge préférait le snapshot /context pris au repos avant le tour, donc les ticks session.usage streamés ne l’atteignaient jamais ; ensuite, un rafraîchissement au repos échoué ou lent pouvait restaurer le snapshot d’avant tour.
Correctif (PR #121638) : pendant l’occupation, la jauge utilise le $currentUsage streamé en direct ; le snapshot au repos est invalidé quand un tour démarre, et la décision « ce snapshot est-il périmé » vit à un seul endroit (use-context-breakdown), qui ne renvoie une répartition que hors occupation et pour la même session — donc ContextUsagePanel ne peut pas non plus peindre les catégories d’avant tour au premier rendu occupé. Cela couvre la moitié « jauge figée » de #70871 ; la moitié « blocage en occupation » du TUI/desktop est hors périmètre.
5. Sonder une fois un 5xx opaque, et classer les erreurs en plein stream sans statut
Symptôme A : un provider répond à votre requête en streaming par un 500/502/503 nu et rien d’autre, alors que la même requête en non-streaming renvoie un 4xx avec un message exploitable. Vous ne voyez jamais que l’inutile 5xx.
Correctif A (PR #121541) : sur un 5xx en streaming, _StreamingCall effectue une sonde non-streaming avec les mêmes kwargs, au plus une fois par fenêtre de 60 secondes (time.monotonic()). Si elle renvoie un 4xx, cette erreur est levée à la place ; si elle réussit, la réponse est rejouée via un _replay_final_response pur. La session n’est pas basculée en non-streaming et rien n’est verrouillé. La sonde suspend le watchdog d’inactivité du stream (_stream_stale_timeout = inf en try/finally) pour ne pas être tuée comme périmée ni comptée comme un strike, et elle est ignorée dès qu’un /stop est en attente. La même PR reclasse le ValueError de l’analyseur jiter sur un chunk SSE corrompu (« EOF while parsing… ») comme une erreur de provider transitoire à retenter, au lieu d’un bug local qui met fin au tour.
Symptôme B : l’erreur arrive à l’intérieur du stream avec un HTTP 200, donc le classifieur la traite comme inconnue/retryable et retente là où il devrait basculer sur un autre provider.
Correctif B (PR #121547) : le code numérique d’un objet d’erreur SSE en plein stream (par exemple 403) est désormais lu comme le statut HTTP — seuls les entiers 400–599 comptent, donc {code: 200} et les codes symboliques restent exclus — et un bannissement en amont est classé comme auth (pas de retry) plutôt que « temporairement indisponible ». Les erreurs de rendu de template sans statut (les échecs Jinja de LM Studio, par exemple) deviennent format_error, donc le tour bascule sur un autre provider au lieu de mourir, et le client auxiliaire retombe désormais aussi sur le provider suivant en cas d’erreur de stream structurée sans statut.
6. Le garde-fou anti-répétition se déclenche désormais sur tous les chemins de fin
Symptôme : le modèle part en boucle, émet environ 350 000 caractères de répétition, puis s’arrête normalement — donc la boucle vous est livrée comme la réponse.
Mécanisme : le comptage par fenêtre de is_repetition_dominated manquait presque toutes les vraies boucles quand la période de la boucle ne s’alignait pas sur la fenêtre, et il ne s’exécutait que sur le chemin finish_reason=length.
Correctif (PR #121600) : un détecteur de runs périodiques est combiné par OR avec le balayage par comptage de fenêtres existant, donc les boucles avec compteurs, bruit ou entrelacement sont signalées. Le contenu à lignes distinctes (tableaux, listes numérotées, CSV) n’est toujours pas signalé. Cela reste linéaire : un pire cas de 500 k caractères prend 0,16 s contre 0,26 s sur main. Le chemin d’arrêt n’abandonne que si la réponse fait au moins 16 000 caractères (STOP_PATH_MIN_CHARS = 16_000) et ressemble à une boucle emballée, donc la répétition que vous avez demandée (« Hello world… » cinquante fois, du YAML templaté, des lignes de log répétées dans un bloc de code) est toujours livrée, avec la raison de l’échec estampillée.
Le même lot ferme un trou plus vilain : les arguments d’outil reconstruits depuis un stream abandonné passent désormais par le même garde-fou — une sortie de modèle dégénérée qui pouvait auparavant être exécutée comme commande de terminal est maintenant rejetée.
7. Quand le modèle écrit son raisonnement en ligne, les deux moitiés doivent être correctes
Alias de tags (PR #121659) : MiniMax-M3 emballe son raisonnement dans des noms de tags chinois (思考, 反思, 推理, 推敲). THINK_TAG_NAMES ne connaissait que les anglais, donc le texte de raisonnement apparaissait dans la réponse. Les quatre sont désormais dans la liste partagée à partir de laquelle le scrubber de streaming, les filtres du CLI et du gateway, et le strip_think_blocks final sont tous construits. La même PR corrige un problème de queue tronquée : un commentaire intermédiaire coupé à une frontière d’appel d’outil était marqué « déjà streamé » sur une correspondance de préfixe, ce qui faisait perdre le dernier chunk ; il est désormais livré.
Raisonnement en ligne vers le volet live (PR #121770) : pour les modèles qui placent leur raisonnement dans des blocs <think>, le volet de raisonnement du desktop restait vide et reasoning_content était vide. Le scrubber expose désormais le texte qu’il a retiré, et celui-ci est transmis comme delta de raisonnement — uniquement quand le provider n’a pas déjà streamé de raisonnement natif dans la même requête, pour que le raisonnement ne soit jamais affiché deux fois. Pour le champ final, quand aucun delta de raisonnement n’arrive du tout, _finish_chat_stream remplit reasoning_content depuis le contenu brut avec l’extract_reasoning existant, en ne lisant que la réponse courante pour que le raisonnement d’un appel API ne puisse pas fuiter dans le suivant.
8. Les watchdogs Codex et Responses reçoivent le même traitement
Correctif (PR #121542) : trois choses. Les notifications de progression de Codex app-server étaient streamées vers l’interface mais ne rafraîchissaient jamais la vivacité du tour, donc un long tour Codex sain était tué par le watchdog de vivacité de 600 s — désormais les deltas non vides de texte/raisonnement/output et les start-complete des items outil/message rafraîchissent l’activité, tandis que les deltas vides et les keepalives sont ignorés. Les transports codex_responses de xAI et d’autres hébergeurs reçoivent maintenant les aménagements stale/TTFB grand contexte que openai-codex avait déjà, ce qui tuait des requêtes xAI Responses saines d’environ 90 K tokens. Et le résumé de fin d’itérations max du cron, qui appelait _run_codex_stream directement, est désormais borné par le même watchdog interruptible que tous les autres appels — auparavant, un stream ouvert qui ne produisait jamais de données n’était jamais tué comme périmé, donc le job cron restait simplement bloqué.
État de release — une précision qui vaut la peine
Ces PR ont été fusionnées dans main l’après-midi du 24 septembre 2026 (environ 16:56–17:23 UTC), alors que le tag v0.21.5 (v2026.9.24) a été publié ce matin-là à 10:09 UTC. Elles ne sont donc pas dans v0.21.5 ; elles ne vivent que sur main. Pour les obtenir, il faut une installation git qui suit main, ou attendre le prochain tag.
Cette distinction mérite d’être énoncée en soi, parce que « quand est-ce corrigé » et « à partir de quelle version puis-je l’avoir » sont deux questions différentes — et sur ce projet elles diffèrent régulièrement de quelques heures seulement, les tags correctifs servant à la distribution en aval plutôt qu’aux annonces de fonctionnalités.
Ce qu’il faut vérifier sur votre installation
- Si vous avez vu la même réponse apparaître deux fois dans une session, vérifiez si c’est arrivé juste après un changement de session en plein stream — c’est le cas #121602.
- Si vous perdez régulièrement du texte déjà lu après un 429, #121628 est le correctif qui vous concerne le plus.
- Si un provider continue de répondre par un 5xx peu informatif, retentez la même requête sur un build plus récent : vous devriez maintenant voir sa vraie erreur 4xx à la place.
- Si votre modèle est MiniMax-M3 et que le raisonnement fuit dans le corps de la réponse, vérifiez que le corps est propre après la mise à niveau.
Pour les mécanismes voisins, deux billets existants méritent d’être lus côte à côte : le ledger de livraison anti-doublons traite d’une réponse livrée deux fois, et le guide de l’ancre d’utilisation du contexte explique ce que signifient réellement les chiffres de cette jauge. Pour situer cette fenêtre dans une release, voyez la page de release v0.21.5 et le guide d’auto-vérification de la fenêtre v0.21.5.
En bref
Dix correctifs, un seul thème : tout ce qui est déjà apparu à l’écran doit être pris en compte par la logique de finalisation. La livraison en streaming est difficile là où ça ne se voit pas — pas dans l’impression des caractères, mais dans les quatre façons dont un tour peut se terminer (déconnexion, retry, interruption, changement de session), qui traitaient chacune le texte livré différemment. Ce lot les aligne.