Você viu a resposta sair em streaming — e então ela sumiu: 10 bugs de entrega que o Hermes corrigiu em um dia
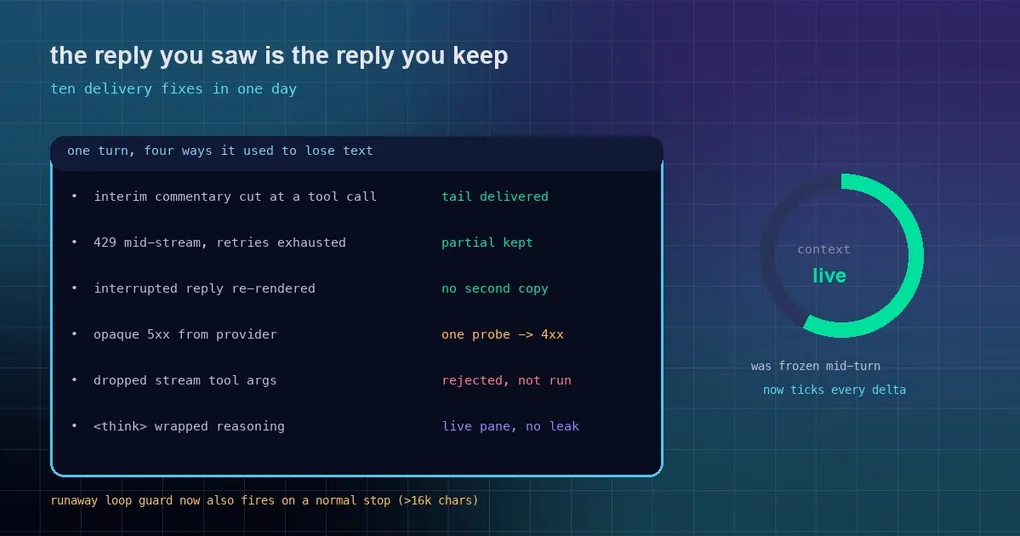
Você está vendo uma resposta sair em streaming, palavra por palavra, e então ela para. Alguns segundos depois ela recomeça com outra redação — e a metade que você já leu sumiu. Existe uma versão mais irritante: você troca para outra sessão por um segundo, volta, e a mesma resposta aparece duas vezes, uma cópia congelada e outra ainda crescendo. E uma terceira: o medidor de contexto no canto não se move durante o turno, então você não faz ideia de quão perto está do limite.
Nada disso é o modelo ficando mais burro. É a camada de entrega: o texto chegou à sua tela, mas a lógica de finalização decidiu que ele não contava. Em 24 de setembro de 2026, o Hermes mesclou uma série de correções exatamente para essa classe de problema — dez PRs da manhã até a noite. Aqui estão elas, na ordem em que você provavelmente vai esbarrar nelas.
1. Uma resposta parcial já entregue não pode ser retirada
Sintoma: um stream bate em um 429 ou em um erro de rede, as tentativas se esgotam, e a parte que você já tinha visto desaparece junto com a falha. O histórico fica com fragmentos que parecem mensagens órfãs.
Mecanismo: quando as tentativas se esgotavam, o construtor de erro final montava a resposta de erro sem levar em conta o que já havia sido entregue no stream.
Correção (PR #121628): settle_delivered_partial agora roda uma vez antes de cada um dos dois construtores de erro finais, então o texto entregue é mantido na resposta de erro, enquanto collapse_continuation_trail mescla fragmentos de tentativas anteriores em uma única mensagem (ele só olha para mensagens depois da mensagem atual do usuário e não faz nada quando não há um índice de turno válido). O mesmo lote resolve a outra metade: quando um plugin transform_llm_output reescreve a resposta final, o balão em streaming agora mostra o texto reescrito, igual ao que está armazenado no state.db — antes o balão mantinha o texto pré-reescrita até um refresh.
2. Uma resposta interrompida não deve ser renderizada uma segunda vez
Sintoma (CLI clássico): você dá uma intervenção no meio da resposta, ou a resposta transita para uma chamada de ferramenta, e o texto que você já viu passar em streaming é impresso de novo como um Panel sólido.
Mecanismo: uma transição para chamada de ferramenta reiniciava o estado do stream, e “quanto da resposta final deste turno já foi streamado” não sobrevivia ao reset.
Correção (PR #121601): _streamed_text_this_turn registra o texto que realmente passou em streaming. Ele sobrevive ao _reset_stream_state e é zerado uma vez por turno do usuário; o Panel é suprimido apenas quando o turno realmente foi interrompido e a resposta final está contida nesse texto streamado (ignorando espaços em branco). Mensagens de status que nunca passaram em streaming — “Operation interrupted: waiting for model response”, avisos de retry/backoff — continuam ganhando o seu Panel.
O mesmo PR corrige duas reclamações antigas relacionadas: com show_reasoning: true, respostas de modelos com reasoning em campo separado agora passam em streaming em vez de serem despejadas em um bloco único no fim do turno (a caixa de reasoning fecha no primeiro token de conteúdo), e stdout redirecionado por pipe, sem TTY, agora tem buffer por linha — o buffering por bloco do Python fazia execuções headless parecerem travadas por minutos.
3. O transcript do desktop para de deslizar, e trocar de sessão no meio do stream para de duplicar a resposta
Sintoma: você fica no fim de uma resposta que cresce, a visão desliza para cima conforme o conteúdo chega e volta com um salto na próxima atualização de scroll; ou você sai e volta no meio do streaming e a mesma resposta aparece duas vezes.
Mecanismo: o primeiro era crescimento sem fixação durante o streaming. O segundo era a ativação reconstruindo o transcript a partir do parcial já confirmado enquanto também mantinha a linha viva local.
Correção (PR #121602): um ResizeObserver mantém fixo quem está acompanhando o fim da conversa conforme o conteúdo streamado cresce (ignorado enquanto uma edição inline está aberta, com a checagem de fim via threadScrollStateFromMetrics, métricas vindas de um readThreadScrollResizeMetrics() compartilhado, com o elemento de clearance lido por ref, de modo que não há varredura do DOM a cada evento de scroll). Para a duplicata: um dump ainda em streaming se dobra no parcial confirmado do mesmo turno, e a dobra só acontece quando aquele parcial realmente foi confirmado neste turno (os dois timestamps presentes e o parcial não mais antigo que o início do turno).
4. O medidor de contexto deve se mexer durante o turno
Sintoma: durante um turno, o medidor de uso de contexto fica congelado no valor do início do turno e só salta na conclusão; depois do turno, às vezes ele volta ao detalhamento do turno anterior.
Mecanismo: enquanto o agent estava ocupado, o medidor preferia o snapshot ocioso de /context tirado antes do turno, então os ticks de session.usage em streaming nunca chegavam até ele; depois, um refresh ocioso falho ou lento podia restaurar o snapshot pré-turno.
Correção (PR #121638): enquanto está ocupado, o medidor usa o $currentUsage em streaming ao vivo; o snapshot ocioso é invalidado quando um turno começa, e a decisão de “este snapshot está obsoleto” mora em um só lugar (use-context-breakdown), que só retorna um detalhamento quando não está ocupado e para a mesma sessão — assim o ContextUsagePanel também não consegue pintar as categorias pré-turno no primeiro render ocupado. Isso cobre a metade do medidor congelado do #70871; a metade de travamento em TUI/desktop durante o turno ocupado fica fora do escopo.
5. Sondar um 5xx opaco uma vez, e classificar erros no stream que não trazem status
Sintoma A: um provider responde sua requisição em streaming com um 500/502/503 seco e nada mais, enquanto a mesma requisição sem streaming devolve um 4xx com uma mensagem acionável. Você só vê o 5xx inútil.
Correção A (PR #121541): em um 5xx de streaming, _StreamingCall faz uma sondagem sem streaming com os mesmos kwargs, no máximo uma vez por janela de 60 segundos (time.monotonic()). Se ela devolver um 4xx, esse erro é levantado na hora; se ela funcionar, a resposta é reproduzida por um _replay_final_response puro. A sessão não é trocada para não-streaming e nada fica travado. A sondagem suspende o watchdog de stream obsoleto (_stream_stale_timeout = inf em try/finally) para não ser morta por obsolescência nem contada como strike, e é ignorada quando há um /stop pendente. O mesmo PR reclassifica o ValueError do parser jiter em um chunk SSE corrompido (“EOF while parsing…”) como um erro transitório do provider a ser retentado, em vez de um bug local que encerra o turno.
Sintoma B: o erro chega dentro do stream com HTTP 200, então o classificador o trata como desconhecido/retentável e retenta onde deveria trocar de provider.
Correção B (PR #121547): o code numérico de um objeto de erro SSE dentro do stream (por exemplo 403) agora é lido como status HTTP — só números inteiros de 400 a 599 contam, então {code: 200} e códigos simbólicos ficam de fora — e um banimento upstream é classificado como auth (sem retry) em vez de “temporariamente indisponível”. Erros de renderização de template sem status (falhas de Jinja do LM Studio, por exemplo) passam a ser format_error, então o turno troca de provider em vez de morrer, e o cliente auxiliar agora também cai para o próximo provider em erros de stream estruturados sem status.
6. A guarda de repetição agora dispara em todos os caminhos de conclusão
Sintoma: o modelo entra em loop, emite cerca de 350.000 caracteres de repetição e então para normalmente — assim o loop chega até você como resposta.
Mecanismo: a contagem por janela do is_repetition_dominated deixava passar quase todo loop real quando o período do loop não batia com a janela, e ela só rodava no caminho de finish_reason=length.
Correção (PR #121600): um detector de execuções periódicas é combinado com OR à varredura por contagem em janela já existente, então loops com contadores, ruído ou intercalação são sinalizados. Conteúdo com linhas distintas (tabelas, listas numeradas, CSV) continua não sendo sinalizado. O custo segue linear: um pior caso de 500 mil caracteres leva 0,16 s contra 0,26 s do main. O caminho de stop só aborta quando a resposta tem pelo menos 16.000 caracteres (STOP_PATH_MIN_CHARS = 16_000) e parece um loop descontrolado, então repetições que você pediu (“Hello world…” cinquenta vezes, YAML com template, linhas de log repetidas em um bloco de código) continuam sendo entregues, com o motivo da falha marcado.
O mesmo lote fecha um buraco mais desagradável: argumentos de ferramenta reconstruídos a partir de um stream descartado agora passam pela mesma guarda — saídas degeneradas do modelo que antes podiam ser executadas como comando de terminal agora são rejeitadas.
7. Quando o modelo escreve o reasoning inline, as duas metades têm de estar certas
Aliases de tag (PR #121659): o MiniMax-M3 envolve o reasoning em nomes de tag em chinês (思考, 反思, 推理, 推敲). O THINK_TAG_NAMES só conhecia os em inglês, então o texto de reasoning aparecia na resposta. Todos os quatro agora estão na lista compartilhada a partir da qual o scrubber de streaming, os filtros da CLI e do gateway e o strip_think_blocks final são construídos. O mesmo PR corrige um problema de cauda truncada: comentários intermediários cortados em uma fronteira de chamada de ferramenta eram marcados como “já streamados” por correspondência de prefixo, descartando o último pedaço; agora eles são entregues.
Reasoning inline no painel ao vivo (PR #121770): para modelos que colocam o reasoning dentro de blocos <think>, o painel de reasoning do desktop ficava vazio e reasoning_content em branco. O scrubber agora expõe o texto que ele removeu e ele é encaminhado como um delta de reasoning — somente quando o provider não streamou reasoning nativo na mesma requisição, para que o reasoning nunca seja mostrado duas vezes. Para o campo final, quando nenhum delta de reasoning chega, o _finish_chat_stream preenche reasoning_content a partir do conteúdo bruto com o extract_reasoning já existente, lendo apenas a resposta atual para que o reasoning de uma chamada de API não vaze para a próxima.
8. Os watchdogs do Codex e do Responses recebem o mesmo tratamento
Correção (PR #121542): três coisas. As notificações de progresso do app-server do Codex passavam em streaming para a UI mas nunca renovavam a liveness do turno, então um turno longo e saudável do Codex era morto pelo watchdog de liveness de 600 s — agora deltas não vazios de texto/reasoning/output e eventos de início-conclusão de itens de ferramenta/mensagem renovam a atividade, enquanto deltas vazios e keepalives são ignorados. Transportes codex_responses da xAI e de outros provedores hospedados agora recebem as acomodações de contexto grande para stale/TTFB que o openai-codex já tinha, e era isso que estava matando requisições saudáveis de ~90K tokens em xAI Responses. E o resumo de max-iteration do cron, que chamava _run_codex_stream diretamente, agora é limitado pelo mesmo watchdog interrompível de todas as outras chamadas — antes, um stream aberto que nunca produzia dados nunca era morto por obsolescência, então o cron job simplesmente travava.
Status da release — vale ser preciso
Esses PRs foram mesclados no main na tarde de 24 de setembro de 2026 (por volta de 16:56–17:23 UTC), enquanto a tag v0.21.5 (v2026.9.24) foi publicada naquela manhã, às 10:09 UTC. Ou seja, eles não estão na v0.21.5; vivem apenas no main. Para obtê-los, é preciso uma instalação via git acompanhando o main, ou esperar a próxima tag.
Vale enunciar essa distinção por si só, porque “quando isso foi corrigido” e “a partir de qual versão eu consigo isso” são perguntas diferentes — e neste projeto elas costumam diferir por apenas algumas horas, já que as tags de patch existem para distribuição downstream e não para anúncio de funcionalidades.
O que checar na sua própria instalação
- Se você já viu a mesma resposta aparecer duas vezes em uma sessão, veja se aconteceu logo depois de trocar de sessão no meio do stream — é o caso do #121602.
- Se você costuma perder texto que já tinha lido depois de um 429, o #121628 é o que mais importa para você.
- Se um provider insiste em responder com um 5xx sem informação, repita a mesma requisição em um build mais novo: você deve ver agora o erro 4xx real dele.
- Se o seu modelo é o MiniMax-M3 e o reasoning vaza para o corpo da resposta, verifique se o corpo está limpo depois de atualizar.
Para os mecanismos vizinhos, vale ler dois posts já publicados lado a lado: o delivery ledger de respostas duplicadas cobre uma resposta entregue duas vezes, e o guia da âncora de uso de contexto explica o que os números daquele medidor realmente significam. Para saber onde essa janela se encaixa em uma release, veja a página da release v0.21.5 e o guia de autoverificação da janela v0.21.5.
A versão curta
Dez correções, um tema: qualquer coisa que já apareceu na tela precisa ser reconhecida pela lógica de finalização. Entrega em streaming é difícil num lugar que não parece difícil — não em imprimir os caracteres, mas nas quatro formas como um turno pode terminar (desconexão, retry, interrupção, troca de sessão), cada uma das quais antes tratava o texto entregue de um jeito diferente. Este lote as alinha.