Sie haben die Antwort streamen sehen — dann war sie weg: 10 Zustellungs-Bugs, die Hermes an einem Tag gefixt hat
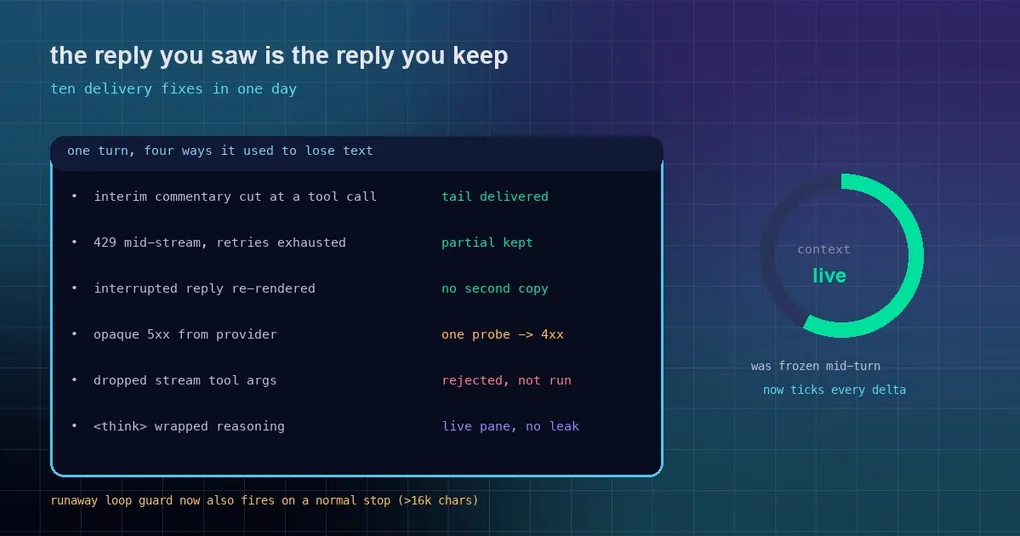
Sie sehen zu, wie eine Antwort Wort für Wort herausstreamt, und dann stoppt sie. Ein paar Sekunden später beginnt sie mit anderer Formulierung neu — und die Hälfte, die Sie schon gelesen haben, ist weg. Es gibt eine noch ärgerlichere Variante: Sie wechseln kurz in eine andere Session und wieder zurück, und dieselbe Antwort erscheint zweimal, eine eingefrorene Kopie und eine, die noch weiterwächst. Und eine dritte: Die Context-Anzeige in der Ecke bewegt sich während eines Turns nie, Sie haben also keine Ahnung, wie nah Sie am Limit sind.
Nichts davon bedeutet, dass das Modell dümmer wird. Es ist die Zustellungsschicht: Der Text hat Ihren Bildschirm erreicht, aber die Abschlusslogik hat entschieden, dass er nicht zählt. Am 24. September 2026 hat Hermes eine Serie von Fixes genau für diese Klasse gemergt — zehn PRs von morgens bis abends. Hier sind sie, in der Reihenfolge, in der Sie sie wahrscheinlich treffen.
1. Eine bereits zugestellte Teilantwort sollte nicht zurückgenommen werden
Symptom: Ein Stream trifft auf einen 429 oder einen Netzwerkfehler, die Retries sind erschöpft, und der Teil, den Sie bereits gesehen haben, verschwindet mit dem Fehler. In der Historie bleiben Fragmente zurück, die wie verwaiste Nachrichten aussehen.
Mechanismus: Als die Retries erschöpft waren, baute der finale Fehler-Builder die Fehlerantwort, ohne zu berücksichtigen, was bereits in den Stream zugestellt worden war.
Fix (PR #121628): settle_delivered_partial läuft jetzt einmal vor jedem der beiden finalen Fehler-Builder, sodass der zugestellte Text in der Fehlerantwort erhalten bleibt, während collapse_continuation_trail Fragmente früherer Versuche zu einer Nachricht zusammenführt (es betrachtet nur Nachrichten nach der aktuellen User-Nachricht und tut nichts, wenn kein gültiger Turn-Index existiert). Derselbe Batch erledigt die andere Hälfte: Wenn ein transform_llm_output-Plugin die finale Antwort umschreibt, zeigt die gestreamte Bubble nun den umgeschriebenen Text, passend zu dem, was in state.db gespeichert ist — zuvor behielt die Bubble den Text vor dem Umschreiben, bis ein Refresh kam.
2. Eine unterbrochene Antwort sollte nicht ein zweites Mal gerendert werden
Symptom (klassisches CLI): Sie werfen mitten in der Antwort etwas ein, oder die Antwort geht in einen Tool-Call über, und Text, den Sie bereits haben streamen sehen, wird erneut als ein massives Panel ausgegeben.
Mechanismus: Ein Tool-Call-Übergang setzte den Stream-State zurück, und „wie viel der finalen Antwort dieses Turns bereits gestreamt wurde“ überlebte den Reset nicht.
Fix (PR #121601): _streamed_text_this_turn hält den Text fest, der tatsächlich gestreamt wurde. Er übersteht _reset_stream_state und wird einmal pro User-Turn zurückgesetzt; das Panel wird nur dann unterdrückt, wenn der Turn wirklich unterbrochen wurde und die finale Antwort in diesem gestreamten Text enthalten ist (Leerraum ignoriert). Statusmeldungen, die nie gestreamt wurden — „Operation interrupted: waiting for model response“, Retry-/Backoff-Hinweise —, bekommen weiterhin ihr Panel.
Derselbe PR behebt zwei verwandte, seit Langem bestehende Beschwerden: Mit show_reasoning: true streamen Antworten von Reasoning-Modellen mit separatem Feld jetzt, statt am Turn-Ende als ein Block ausgegeben zu werden (die Reasoning-Box schließt beim ersten Content-Token), und gepipetes stdout ohne TTY wird jetzt zeilenweise gepuffert — Pythons Block-Pufferung ließ headless-Läufe früher minutenlang wie einen Hänger aussehen.
3. Das Desktop-Transkript driftet nicht mehr, und ein Session-Wechsel mitten im Stream dupliziert keine Antwort mehr
Symptom: Sie sitzen am unteren Ende einer wachsenden Antwort, die Ansicht driftet nach oben, während Inhalte eintreffen, und springt beim nächsten Scroll-Update zurück; oder Sie wechseln mitten im Stream weg und wieder zurück, und dieselbe Antwort erscheint zweimal.
Mechanismus: Das erste war ungepinntes Wachstum während des Streamings. Das zweite war die Aktivierung, die das Transkript aus dem committeten Partial neu aufbaute und gleichzeitig die lokale Live-Zeile behielt.
Fix (PR #121602): Ein ResizeObserver hält einen unten gepinnten Leser gepinnt, während gestreamter Inhalt wächst (übersprungen, solange eine Inline-Bearbeitung offen ist, Bottom-Check über threadScrollStateFromMetrics, Metriken aus einem gemeinsamen readThreadScrollResizeMetrics() mit dem Clearance-Element, das über eine Ref gelesen wird, also kein DOM-Walk pro Scroll-Event). Zum Duplikat: Ein noch streamender Dump faltet sich in den committeten Partial desselben Turns, und die Faltung findet nur statt, wenn dieser Partial wirklich während dieses Turns committet wurde (beide Timestamps vorhanden und der Partial nicht älter als der Turn-Start).
4. Die Context-Anzeige sollte sich während eines Turns bewegen
Symptom: Während eines Turns bleibt die Anzeige der Context-Auslastung auf dem Wert vom Turn-Start eingefroren und springt erst bei Abschluss; nach dem Turn fällt sie manchmal auf die Aufschlüsselung des vorherigen Turns zurück.
Mechanismus: Während der Agent beschäftigt war, bevorzugte die Anzeige den Idle-Snapshot von /context, der vor dem Turn aufgenommen wurde, gestreamte session.usage-Ticks erreichten sie also nie; danach konnte ein fehlgeschlagener oder langsamer Idle-Refresh den Snapshot von vor dem Turn wiederherstellen.
Fix (PR #121638): Während der Agent beschäftigt ist, nutzt die Anzeige das live gestreamte $currentUsage; der Idle-Snapshot wird ungültig, wenn ein Turn startet, und die Entscheidung „ist dieser Snapshot veraltet“ lebt an einer Stelle (use-context-breakdown), die nur eine Aufschlüsselung zurückgibt, wenn sie nicht beschäftigt ist und dieselbe Session betrifft — so kann ContextUsagePanel auch beim ersten beschäftigten Render nicht die Kategorien von vor dem Turn malen. Das deckt die eingefrorene Hälfte von #70871 ab; die Busy-Hang-Hälfte in TUI/Desktop liegt außerhalb des Umfangs.
5. Eine undurchsichtige 5xx einmal sondieren und In-Stream-Fehler ohne Status klassifizieren
Symptom A: Ein Provider antwortet auf Ihre Streaming-Anfrage mit einem bloßen 500/502/503 und sonst nichts, während dieselbe Anfrage nicht gestreamt ein 4xx mit einer aussagekräftigen Meldung liefert. Sie sehen immer nur das nutzlose 5xx.
Fix A (PR #121541): Bei einem Streaming-5xx macht _StreamingCall eine nicht gestreamte Probe mit denselben kwargs, höchstens einmal pro 60-Sekunden-Fenster (time.monotonic()). Liefert sie ein 4xx, wird dieser Fehler an Ort und Stelle geworfen; gelingt sie, wird die Antwort über ein reines _replay_final_response erneut abgespielt. Die Session wird nicht auf nicht gestreamt umgeschaltet, und nichts wird verriegelt. Die Probe suspendiert den Stream-Stale-Watchdog (_stream_stale_timeout = inf in try/finally), damit sie nicht als veraltet abgeschossen oder als Strike gezählt wird, und wird übersprungen, sobald /stop aussteht. Derselbe PR reklassifiziert den ValueError des jiter-Parsers bei einem beschädigten SSE-Chunk („EOF while parsing…“) als transienten Provider-Fehler, der wiederholt werden soll, statt als lokalen Bug, der den Turn beendet.
Symptom B: Der Fehler kommt innerhalb des Streams mit HTTP 200 an, sodass der Klassifizierer ihn als unbekannt/wiederholbar behandelt und dort wiederholt, wo er auf einen anderen Provider wechseln sollte.
Fix B (PR #121547): Der numerische code eines In-Stream-SSE-Fehlerobjekts (z. B. 403) wird jetzt als HTTP-Status gelesen — nur ganze Zahlen von 400 bis 599 zählen, {code: 200} und symbolische Codes bleiben also außen vor —, und ein Upstream-Ban wird als Auth klassifiziert (kein Retry) statt als „temporarily unavailable“. Statuslose Template-Render-Fehler (etwa die Jinja-Fehler von LM Studio) werden zu format_error, sodass der Turn auf einen anderen Provider wechselt, statt zu sterben, und der Hilfsclient weicht nun auch bei statuslosen strukturierten Stream-Fehlern auf den nächsten Provider aus.
6. Die Wiederholungssperre greift jetzt auf jedem Abschlusspfad
Symptom: Das Modell läuft in eine Schleife, gibt etwa 350.000 Zeichen Wiederholung aus und endet dann normal — die Schleife wird Ihnen also als Antwort zugestellt.
Mechanismus: Das Fenster-Zählen von is_repetition_dominated verpasste fast jede echte Schleife, wenn die Periode der Schleife nicht zum Fenster passte, und es lief nur auf dem Pfad finish_reason=length.
Fix (PR #121600): Ein Detektor für periodische Läufe wird mit dem bestehenden Fenster-Zähldurchlauf per OR verknüpft, sodass Schleifen mit Zählern, Rauschen oder Verschachtelung erkannt werden. Inhalte aus unterschiedlichen Zeilen (Tabellen, nummerierte Listen, CSV) werden weiterhin nicht markiert. Es bleibt linear: Ein Worst Case von 500.000 Zeichen dauert 0,16 s gegenüber 0,26 s auf main. Der Stop-Pfad bricht nur ab, wenn die Antwort mindestens 16.000 Zeichen lang ist (STOP_PATH_MIN_CHARS = 16_000) und wie eine außer Kontrolle geratene Schleife aussieht, sodass ausdrücklich gewünschte Wiederholungen („Hello world…“ fünfzigmal, templatisiertes YAML, wiederholte Log-Zeilen in einem Codeblock) weiterhin zugestellt werden, mit eingeprägtem Fehlergrund.
Derselbe Batch schließt ein unangenehmeres Loch: Tool-Argumente, die aus einem abgebrochenen Stream rekonstruiert werden, durchlaufen jetzt dieselbe Sperre — degenerierte Modellausgaben, die früher als Terminalbefehl ausgeführt werden konnten, werden nun abgelehnt.
7. Wenn das Modell sein Reasoning inline schreibt, müssen beide Hälften stimmen
Tag-Aliase (PR #121659): MiniMax-M3 verpackt sein Reasoning in chinesische Tag-Namen (思考, 反思, 推理, 推敲). THINK_TAG_NAMES kannte nur die englischen, der Reasoning-Text tauchte also in der Antwort auf. Alle vier stehen jetzt in der gemeinsamen Liste, aus der der Streaming-Scrubber, die CLI- und Gateway-Filter und das finale strip_think_blocks aufbauen. Derselbe PR behebt ein Problem mit abgeschnittenen Enden: Zwischenkommentare, die an einer Tool-Call-Grenze abgeschnitten wurden, wurden bei einem Prefix-Match früher als „already streamed“ markiert, wodurch der letzte Chunk verloren ging; jetzt werden sie zugestellt.
Inline-Reasoning in die Live-Pane (PR #121770): Bei Modellen, die ihr Reasoning in <think>-Blöcke schreiben, blieb die Reasoning-Pane des Desktops leer und reasoning_content war blank. Der Scrubber gibt jetzt den Text frei, den er entfernt hat, und dieser wird als Reasoning-Delta weitergegeben — nur wenn der Provider in derselben Anfrage kein natives Reasoning gestreamt hat, damit Reasoning nie doppelt erscheint. Für das finale Feld füllt _finish_chat_stream, wenn gar kein Reasoning-Delta ankommt, reasoning_content aus dem rohen Inhalt mit dem vorhandenen extract_reasoning und liest dabei nur die aktuelle Antwort, damit das Reasoning eines API-Calls nicht in den nächsten leckt.
8. Codex- und Responses-Watchdogs bekommen dieselbe Behandlung
Fix (PR #121542): drei Dinge. Fortschrittsbenachrichtigungen des Codex-App-Servers wurden an die UI gestreamt, erfrischten aber nie die Turn-Liveness, sodass ein langer, gesunder Codex-Turn vom 600-s-Liveness-Watchdog getötet wurde — jetzt erfrischen nicht-leere Text-, Reasoning- und Output-Deltas sowie Tool- und Message-Item-Start-Complete die Aktivität, während leere Deltas und Keepalives ignoriert werden. xAI und andere gehostete codex_responses-Transporte bekommen nun die Stale-/TTFB-Zugeständnisse für großen Context, die openai-codex bereits hatte, und genau die brachten gesunde xAI-Responses-Anfragen mit rund 90K Token zuvor um. Und die Max-Iteration-Zusammenfassung des Cron, die _run_codex_stream direkt aufrief, ist jetzt durch denselben unterbrechbaren Watchdog begrenzt wie jeder andere Aufruf — zuvor wurde ein offener Stream, der nie Daten lieferte, nie als veraltet abgeschossen, sodass der Cron-Job einfach hing.
Release-Status — hier lohnt Präzision
Diese PRs wurden am Nachmittag des 24. September 2026 in main gemergt (etwa 16:56–17:23 UTC), während der v0.21.5-Tag (v2026.9.24) an diesem Morgen um 10:09 UTC veröffentlicht wurde. Sie sind also nicht in v0.21.5; sie leben nur auf main. Wer sie will, braucht eine Git-Installation, die main folgt, oder wartet auf den nächsten Tag.
Diese Unterscheidung ist es wert, eigens ausgesprochen zu werden, denn „wann wurde es gefixt“ und „ab welcher Version bekomme ich es“ sind unterschiedliche Fragen — und in diesem Projekt weichen sie regelmäßig um nur wenige Stunden voneinander ab, weil Patch-Tags für die nachgelagerte Verteilung existieren und nicht für Feature-Ankündigungen.
Was Sie in Ihrem eigenen Install prüfen sollten
- Wenn Sie die gleiche Antwort zweimal in einer Session gesehen haben, prüfen Sie, ob es direkt nach einem Session-Wechsel mitten im Stream passierte — das ist der Fall #121602.
- Wenn Sie regelmäßig Text verlieren, den Sie nach einem 429 schon gelesen hatten, ist #121628 der für Sie wichtigste.
- Wenn ein Provider immer wieder mit einem nichtssagenden 5xx antwortet, wiederholen Sie dieselbe Anfrage auf einem neueren Build: Jetzt sollte dessen echter 4xx-Fehler erscheinen.
- Wenn Ihr Modell MiniMax-M3 ist und Reasoning in den Antworttext leckt, prüfen Sie nach dem Upgrade, ob der Text sauber ist.
Zu den benachbarten Mechanismen lohnen sich zwei bestehende Beiträge nebeneinander: Das Delivery-Ledger für doppelte Antworten behandelt eine zweimal zugestellte Antwort, und der Leitfaden zum Context-Usage-Anker erklärt, was die Zahlen auf dieser Anzeige tatsächlich bedeuten. Wo dieses Fenster innerhalb eines Releases liegt, zeigen die Release-Seite zu v0.21.5 und der Selbstcheck-Leitfaden zum v0.21.5-Fenster.
Die Kurzfassung
Zehn Fixes, ein Thema: Alles, was bereits auf dem Bildschirm erschienen ist, muss von der Abschlusslogik anerkannt werden. Streaming-Zustellung ist an einer Stelle schwer, die nicht schwer aussieht — nicht beim Ausgeben der Zeichen, sondern bei den vier Arten, wie ein Turn enden kann (Verbindungsabbruch, Retry, Unterbrechung, Session-Wechsel), von denen jede zuvor zugestellten Text anders behandelte. Dieser Batch bringt sie auf eine Linie.