Agent 在第四分钟突然安静了:Hermes 的超时分层全解
凌晨 2:40,你 2:05 启动的定时任务还显示“运行中”。日志最后一行是请求发出去了。没有报错、没有崩溃、没有重试——只有一个 HTTP 请求挂在那里,连接开着,Agent 在等一个永远不会来的首 token。与此同时,编辑器里是同一个问题的另一种味道:一个模型思考了四分钟,在第三分钟被切断,重试还是被切断,于是你判断“这模型不行”。这两件事都是超时问题,而 Hermes 是分层回答它们的——其中好几层在 2026-09-25 悄悄变了。
“沉默”是没人专门设计的故障模式
大家问得最多的两类故障看起来相反,根子是同一个:Agent 在干活的时候很好推理,Agent 沉默的时候就不好推理了。沉默可能意味着模型正深陷思考阶段,也可能意味着这个 socket 已经僵了。而这两种情况的头 60 秒,看起来一模一样。
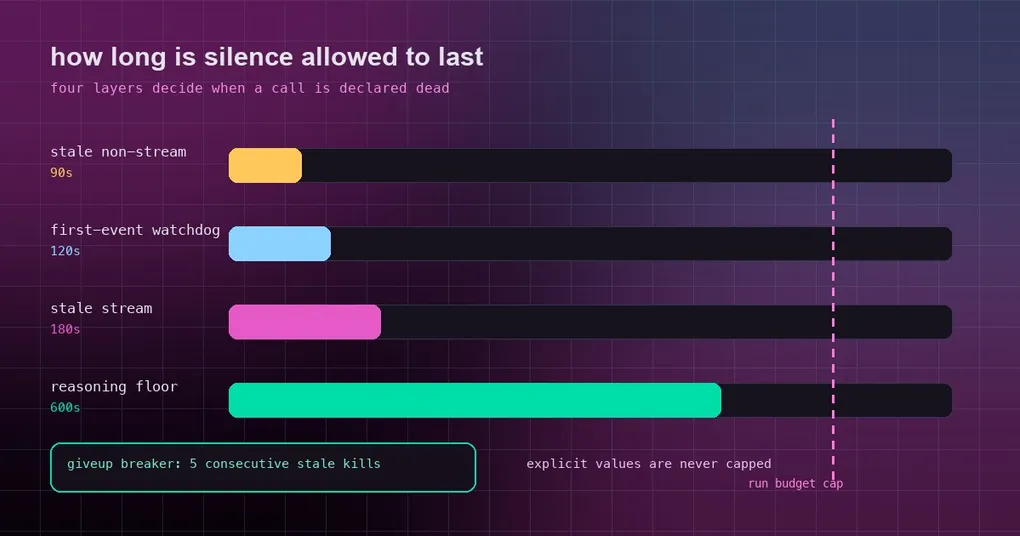
所以这套栈不问“它是不是慢”,它问的是“在某一层上,沉默最多允许持续多久“——而每层的答案是有意不同的:
| 层次 | 默认值 | 它实际盯的是什么 |
|---|---|---|
| socket 读取超时 | 120 秒(本地 1800 秒) | httpx 等下一个数据块 |
| 流式僵死检测 | 180 秒(本地上限 900 秒) | SSE 心跳到了但没有内容 |
| 非流式僵死检测 | 90 秒 | 非流式调用一直不回答 |
| Responses 首事件看门狗 | 120 秒(本地上限 900 秒) | 连接被接受,但一个流事件都没有 |
| API 调用(非流式) | 1800 秒 | 整个非流式请求 |
| 终帧后流排空 | 2 秒 | 永远不关 SSE socket 的中转 |
这张表里最有用的一句话是:僵死检测只在保持“隐式默认值”时才会自动调整。你一旦显式设了值,就等于接过了责任——对慢速本地服务器这是对的选择,对某台今晚状态很差的云端模型就是错的选择。
对推理模型来说,180 秒这个默认值是个谎言
聊天模型和推理模型不是一个物种。聊天模型接受请求后三分钟一个字都没出,基本可以判定死了;推理模型这样,很多时候只是正在想。而中间的上游代理不关心这个区别,会在思考中途把流按空闲掐掉,表现出来的往往是一个断管或协议错误,而不是“你的模型还在工作”。
所以项目里维护了一张地板表——按模型给一个最小耐心值,用 max(默认值, 地板值) 把僵死检测往上抬。它从不降低阈值,也从不覆盖你自己设的值。当前的地板,直接从源码里读出来:
| 地板 | 覆盖的模型(节选) |
|---|---|
| 600 秒 | Nemotron-3 Ultra/Super、DeepSeek 推理与 V4 系列、OpenAI o1/o3/o3-pro 家族、gpt-5.6 与 gpt-6 命名线、claude-fable |
| 300 秒 | Nemotron-3 Nano、QwQ-32B、o3-mini/o4-mini、明确带 reasoning 的 xAI Grok 组合、ox-alpha、Inkling、MiniMax M2.x |
| 240 秒 | Claude Opus 4.x / 5.x 的 thinking 变体 |
| 180 秒 | qwen3 系列、Claude Sonnet 5 / 4.5 / 4.6 |
MiniMax M2.x 是这张表里最新的成员,它是因为三份 bug 报告一起被并进 PR #121555 才加上的:M2.x 会在首个内容 token 之前先流式输出推理内容,且被观测到思考中途停顿约 240 秒——超过了 180 秒的默认值,于是它健康的时候被误杀。
上下文长度用同一套逻辑缩放,因为 10 万 token 的提示词首 token 就是比 2 千 token 慢:估算超过 5 万 token 时,流式检测至少抬到 240 秒;超过 10 万 token 至少 300 秒。非流式那边有自己的一档。注意:只有隐式默认值会被调整,你显式写下的数字不会被碰。
一次卡死的请求,居然能无视 run budget
agent.run_budget_seconds(或 hermes chat --run-budget 850 -q "...")的作用是别让自主运行的 Agent 无限烧下去。一旦设置,会有两件事发生:预算走到 80% 时给 Agent 一次性的收尾提醒,让它停止继续探索、直接产出交付物;同时隐式僵死超时被压到“剩余预算的一半”,下限 60 秒,这样一次静默卡死的调用不至于吞掉整轮运行。
Bug 就出在流式这条路上文档与实现的落差:这个上限只作用于非流式调用,而卡死的流仍然保留完整的僵死窗口;更糟的是,只要有一次调用在飞,收尾提醒就发不出去。于是一个 10 分钟预算、碰上僵死流的运行,可以大大方方超过自己的死线——提醒理论上可达,实际上不可达。修复让两个解析器共用同一个 cap_to_run_budget,流式与非流式的僵死超时从此用同一套算法。有一个不对称是故意的:显式的 HERMES_STREAM_STALE_TIMEOUT 被视为你自己的死线,永不被 run budget 压缩;被压缩的只是隐式值。
cron:卡在“第二次调用”上
同一个 PR 里的第三个修复,解释了一类“我的定时任务就是永远跑不完”。cron 的 Codex 调用跑在 worker 线程路径上,可能卡在连续第二次流式调用上——第一次正常,第二次无限等。现在 cron 运行(chat_completions 与 codex_responses)改为内联执行;更重要的是,内联路径拿到了和 worker 路径相同的大上下文地板和硬上限。PR 里给出的实测:在 3 万 token 的探测点上,内联路径过去只允许 90 秒,而 worker 允许 600 秒;现在两者都算出 600,硬上限设为 300 时两者都算出 300。
如果你跑无人值守的自动化,这条最值得记住:两条本该拥有相同耐心的代码路径,其中一条的耐心只有另一条的 1/6.7,而且可以在超时根本不触发的情况下把任务卡死。
参数打架时谁说了算
当好几个值都可能适用时,优先级是明确的,学一次就够:
- 显式配置压过一切隐式地板。
providers.<id>.stale_timeout_seconds(或providers.<id>.models.<model>.stale_timeout_seconds)是运维者给出的死线:它压过上下文分档和推理地板,也正因如此,它可以被用来故意缩短对卡死流的容忍时间。 - 只有 180 秒这个默认值会被缩放和抬地板。 别动它,你就白得上下文分档 + 模型地板。
HERMES_STREAM_STALE_TIMEOUT是用户值。 原样采纳,永不被 run budget 压缩。- 本地端点拿到的是有限上限,不是“永不超时”。 检测到本地端点且处于隐式默认时,
agent.local_stream_stale_timeout(900 秒)生效——过去那种“永不超时”的行为意味着一个僵死的本地服务器会永远挂着。 HERMES_STREAM_STALE_GIVEUP(默认 5,0 关闭)是熔断器:连续这么多次僵死击杀且没有任何一次完成的回答之后,后续每个调用直接带可操作的错误中止,而不是再等一遍超时。任何一次完成的回答、切换/model、激活 fallback,或新的一轮对话,都会重置它。
一个自建推理模型的实用写法(它就是需要思考几分钟):
providers:
  local-reasoning:
    stale_timeout_seconds: 900     # 显式:不缩放、不封顶
对可信的云端推理供应商则相反——保持隐式,让地板和上下文分档替你兜底:
agent:
  run_budget_seconds: 1800         # 80% 处提醒收尾,僵死上限取剩余预算的一半
怎么判断是谁杀了你的调用
- 被掐断后重试能成功:通常是僵死检测在长思考阶段触发——看看你的模型是否在地板表里,以及上下文是不是已经超过 5 万 token。
- 连续五次被杀,然后立刻中止:这是熔断器而不是供应商的问题,错误文本会点出连续次数。换个模型或新开一个会话;计数器会在下一次完成的回答后清零。
- 一次运行无视了自己的预算:那就是流式路径的那个缺口——这个症状值得重测,而不是靠调大超时绕过去。
- 定时任务卡在第二次供应商调用上:对应本批的内联执行修复。
这些东西发在哪
三个修复都在 PR #121555 里,2026-09-25 合并——比 v0.21.5 打标签晚,所以只在 main 上,会随下一个版本或跟踪 main 的 hermes update 到达。如果你现在正在调超时,上面的分层今天就已经生效,这个修复补的是两处实现落差。
站内相关阅读:连接静默断连一文讲的是同一问题在传输层的版本——连接看起来活着,其实早就没了;网关循环看门狗指南讲的是第三层:盯循环而不是单次调用的那一层。如果你的问题不是“卡住”而是“花钱”,接下来该读的是成本追踪一文。
结论
每一层上的沉默都需要一个预算,而这个预算必须诚实:它在衡量什么?对推理模型,诚实的默认值远长于聊天模型;对无人值守的运行,诚实的默认值就是这个运行自己的死线。值得带去你自己系统的做法和这里一样:按“沉默意味着什么”给超时分层——还没有事件、还没有内容、还没有答案、任务已经跑太久——并确保每一条会等待的代码路径都用同一套分层。一条悄悄等 90 秒、而它的兄弟路径等 600 秒的路径,不是调参差异,是一个带着秒表的 bug。