L'agent s'est tu à la quatrième minute — les couches de timeout d'Hermes, expliquées
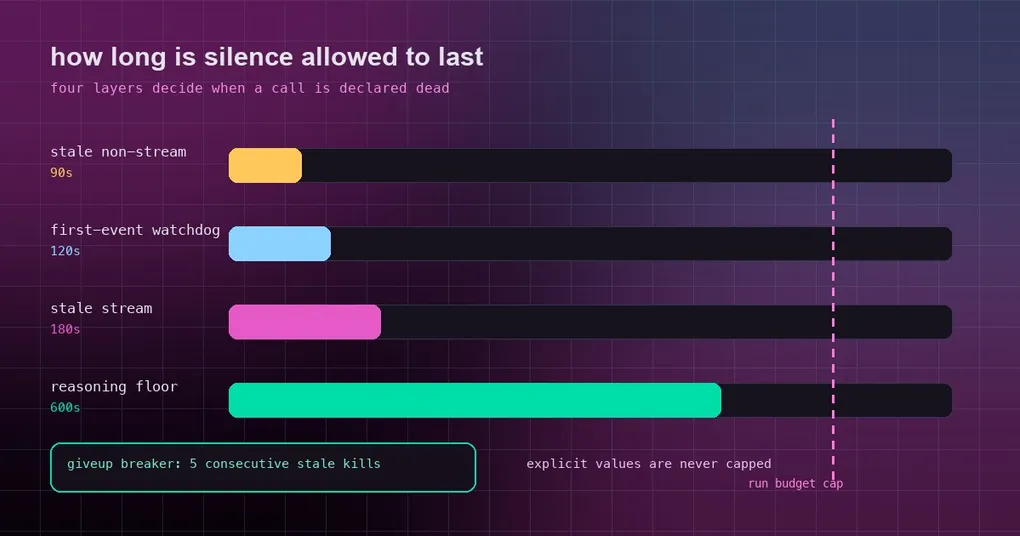
Il est 2 h 40 du matin et le job cron lancé à 2 h 05 affiche toujours running. La dernière ligne de log est la requête qui part. Pas d’erreur, pas de crash, pas de retry — juste un appel HTTP posé là, la connexion ouverte, l’agent qui attend un premier token qui ne viendra jamais. Pendant ce temps dans votre éditeur, une autre saveur du même problème : un modèle qui réfléchit quatre minutes se fait couper à trois, le retry produit la même coupure, et vous en concluez que le modèle est cassé. Les deux sont des questions de timeout, et Hermes y répond par couches — dont plusieurs ont discrètement changé le 2026-09-25.
Le silence est le mode d’échec que personne ne conçoit
Les deux pannes dont on parle le plus souvent semblent opposées mais ont une seule racine : un agent qui fait quelque chose est facile à appréhender, un agent silencieux ne l’est pas. Le silence peut vouloir dire qu’un modèle est en pleine phase de réflexion, ou que la socket est un zombie. Les mêmes 60 secondes de calme couvrent les deux cas.
Donc la pile ne demande pas « est-ce lent ? ». Elle demande « combien de temps le silence peut-il durer, à cette couche précise ? » — et la réponse diffère par couche, volontairement :
| Couche | Défaut | Ce qu’elle surveille réellement |
|---|---|---|
| Timeout de lecture socket | 120 s (1800 s en local) | httpx qui attend le prochain chunk |
| Détection de stream stagnant | 180 s (plafond 900 s en local) | Les keep-alives SSE qui arrivent sans contenu |
| Détection de non-stream stagnant | 90 s | Un appel non-streaming qui ne répond jamais |
| Chien de garde du premier événement Responses | 120 s (plafond 900 s en local) | Connexion acceptée, aucun événement de stream |
| Appel API (non-streaming) | 1800 s | Toute la requête non-streaming |
| Drain de stream post-terminal | 2 s | Les relais qui ne ferment jamais la socket SSE |
La phrase la plus utile de ce tableau : les détecteurs de stagnation ne s’ajustent automatiquement que tant qu’ils restent à leurs valeurs par défaut implicites. Fixez-en un explicitement et vous en assumez la responsabilité — ce qui est le bon choix pour un serveur local lent, et le mauvais pour un modèle cloud qui passe une mauvaise nuit.
Le défaut de 180 secondes est un mensonge pour les modèles de raisonnement
Un modèle de chat et un modèle de raisonnement ne sont pas le même animal. Un modèle de chat qui accepte une requête et n’émet rien pendant trois minutes est presque certainement mort. Un modèle de raisonnement qui fait ça est souvent simplement en train de réfléchir. Les proxies intermédiaires s’en moquent, et tuent le stream pour inactivité en pleine réflexion, ce qui arrive comme un broken pipe ou une erreur de protocole plutôt que comme un message disant « votre modèle travaillait encore ».
Le projet maintient donc une table de planchers — une patience minimale par modèle, qui fait monter le détecteur de stagnation via max(default, floor). Elle n’abaisse jamais un seuil et ne remplace jamais une valeur que vous avez fixée vous-même. Les planchers actuels, lus dans le code source :
| Plancher | Modèles couverts (sélection) |
|---|---|
| 600 s | Nemotron-3 Ultra/Super, les lignes DeepSeek reasoning et V4, la famille OpenAI o1/o3/o3-pro, les lignes nommées gpt-5.6 et gpt-6, claude-fable |
| 300 s | Nemotron-3 Nano, QwQ-32B, o3-mini/o4-mini, les paires xAI Grok reasoning explicites, ox-alpha, Inkling, MiniMax M2.x |
| 240 s | Les variantes thinking de Claude Opus 4.x et 5.x |
| 180 s | La famille qwen3, Claude Sonnet 5 / 4.5 / 4.6 |
MiniMax M2.x est la dernière entrée, et elle est arrivée à cause de trois rapports de bug regroupés dans PR #121555 : M2.x streame du contenu de raisonnement avant son premier token de contenu et avait été observé bloqué environ 240 secondes en pleine réflexion — au-delà du défaut de 180 s, donc il était tué alors qu’il était en bonne santé.
La taille du contexte monte de la même façon, parce qu’un prompt de 100k tokens donne un premier token plus lent qu’un prompt de 2k : au-dessus de 50k tokens estimés, le détecteur de streaming monte à au moins 240 s, au-dessus de 100k à au moins 300 s. Le côté non-streaming a ses propres paliers. Seuls les défauts implicites bougent — vos valeurs explicites ne sont pas touchées.
Le run budget qu’un appel bloqué pouvait ignorer
agent.run_budget_seconds (ou hermes chat --run-budget 850 -q "...") existe pour empêcher un run autonome de dépenser sans fin. Deux choses se produisent quand il est défini : à 80 % du budget, l’agent reçoit un avis de conclusion unique lui disant d’arrêter d’explorer et de produire le livrable, et les timeouts de stagnation implicites sont plafonnés à la moitié du budget restant, avec un plancher de 60 secondes, pour qu’un seul appel bloqué en silence ne puisse pas engloutir le reste du run.
Le bug était l’écart entre la documentation et l’implémentation sur le chemin streaming : le plafond s’appliquait aux appels non-streaming, mais un stream bloqué gardait toute sa fenêtre de stagnation, et l’avis de conclusion ne pouvait pas se déclencher pendant qu’un appel était en vol. Un run avec un budget de 10 minutes et un stream provider coincé pouvait dépasser sa propre échéance — l’avis était atteignable en théorie et inatteignable en pratique. Le correctif fait passer les deux résolveurs par un même cap_to_run_budget, pour que les timeouts de stagnation streaming et non-streaming se calculent de la même façon. Un détail asymétrique est délibéré : un HERMES_STREAM_STALE_TIMEOUT explicite est traité comme votre échéance et n’est jamais plafonné au run budget, alors que les valeurs implicites le sont.
Cron : le second appel qui se bloquait
Le troisième correctif du même PR est celui qui explique toute une classe de « mon job planifié ne se termine jamais ». Les appels Codex de cron tournaient sur le chemin worker-thread et pouvaient se bloquer sur le deuxième appel streaming consécutif — le premier marchait, le second attendait indéfiniment. Les runs cron (chat_completions et codex_responses) s’exécutent maintenant en ligne, et surtout, le chemin en ligne reçoit le même plancher grand contexte et le même plafond dur que le chemin worker. Dans la mesure citée dans la PR : sur une sonde de 30k tokens, le chemin en ligne autorisait auparavant 90 secondes là où le worker en autorisait 600 ; désormais les deux calculent 600, et avec le plafond dur configuré à 300 les deux calculent 300.
Si vous faites tourner de l’automatisation sans surveillance, c’est le changement à connaître : deux chemins de code qui auraient dû avoir la même patience, dont l’un était 6,7 fois moins patient et pouvait se coincer sans qu’aucun timeout ne se déclenche.
Quel réglage l’emporte
Quand plusieurs valeurs pourraient s’appliquer, la priorité est explicite et vaut la peine d’être apprise une fois :
- La configuration explicite bat tous les planchers implicites.
providers.<id>.stale_timeout_seconds(ouproviders.<id>.models.<model>.stale_timeout_seconds) est l’échéance de l’opérateur : elle l’emporte sur les paliers de taille de contexte et sur le plancher de raisonnement, et peut donc raccourcir volontairement la patience pour un stream bloqué. - Le défaut de 180 s est la seule valeur qui se fait à la fois mettre à l’échelle et plancher. Laissez-le tranquille et vous obtenez gratuitement la mise à l’échelle par le contexte plus le plancher du modèle.
HERMES_STREAM_STALE_TIMEOUTest une valeur utilisateur. Elle est honorée telle quelle, jamais plafonnée par le run budget.- Les endpoints locaux obtiennent des plafonds finis, pas des infinis.
agent.local_stream_stale_timeout(900 s) s’applique quand un endpoint local est détecté aux valeurs par défaut implicites — l’ancien comportement « ne jamais expirer » faisait qu’un serveur local coincé restait bloqué pour toujours. HERMES_STREAM_STALE_GIVEUP(défaut 5, 0 désactive) est le disjoncteur : après ce nombre de kills consécutifs pour stagnation sans aucune réponse terminée, chaque nouvel appel abandonne immédiatement avec une erreur exploitable au lieu d’attendre à nouveau le timeout. Il se réinitialise à toute réponse terminée, à un changement de/model, à l’activation d’un fallback ou à un nouveau tour.
Un exemple qui fonctionne pour un modèle de raisonnement auto-hébergé qui réfléchit légitimement pendant des minutes :
providers:
  local-reasoning:
    stale_timeout_seconds: 900     # explicite : jamais mis à l'échelle, jamais plafonné
et pour un provider de raisonnement cloud en qui vous avez confiance, le mouvement inverse — laissez-le implicite pour que le plancher et les paliers de contexte vous protègent :
agent:
  run_budget_seconds: 1800         # avis de conclusion à 80 %, plafonds de stagnation à la moitié du reste
Comment savoir ce qui a tué votre appel
- Une coupure suivie d’un retry qui réussit est généralement le détecteur de stagnation qui se déclenche pendant une longue phase de réflexion — regardez si votre modèle figure dans la table des planchers, et si vous dépassez 50k tokens de contexte.
- Cinq kills consécutifs puis un abandon immédiat, c’est le disjoncteur giveup, pas le provider : le texte de l’erreur nomme la série. Changez de modèle ou démarrez une nouvelle session ; le compteur se réinitialise à la prochaine réponse terminée.
- Un run qui ignore son propre budget était l’écart du chemin streaming — un symptôme qui mérite d’être retesté plutôt que contourné avec un timeout plus grand.
- Un job cron qui se bloque à son second appel provider correspond au correctif d’exécution en ligne de ce lot.
Ce qui est livré, et où
Les trois correctifs sont dans PR #121555, fusionnée le 2026-09-25 — après la création du tag v0.21.5, donc ils sont sur main uniquement et arrivent avec la prochaine release ou un hermes update qui suit main. Si vous réglez des timeouts en ce moment, la stratification décrite ci-dessus fonctionne déjà aujourd’hui ; ce sont les deux écarts d’implémentation que le correctif ferme.
Lectures liées sur ce site : le billet sur la déconnexion silencieuse couvre la version transport du même problème — des connexions qui ont l’air vivantes et ne le sont pas — et le guide du chien de garde de boucle du gateway couvre la troisième couche, celle qui surveille la boucle plutôt qu’un appel isolé. Si votre problème n’est pas « ça se bloque » mais « ça coûte », le billet sur le suivi des coûts est la suite à lire.
Ce qu’il faut retenir
Le silence a besoin d’un budget à chaque couche, et ce budget doit être honnête sur ce qu’il mesure. Pour les modèles de raisonnement, le défaut honnête est bien plus long que pour les modèles de chat ; pour un run sans surveillance, le défaut honnête est l’échéance du run lui-même. Le schéma à reprendre dans vos propres systèmes est le même qu’ici : stratifiez vos timeouts selon ce que le silence signifie — pas encore d’événement, pas encore de contenu, pas encore de réponse, tâche qui tourne trop longtemps — et assurez-vous que chaque chemin de code qui peut attendre utilise les mêmes paliers. Un chemin qui attend discrètement 90 secondes là où son jumeau attend 600 n’est pas une différence de réglage ; c’est un bug avec un chronomètre.