Der Agent verstummte in Minute vier — Hermes' Timeout-Schichten erklärt
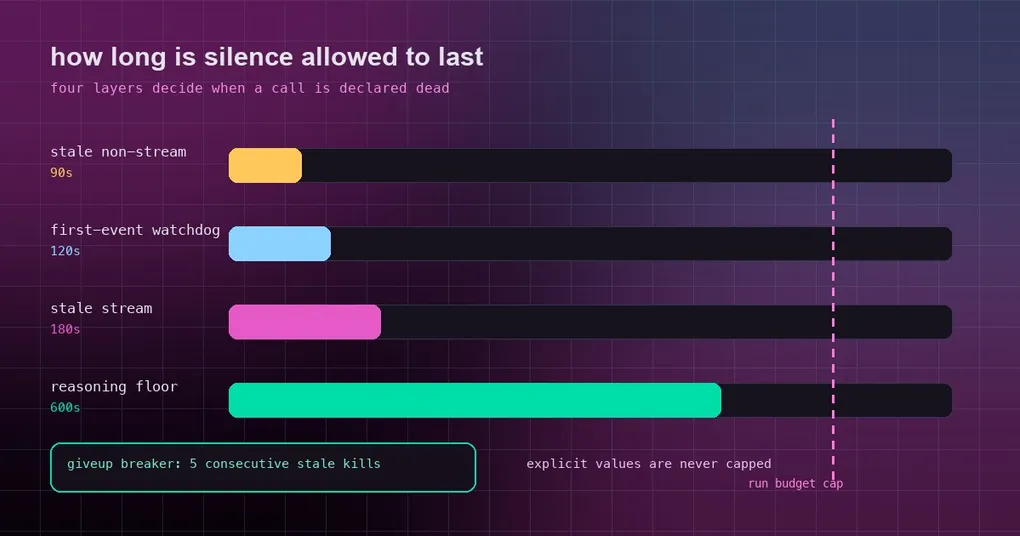
Es ist 2:40 Uhr morgens und der cron-Job, den Sie um 2:05 gestartet haben, sagt immer noch running. Die letzte Log-Zeile ist die Anfrage, die rausgeht. Kein Fehler, kein Crash, kein Retry — nur ein HTTP-Call, der dasitzt, die Verbindung offen, der Agent wartet auf ein erstes Token, das nie kommt. Währenddessen in Ihrem Editor eine andere Variante desselben Problems: Ein Modell, das vier Minuten nachdenkt, wird nach drei abgeschnitten, der Retry erzeugt denselben Abbruch, und Sie schließen daraus, das Modell sei kaputt. Beides sind Timeout-Fragen, und Hermes beantwortet sie in Schichten — von denen sich am 25. September 2026 mehrere still geändert haben.
Stille ist der Fehlermodus, für den niemand entwirft
Die zwei Fehler, die am häufigsten zur Sprache kommen, wirken entgegengesetzt, haben aber eine Wurzel: Ein Agent, der etwas tut, ist leicht zu durchschauen; ein Agent, der still ist, nicht. Stille kann bedeuten, dass ein Modell tief in einer Denkphase steckt, oder dass der Socket ein Zombie ist. Dieselben 60 Sekunden Ruhe decken beides ab.
Der Stack fragt also nicht „ist es langsam?“, sondern „wie lange darf Stille auf dieser konkreten Schicht dauern?“ — und die Antwort unterscheidet sich absichtlich pro Schicht:
| Schicht | Default | Was sie tatsächlich beobachtet |
|---|---|---|
| Socket-Read-Timeout | 120s (1800s lokal) | httpx wartet auf den nächsten Chunk |
| Stale-Stream-Erkennung | 180s (900s Obergrenze lokal) | SSE-Keep-Alives, die ohne Inhalt eintreffen |
| Stale-Non-Stream-Erkennung | 90s | Ein nicht streamender Call, der nie antwortet |
| Responses-First-Event-Watchdog | 120s (900s Obergrenze lokal) | Verbindung akzeptiert, überhaupt kein Stream-Event |
| API-Call (nicht streamend) | 1800s | Die gesamte nicht streamende Anfrage |
| Post-Terminal-Stream-Drain | 2s | Relays, die den SSE-Socket nie schließen |
Der einzige wirklich nützliche Satz in dieser Tabelle: Die Stale-Detektoren passen sich nur an, solange sie auf ihren impliziten Defaults stehen. Setzen Sie einen explizit, haben Sie die Verantwortung dafür übernommen — was für einen langsamen lokalen Server die richtige Entscheidung ist und für ein Cloud-Modell mit schlechter Nacht die falsche.
Der 180-Sekunden-Default ist für Reasoning-Modelle eine Lüge
Chat-Modelle und Reasoning-Modelle sind nicht dasselbe Tier. Ein Chat-Modell, das eine Anfrage annimmt und drei Minuten nichts ausgibt, ist fast sicher tot. Ein Reasoning-Modell, das das tut, denkt häufig nur nach. Die vorgeschalteten Proxies dazwischen interessieren sich nicht für den Unterschied und killen den Stream mitten im Denken wegen Idle, was als Broken Pipe oder Protokollfehler ankommt statt als irgendetwas, das sagt „Ihr Modell hat noch gearbeitet“.
Deshalb pflegt das Projekt eine Floor-Tabelle — ein Mindestmaß an Geduld pro Modell, das den Stale-Detektor nach oben skaliert mit max(default, floor). Sie senkt niemals einen Schwellenwert und überschreibt niemals einen Wert, den Sie selbst gesetzt haben. Die aktuellen Floors, aus dem Quellcode gelesen:
| Floor | Abgedeckte Modelle (Auswahl) |
|---|---|
| 600s | Nemotron-3 Ultra/Super, DeepSeek Reasoning- und V4-Linien, OpenAI o1/o3/o3-pro-Familie, die benannten gpt-5.6- und gpt-6-Linien, claude-fable |
| 300s | Nemotron-3 Nano, QwQ-32B, o3-mini/o4-mini, die expliziten xAI-Grok-Reasoning-Paare, ox-alpha, Inkling, MiniMax M2.x |
| 240s | Claude Opus 4.x und 5.x Thinking-Varianten |
| 180s | qwen3-Familie, Claude Sonnet 5 / 4.5 / 4.6 |
MiniMax M2.x ist der neueste Eintrag und kam wegen dreier Bug-Reports, die in PR #121555 gebündelt wurden: M2.x streamt Reasoning-Inhalt vor seinem ersten Content-Token und wurde dabei beobachtet, wie es etwa 240 Sekunden mitten im Denken hängen blieb — jenseits des 180s-Defaults, sodass es gekillt wurde, obwohl es gesund war.
Die Context-Größe skaliert auf dieselbe Weise, weil ein 100k-Token-Prompt ein langsameres erstes Token hat als ein 2k-Prompt: oberhalb von geschätzten 50k Token steigt der Streaming-Detektor auf mindestens 240s, oberhalb von 100k auf mindestens 300s. Die nicht streamende Seite hat ihre eigenen Stufen. Nur die impliziten Defaults bewegen sich — Ihre expliziten Zahlen bleiben unangetastet.
Das Run-Budget, das ein hängender Call ignorieren konnte
agent.run_budget_seconds (oder hermes chat --run-budget 850 -q "...") existiert, um einen autonomen Lauf davon abzuhalten, ewig Zeit zu verbrauchen. Wenn es gesetzt ist, passieren zwei Dinge: Bei 80 % des Budgets bekommt der Agent eine einmalige Wrap-up-Notiz, die ihm sagt, er solle aufhören zu explorieren und das Deliverable liefern, und implizite Stale-Timeouts werden auf die Hälfte des verbleibenden Budgets gedeckelt, mit einem Floor von 60 Sekunden, damit ein still hängender Call nicht den Rest des Laufs verschlingt.
Der Bug war die Lücke zwischen Dokumentation und Implementierung auf dem streaming-Pfad: Die Deckelung griff für nicht streamende Calls, aber ein hängender Stream behielt sein volles Stale-Fenster, und die Wrap-up-Notiz konnte nicht feuern, während ein Call unterwegs war. Ein Lauf mit 10-Minuten-Budget und einem festgefahrenen Provider-Stream konnte an seiner eigenen Deadline vorbeisegeln — die Notiz war theoretisch erreichbar und praktisch unerreichbar. Der Fix schickt beide Resolver durch ein cap_to_run_budget, sodass Streaming- und Non-Streaming-Stale-Timeouts gleich berechnet werden. Ein asymmetrisches Detail ist Absicht: Ein expliziter HERMES_STREAM_STALE_TIMEOUT wird als Ihre Deadline behandelt und nie auf das Run-Budget gedeckelt, implizite Werte schon.
Cron: der zweite Call, der hing
Der dritte Fix im selben PR ist der, der eine ganze Klasse von „mein geplanter Job wird einfach nie fertig“ erklärt. Cron-Codex-Calls liefen auf dem Worker-Thread-Pfad und konnten beim zweiten aufeinanderfolgenden Streaming-Call hängen — der erste funktionierte, der zweite wartete ewig. Cron-Läufe (chat_completions und codex_responses) laufen jetzt inline, und, wichtiger, der Inline-Pfad bekommt denselben Large-Context-Floor und Hard-Cap, den der Worker-Pfad bekam. In der im PR zitierten Messung: Bei einer 30k-Token-Probe erlaubte der Inline-Pfad zuvor 90 Sekunden, wo der Worker 600 erlaubte; jetzt berechnen beide 600, und mit auf 300 konfiguriertem Hard-Cap berechnen beide 300.
Wenn Sie unbeaufsichtigte Automatisierung betreiben, ist das die Änderung, die Sie kennen sollten: zwei Codepfade, die identische Geduld hätten haben sollen, von denen einer 6,7× weniger geduldig war und sich festfahren konnte, ohne dass je ein Timeout feuerte.
Welcher Knopf gewinnt
Wenn mehrere Werte greifen könnten, ist die Precedence explizit und es lohnt sich, sie einmal zu lernen:
- Explizite Config schlägt jeden impliziten Floor.
providers.<id>.stale_timeout_seconds(oderproviders.<id>.models.<model>.stale_timeout_seconds) ist die Deadline des Operators: Sie gewinnt über die Context-Size-Stufen und den Reasoning-Floor und kann die Geduld für einen hängenden Stream daher absichtlich verkürzen. - Der 180s-Default ist der einzige Wert, der skaliert und gefloort wird. Lassen Sie ihn in Ruhe, und Sie bekommen Context-Skalierung plus Modell-Floor gratis.
HERMES_STREAM_STALE_TIMEOUTist ein User-Wert. Er wird unverändert respektiert, nie durch das Run-Budget gedeckelt.- Lokale Endpunkte bekommen endliche Obergrenzen, keine Unendlichkeiten.
agent.local_stream_stale_timeout(900s) gilt, wenn ein lokaler Endpunkt bei impliziten Defaults erkannt wird — das frühere „niemals timeouten“ bedeutete, dass ein festgefahrener lokaler Server ewig hing. HERMES_STREAM_STALE_GIVEUP(Default 5, 0 deaktiviert) ist der Circuit Breaker: Nach so vielen aufeinanderfolgenden Stale-Kills ohne abgeschlossene Antwort bricht jeder neue Call sofort mit einem handlungsfähigen Fehler ab, statt den Timeout erneut abzuwarten. Er wird bei jeder abgeschlossenen Antwort, einem/model-Wechsel, der Aktivierung eines Fallbacks oder einem neuen Turn zurückgesetzt.
Ein funktionierendes Beispiel für ein selbst gehostetes Reasoning-Modell, das legitim minutenlang nachdenkt:
providers:
  local-reasoning:
    stale_timeout_seconds: 900     # explizit: wird nie skaliert, nie gedeckelt
und für einen Cloud-Reasoning-Provider, dem Sie vertrauen, die entgegengesetzte Bewegung — lassen Sie ihn implizit, damit Floor und Context-Stufen Sie schützen:
agent:
  run_budget_seconds: 1800         # Wrap-up-Notiz bei 80 %, Stale-Caps bei der Hälfte des Rests
Wie Sie erkennen, was Ihren Call gekillt hat
- Ein Abbruch mit einem Retry, der gelingt, ist meist der Stale-Detektor, der während einer langen Denkphase feuert — prüfen Sie, ob Ihr Modell in der Floor-Tabelle steht und ob Sie jenseits von 50k Token Context liegen.
- Fünf aufeinanderfolgende Kills und dann ein sofortiger Abbruch ist der Giveup-Breaker, nicht der Provider: Der Fehlertext nennt die Serie. Wechseln Sie das Modell oder starten Sie eine neue Session; der Zähler wird bei der nächsten abgeschlossenen Antwort zurückgesetzt.
- Ein Lauf, der sein eigenes Budget ignoriert, war die Lücke auf dem Streaming-Pfad — ein Symptom, das einen neuen Test verdient, statt es mit einem größeren Timeout zu umgehen.
- Ein cron-Job, der bei seinem zweiten Provider-Call hängt, passt zum Inline-Execution-Fix in diesem Batch.
Was ausgeliefert wurde, und wo
Alle drei Fixes stecken in PR #121555, gemergt am 25. September 2026 — nachdem der Tag v0.21.5 geschnitten wurde, also nur auf main, und sie kommen mit dem nächsten Release oder einem hermes update, das main trackt. Wenn Sie gerade an Timeouts tunen: Das Layering oben funktioniert schon heute; der Fix schließt die beiden Implementierungslücken.
Weiterführende Lektüre auf dieser Seite: Der Beitrag zum stillen Disconnect behandelt die transportnahe Version desselben Problems — Verbindungen, die lebendig aussehen und es nicht sind —, und der Leitfaden zum Gateway-Loop-Watchdog behandelt die dritte Schicht, die den Loop beobachtet statt einen einzelnen Call. Wenn Ihr Problem nicht „es hängt“ ist, sondern „es kostet“, sollten Sie als Nächstes den Beitrag zum Cost-Tracking lesen.
Was Sie mitnehmen sollten
Stille braucht auf jeder Schicht ein Budget, und das Budget muss ehrlich darüber sein, was es misst. Für Reasoning-Modelle ist der ehrliche Default deutlich länger als für Chat-Modelle; für einen unbeaufsichtigten Lauf ist der ehrliche Default die eigene Deadline des Laufs. Das Muster, das Sie in Ihre eigenen Systeme mitnehmen können, ist dasselbe wie hier: Staffeln Sie Ihre Timeouts danach, was die Stille bedeutet — noch kein Event, noch kein Inhalt, noch keine Antwort, Task läuft zu lange — und stellen Sie sicher, dass jeder Codepfad, der warten kann, dieselben Stufen nutzt. Ein Pfad, der still 90 Sekunden wartet, wo sein Geschwister 600 wartet, ist kein Tuning-Unterschied; er ist ein Bug mit Stoppuhr.