El agente se quedó callado en el minuto cuatro: las capas de timeout de Hermes, explicadas
Son las 2:40 de la madrugada y el cron job que arrancaste a las 2:05 sigue diciendo running. La última línea del log es la petición saliendo. Sin error, sin crash, sin reintento: solo una llamada HTTP ahí parada, la conexión abierta, el agente esperando un primer token que no va a llegar. Mientras tanto, en tu editor, otra versión del mismo problema: un modelo que piensa cuatro minutos se corta a los tres, el reintento produce el mismo corte y tú concluyes que el modelo está roto. Las dos cosas son preguntas de timeout, y Hermes las responde por capas — varias de las cuales cambiaron en silencio el 2026-09-25.
El silencio es el modo de fallo para el que nadie diseña
Los dos fallos que más se reportan parecen opuestos, pero tienen una raíz común: un agente que está haciendo algo es fácil de razonar; un agente que está silencioso, no. El silencio puede significar que un modelo está metido en una fase de pensamiento, o que el socket es un zombi. Los mismos 60 segundos de quietud cubren las dos cosas.
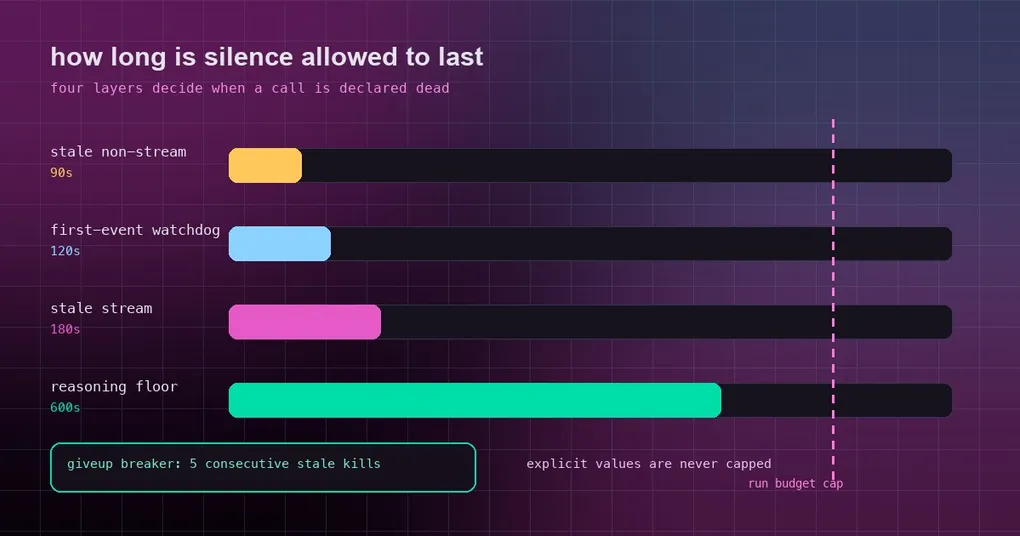
Así que la pila no pregunta «¿va lento?». Pregunta «¿cuánto puede durar el silencio, en esta capa concreta?» — y la respuesta cambia según la capa a propósito:
| Capa | Valor por defecto | Qué vigila realmente |
|---|---|---|
| Timeout de lectura de socket | 120s (1800s en local) | httpx esperando el siguiente chunk |
| Detección de stream stale | 180s (techo de 900s en local) | Keep-alives SSE que llegan sin contenido |
| Detección de stale sin stream | 90s | Una llamada sin streaming que nunca responde |
| Watchdog del primer evento de Responses | 120s (techo de 900s en local) | Conexión aceptada, ningún evento de stream |
| Llamada API (sin streaming) | 1800s | La petición completa sin streaming |
| Drenaje del stream post-terminal | 2s | Relays que nunca cierran el socket SSE |
La frase más útil de esta tabla: los detectores de stale solo se autoajustan mientras están en sus valores por defecto implícitos. Si pones uno explícitamente, has asumido la responsabilidad sobre él — lo cual es la decisión correcta para un servidor local lento, y la equivocada para un modelo en la nube que tiene una mala noche.
El valor por defecto de 180 segundos es una mentira para los modelos de razonamiento
Los modelos de chat y los de razonamiento no son el mismo animal. Un modelo de chat que acepta una petición y no emite nada durante tres minutos está casi seguro muerto. Un modelo de razonamiento que hace eso muchas veces solo está pensando. Los proxies intermedios no se preocupan por la diferencia y matan el stream por inactividad en pleno pensamiento, lo cual llega como un broken pipe o un error de protocolo, no como algo que diga «tu modelo seguía trabajando».
Por eso el proyecto mantiene una tabla de mínimos: una paciencia mínima por modelo que escala el detector de stale hacia arriba con max(default, floor). Nunca baja un umbral y nunca sobrescribe un valor que hayas puesto tú. Los mínimos actuales, sacados del código:
| Mínimo | Modelos cubiertos (selección) |
|---|---|
| 600s | Nemotron-3 Ultra/Super, las líneas de razonamiento DeepSeek y V4, la familia OpenAI o1/o3/o3-pro, las líneas con nombre gpt-5.6 y gpt-6, claude-fable |
| 300s | Nemotron-3 Nano, QwQ-32B, o3-mini/o4-mini, los pares xAI Grok de razonamiento explícitos, ox-alpha, Inkling, MiniMax M2.x |
| 240s | Variantes thinking de Claude Opus 4.x y 5.x |
| 180s | Familia qwen3, Claude Sonnet 5 / 4.5 / 4.6 |
MiniMax M2.x es la entrada más nueva, y llegó a raíz de tres reportes de bug agrupados en PR #121555: M2.x emite contenido de razonamiento antes de su primer token de contenido y se le había observado atascándose unos 240 segundos a mitad de pensamiento — por encima del valor por defecto de 180s, así que lo estaban matando estando sano.
El tamaño del contexto escala igual, porque un prompt de 100k tokens tarda más en dar el primer token que uno de 2k: por encima de 50k tokens estimados el detector de streaming sube a 240s como mínimo, y por encima de 100k a 300s como mínimo. El lado sin streaming tiene sus propios niveles. Solo se mueven los valores por defecto implícitos; tus números explícitos no se tocan.
El run budget que una llamada colgada podía ignorar
agent.run_budget_seconds (o hermes chat --run-budget 850 -q "...") existe para evitar que un run autónomo se pase gastando para siempre. Cuando está configurado pasan dos cosas: al 80% del presupuesto el agente recibe un aviso único de cierre que le dice que deje de explorar y produzca el entregable, y los timeouts de stale implícitos quedan limitados a la mitad del presupuesto restante, con un mínimo de 60 segundos, para que una llamada colgada en silencio no se trague el resto del run.
El bug era la distancia entre la documentación y la implementación en la ruta de streaming: el límite se aplicaba a las llamadas sin streaming, pero un stream colgado conservaba su ventana completa de stale, y el aviso de cierre no podía dispararse mientras hubiera una llamada en vuelo. Un run con un presupuesto de 10 minutos y un stream del provider atascado podía pasarse de su propia fecha límite: el aviso era alcanzable en teoría e inalcanzable en la práctica. El arreglo pasa los dos resolvers por un único cap_to_run_budget, así que los timeouts de stale de streaming y de no-streaming se calculan de la misma forma. Hay un detalle asimétrico deliberado: un HERMES_STREAM_STALE_TIMEOUT explícito se trata como tu fecha límite y nunca se limita al run budget, mientras que los valores implícitos sí.
Cron: la segunda llamada que se colgaba
El tercer arreglo del mismo PR es el que explica una clase entera de «mi trabajo programado nunca termina». Las llamadas Cron Codex corrían por la ruta de worker thread y podían colgarse en la segunda llamada consecutiva de streaming: la primera funcionaba, la segunda esperaba para siempre. Los runs de cron (chat_completions y codex_responses) ahora se ejecutan inline y, más importante, la ruta inline recibe el mismo mínimo para contexto grande y el mismo tope duro que recibía la ruta de worker. En la medición citada en el PR: con una sonda de 30k tokens, la ruta inline permitía antes 90 segundos donde la de worker permitía 600; ahora ambas calculan 600, y con el tope duro configurado a 300 ambas calculan 300.
Si ejecutas automatización desatendida, este es el cambio que hay que conocer: dos rutas de código que deberían haber tenido la misma paciencia, una de las cuales era 6,7 veces menos paciente y podía atascarse sin que llegara a dispararse nunca un timeout.
Qué ajuste gana
Cuando pueden aplicarse varios valores, la precedencia es explícita y merece la pena aprenderla una vez:
- La configuración explícita gana a todo mínimo implícito.
providers.<id>.stale_timeout_seconds(oproviders.<id>.models.<model>.stale_timeout_seconds) es la fecha límite del operador: gana a los niveles por tamaño de contexto y al mínimo por razonamiento, y por tanto puede acortar la paciencia a propósito para un stream colgado. - El valor por defecto de 180s es el único que se escala y recibe mínimo. Déjalo en paz y tendrás gratis el escalado por contexto y el mínimo por modelo.
HERMES_STREAM_STALE_TIMEOUTes un valor del usuario. Se respeta tal cual, nunca lo limita el run budget.- Los endpoints locales tienen techos finitos, no infinitos.
agent.local_stream_stale_timeout(900s) se aplica cuando se detecta un endpoint local en valores por defecto implícitos: el antiguo comportamiento de «no hagas timeout nunca» significaba que un servidor local atascado se quedaba colgado para siempre. HERMES_STREAM_STALE_GIVEUP(por defecto 5, 0 lo desactiva) es el cortacircuitos: tras esa cantidad de muertes consecutivas por stale sin ninguna respuesta completada, cada llamada nueva aborta de inmediato con un error accionable en lugar de esperar otra vez a que pase el timeout. Se reinicia con cualquier respuesta completada, un cambio de/model, la activación de un fallback o un turno nuevo.
Un ejemplo que funciona para un modelo de razonamiento autoalojado que legítimamente piensa durante minutos:
providers:
  local-reasoning:
    stale_timeout_seconds: 900     # explícito: nunca se escala, nunca se limita
y para un provider de razonamiento en la nube en el que confías, el movimiento contrario: déjalo implícito para que el mínimo y los niveles por contexto te protejan:
agent:
  run_budget_seconds: 1800         # aviso de cierre al 80%, los stale se limitan a la mitad del resto
Cómo saber qué mató tu llamada
- Un corte con un reintento que sí funciona suele ser el detector de stale disparándose durante una fase larga de pensamiento: comprueba si tu modelo está en la tabla de mínimos y si has pasado los 50k tokens de contexto.
- Cinco muertes consecutivas y luego un aborto inmediato es el breaker de giveup, no el provider: el texto del error nombra la racha. Cambia de modelo o empieza una sesión nueva; el contador se reinicia con la siguiente respuesta completada.
- Un run que ignora su propio presupuesto era el hueco de la ruta de streaming: un síntoma que conviene volver a probar en lugar de rodearlo con un timeout más grande.
- Un cron job que se cuelga en su segunda llamada al provider encaja con el arreglo de ejecución inline de este lote.
Qué se ha publicado y dónde
Los tres arreglos están en PR #121555, mergeado el 2026-09-25 — después de que se cortara el tag v0.21.5, así que están solo en main y llegan con la siguiente release o con un hermes update que siga main. Si estás ajustando timeouts ahora mismo, el escalado por capas de arriba ya funciona hoy; lo que el arreglo cierra son los dos huecos de implementación.
Lecturas relacionadas en este sitio: el artículo sobre la desconexión silenciosa cubre la versión a nivel de transporte del mismo problema — conexiones que parecen vivas y no lo están — y la guía del watchdog de bucles del gateway cubre la tercera capa, la que vigila el bucle en lugar de una sola llamada. Si tu problema no es «se cuelga» sino «cuesta», lo siguiente que deberías leer es el artículo sobre seguimiento de costes.
Qué llevarte
El silencio necesita un presupuesto en cada capa, y el presupuesto tiene que ser honesto sobre qué está midiendo. Para los modelos de razonamiento el valor por defecto honesto es mucho más largo que para los de chat; para un run desatendido, el valor por defecto honesto es la propia fecha límite del run. El patrón que conviene llevar a tus propios sistemas es el mismo que aquí: organiza tus timeouts por capas según lo que significa el silencio — aún no hay evento, aún no hay contenido, aún no hay respuesta, la tarea lleva demasiado tiempo — y asegúrate de que cada ruta de código que pueda esperar use las mismas capas. Una ruta que espera 90 segundos en silencio donde su hermana espera 600 no es una diferencia de ajuste; es un bug con cronómetro.