O agent calou-se ao quarto minuto — as camadas de timeout do Hermes, explicadas
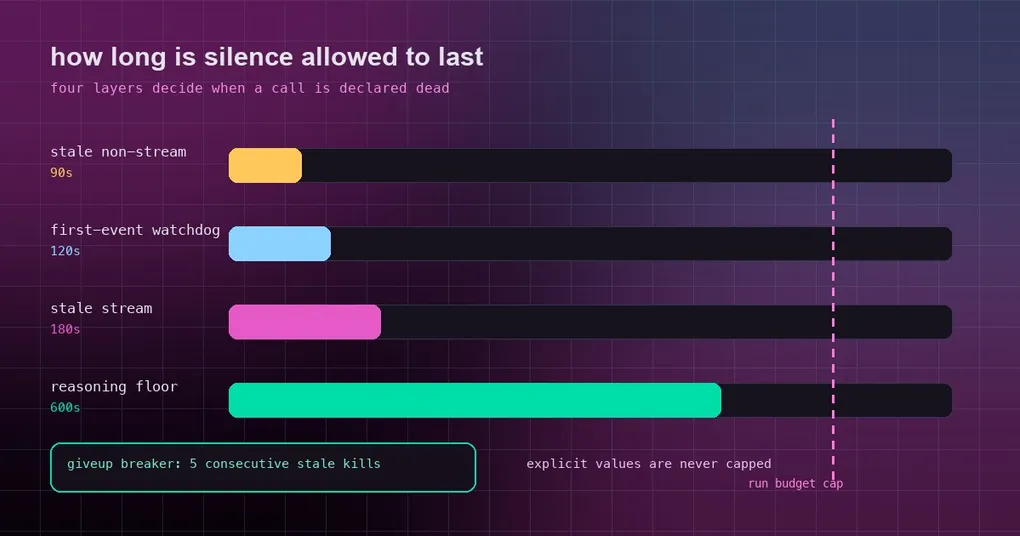
São 2h40 da manhã e o job de cron que arrancou às 2h05 continua a dizer a correr. A última linha do log é o pedido a sair. Sem erro, sem crash, sem retry — apenas uma chamada HTTP parada ali, a ligação aberta, o agent à espera de um primeiro token que nunca chega. Entretanto, no seu editor, outra versão do mesmo problema: um modelo que pensa durante quatro minutos é cortado aos três, e o retry produz o mesmo corte, e conclui que o modelo está avariado. Ambos são questões de timeout, e o Hermes responde-lhes em camadas — várias das quais mudaram em silêncio a 2026-09-25.
O silêncio é o modo de falha para o qual ninguém desenha
As duas falhas que as pessoas trazem mais vezes parecem opostas mas têm uma raiz comum: um agent que está a fazer algo é fácil de compreender, e um agent em silêncio não é. Silêncio pode significar que um modelo está numa fase profunda de raciocínio, ou pode significar que o socket é um zombie. Os mesmos 60 segundos de silêncio cobrem os dois casos.
Por isso a pilha não pergunta «está lento?». Pergunta «quanto tempo pode durar o silêncio, nesta camada específica?» — e a resposta difere por camada, de propósito:
| Camada | Predefinição | O que vigia na prática |
|---|---|---|
| Timeout de leitura do socket | 120s (1800s em local) | httpx à espera do próximo bloco |
| Detecção de stream obsoleto | 180s (teto de 900s em local) | keep-alives SSE a chegar sem conteúdo |
| Detecção de non-stream obsoleto | 90s | Uma chamada non-streaming que nunca responde |
| Watchdog do primeiro evento de Responses | 120s (teto de 900s em local) | Ligação aceite, nenhum evento de stream de todo |
| Chamada de API (non-streaming) | 1800s | O pedido non-streaming inteiro |
| Drenagem do stream pós-terminal | 2s | Relays que nunca fecham o socket SSE |
A frase mais útil desta tabela: os detetores de obsolescência só se auto-ajustam enquanto estão nos seus valores predefinidos implícitos. Defina um explicitamente e passou a ser responsável por ele — o que é a decisão certa para um servidor local lento, e a errada para um modelo na cloud a ter uma noite má.
A predefinição de 180 segundos é uma mentira para modelos de raciocínio
Modelos de conversa e modelos de raciocínio não são o mesmo animal. Um modelo de conversa que aceita um pedido e não emite nada durante três minutos está quase de certeza morto. Um modelo de raciocínio a fazer isso está frequentemente só a pensar. Os proxies a montante não se importam com a diferença e matam o stream por inatividade a meio do raciocínio, o que chega como uma broken pipe ou um erro de protocolo, em vez de algo que diga «o seu modelo ainda estava a trabalhar».
Por isso o projeto mantém uma tabela de mínimos — uma paciência mínima por modelo que escala o detetor de obsolescência para cima com max(default, floor). Nunca baixa um limite e nunca sobrepõe um valor que definiu. Os mínimos atuais, lidos do código-fonte:
| Mínimo | Modelos abrangidos (seleção) |
|---|---|
| 600s | Nemotron-3 Ultra/Super, linhas DeepSeek reasoning e V4, família OpenAI o1/o3/o3-pro, linhas nomeadas gpt-5.6 e gpt-6, claude-fable |
| 300s | Nemotron-3 Nano, QwQ-32B, o3-mini/o4-mini, os pares explícitos de raciocínio xAI Grok, ox-alpha, Inkling, MiniMax M2.x |
| 240s | Variantes thinking do Claude Opus 4.x e 5.x |
| 180s | família qwen3, Claude Sonnet 5 / 4.5 / 4.6 |
O MiniMax M2.x é a entrada mais recente, e chegou por causa de três relatos de bugs reunidos no PR #121555: o M2.x faz stream de conteúdo de raciocínio antes do seu primeiro token de conteúdo e tinha sido observado a bloquear durante cerca de 240 segundos a meio do raciocínio — acima da predefinição de 180s, por isso estava a ser morto enquanto estava saudável.
O tamanho do contexto escala da mesma forma, porque um prompt de 100k tokens tem um primeiro token mais lento do que um de 2k: acima de 50k tokens estimados, o detetor de streaming sobe para pelo menos 240s; acima de 100k, para pelo menos 300s. O lado non-streaming tem os seus próprios patamares. Só as predefinições implícitas se movem — os seus números explícitos ficam intactos.
O run budget que uma chamada bloqueada conseguia ignorar
O agent.run_budget_seconds (ou hermes chat --run-budget 850 -q "...") existe para impedir que uma run autónoma gaste para sempre. Quando é definido, acontecem duas coisas: aos 80% do orçamento o agent recebe um aviso único de fecho a dizer-lhe para parar de explorar e produzir o resultado, e os timeouts de obsolescência implícitos passam a ter como teto metade do orçamento restante, com um mínimo de 60 segundos, para que uma única chamada silenciosamente bloqueada não possa engolir o resto da run.
O bug era a diferença entre a documentação e a implementação no caminho streaming: o teto aplicava-se às chamadas non-streaming, mas um stream bloqueado mantinha a sua janela de obsolescência completa, e o aviso de fecho não podia disparar enquanto uma chamada estivesse em curso. Uma run com um orçamento de 10 minutos e um stream de provider encravado podia passar do seu próprio prazo — o aviso era alcançável em teoria e inalcançável na prática. A correção encaminha ambos os resolvedores por um único cap_to_run_budget, para que os timeouts de obsolescência de streaming e non-streaming sejam calculados da mesma forma. Um detalhe assimétrico é deliberado: um HERMES_STREAM_STALE_TIMEOUT explícito é tratado como o seu prazo e nunca é limitado ao run budget, ao passo que os valores implícitos são.
Cron: a segunda chamada que ficou pendurada
A terceira correção no mesmo PR é a que explica uma classe de «o meu job agendado nunca termina». As chamadas Cron Codex corriam no caminho worker-thread e podiam bloquear na segunda chamada consecutiva de streaming — a primeira funcionava, a segunda esperava para sempre. As runs de cron (chat_completions e codex_responses) executam agora em linha e, mais importante, o caminho em linha recebe o mesmo mínimo de contexto grande e o mesmo teto rígido que o caminho worker recebia. Na medição citada no PR: numa sonda de 30k tokens, o caminho em linha permitia antes 90 segundos onde o worker permitia 600; agora ambos calculam 600, e com o teto rígido configurado em 300 ambos calculam 300.
Se corre automatização sem supervisão, esta é a alteração a conhecer: dois caminhos de código que deviam ter tido paciência idêntica, um dos quais era 6,7× menos paciente e podia encravar sem que nenhum timeout chegasse a disparar.
Qual botão ganha
Quando vários valores podem aplicar-se, a precedência é explícita e vale a pena aprendê-la uma vez:
- A configuração explícita ganha a qualquer mínimo implícito.
providers.<id>.stale_timeout_seconds(ouproviders.<id>.models.<model>.stale_timeout_seconds) é o prazo do operador: ganha aos patamares de tamanho de contexto e ao mínimo de raciocínio, e pode, por isso, encurtar a paciência para um stream bloqueado de propósito. - A predefinição de 180s é o único valor que é escalado e sujeito a mínimo. Deixe-a em paz e ganha o escalonamento por contexto e o mínimo do modelo de graça.
- O
HERMES_STREAM_STALE_TIMEOUTé um valor do utilizador. É respeitado tal como está, nunca limitado pelo run budget. - Os endpoints locais têm tetos finitos, não infinitos. O
agent.local_stream_stale_timeout(900s) aplica-se quando é detetado um endpoint local nos valores predefinidos implícitos — o antigo comportamento de «nunca expirar» fazia com que um servidor local encravado ficasse pendurado para sempre. - O
HERMES_STREAM_STALE_GIVEUP(predefinição 5, 0 desativa) é o disjuntor: depois desse número de mortes consecutivas por obsolescência sem nenhuma resposta concluída, cada nova chamada aborta imediatamente com um erro acionável em vez de esperar outra vez pelo timeout. Reinicia com qualquer resposta concluída, uma troca em/model, a ativação de um fallback, ou um turno novo.
Um exemplo a funcionar para um modelo de raciocínio auto-alojado que legitimamente pensa durante minutos:
providers:
  local-reasoning:
    stale_timeout_seconds: 900     # explícito: nunca escalado, nunca limitado
e para um provider de raciocínio na cloud em que confia, o movimento oposto — deixá-lo implícito para que o mínimo e os patamares de contexto o protejam:
agent:
  run_budget_seconds: 1800         # aviso de fecho aos 80%, tetos de obsolescência a metade do restante
Como saber o que matou a sua chamada
- Um corte com um retry que tem sucesso é normalmente o detetor de obsolescência a disparar durante uma fase longa de raciocínio — verifique se o seu modelo está na tabela de mínimos, e se já passou os 50k tokens de contexto.
- Cinco mortes consecutivas e depois um abort imediato é o disjuntor de giveup, não o provider: o texto do erro nomeia a sequência. Troque de modelo ou comece uma sessão nova; o contador reinicia na resposta concluída seguinte.
- Uma run que ignora o seu próprio orçamento era a lacuna do caminho de streaming — um sintoma que vale a pena voltar a testar em vez de contornar com um timeout maior.
- Um job de cron que bloqueia na sua segunda chamada de provider corresponde à correção de execução em linha deste lote.
O que foi lançado, e onde
As três correções estão no PR #121555, integradas a 2026-09-25 — depois de a tag v0.21.5 ser criada, por isso estão apenas em main e chegam com a próxima release ou com um hermes update que segue main. Se está a afinar timeouts neste momento, a estrutura de camadas acima já funciona hoje; são as duas lacunas de implementação que a correção fecha.
Leitura relacionada neste site: o artigo sobre a desconexão silenciosa cobre a versão ao nível do transporte do mesmo problema — ligações que parecem vivas e não estão — e o guia do watchdog de loop do gateway cobre a terceira camada, a que vigia o loop em vez de uma única chamada. Se o seu problema não é «bloqueia» mas «custa», o artigo sobre rastreio de custos é o próximo a ler.
O que retirar daqui
O silêncio precisa de um orçamento em cada camada, e o orçamento tem de ser honesto quanto ao que está a medir. Para modelos de raciocínio, a predefinição honesta é muito mais longa do que para modelos de conversa; para uma run sem supervisão, a predefinição honesta é o prazo da própria run. O padrão a levar para os seus próprios sistemas é o mesmo de aqui: escale os seus timeouts pelo que o silêncio significa — ainda sem evento, ainda sem conteúdo, ainda sem resposta, tarefa a correr há demasiado tempo — e garanta que todos os caminhos de código que podem esperar usam os mesmos patamares. Um caminho que espera 90 segundos em silêncio onde o seu irmão espera 600 não é uma diferença de afinação; é um bug com cronómetro.