一台机器一个网关:multiplex-only 迁移、三个真实事故与自查清单
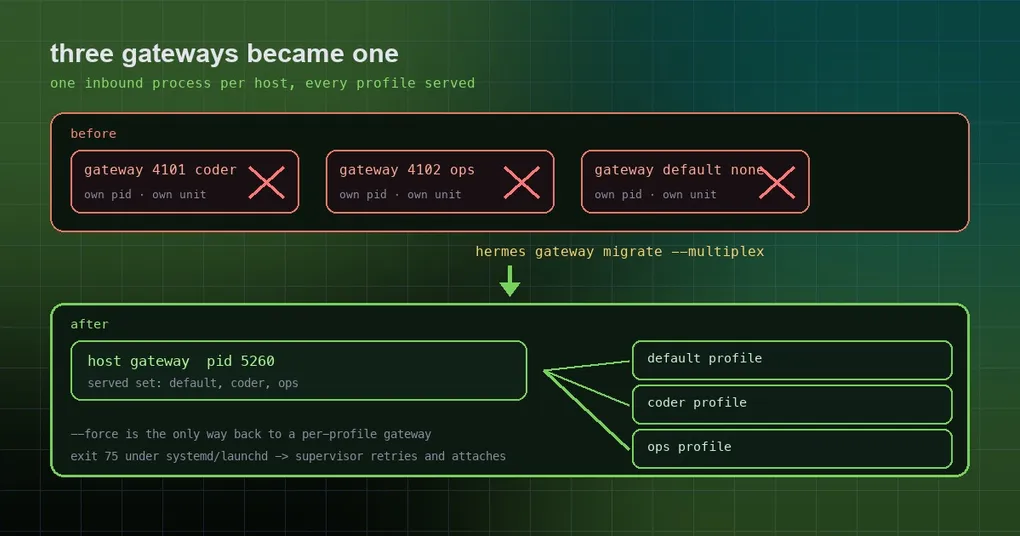
你在一台小机器上跑着三个 Hermes:一个私人的、一个写代码的、一个盯线上告警的。以前升级完你习惯性地敲 hermes -p coder gateway restart,心里清楚它只会动 coder 那一个进程。上周升级到 v0.21.4 之后,这条命令的含义变了——它现在管的是“这台机器上唯一那个网关”,而那个网关同时在服务另外两个 profile。如果你想在升级前搞清楚自己踩在什么上面,这篇文章把新拓扑、迁移命令、它会拒绝的场景,以及这次收敛顺带修掉的三个真实事故讲清楚。
新规则:每台机器、每个 OS 用户,只有一个 hermes gateway run
架构指令很直白:multiplex-only。一台机器上只有一个网关进程在接收平台消息,它服务 profiles/ 下的每一个 profile。这不是“推荐配置”,而是 v0.21.4 起实际生效的拓扑:hermes gateway migrate --multiplex 会把旧拓扑收敛过来,而新建命名 profile 已经不能自己装一个独立网关了(详见下面“被挡住的情况”)。
随之改变的是每个生命周期动词的语义。核心逻辑叫 attach → rescan → refuse:永远不启动第二个进程。
hermes -p X gateway run,X 已被服务:打印宿主网关的 PID 与被服务的 profile 集合,退出码 0,不派生任何进程。hermes -p X gateway run,X 尚未被服务:通过控制套接字请宿主网关重新扫描profiles/,扫到 X 之后附着上去,退出码 0。- 宿主网关无法服务 X(比如凭据冲突):拒绝并给出原因,退出码 78;如果宿主“活着但不应答”这种暂时性情况,退出码 75,让 supervisor 稍后重试。
hermes gateway start --all/restart --all:指的是那一个宿主多路复用器。它们不会再扫掉正在跑的网关进程;某个 profile 还抱着自己的网关时,只会被报告出来并附上迁移命令的一行提示。- 被服务的次级 profile 上执行
hermes gateway stop:不再是“这个 profile 没有网关在跑”(退出 0),而是点名宿主进程并让你去停宿主网关,退出码 78。 hermes gateway run --replace:由实际被服务的集合决定归属,谁启动的就由谁接管宿主角色;--force则是“别问宿主,直接起一个独立网关”的逃生门(用于宿主卡死或回答异常时)。
一个容易忽略的细节:在 systemd / launchd / s6 这类 supervisor 下,附着路径的退出码是 75 而不是 0——因为 75 会被这三家在一个短延迟后重启,于是那个 unit 会一直重试,等到宿主进程消失的那一刻自动接管。
迁移:先看计划,再让它自己续跑
从旧拓扑(每个 profile 一个进程/一个 unit)升级上来的机器,标准动作是两步:
hermes gateway migrate --multiplex --dry-run   # 只打印计划、阻塞项和将要发生的重启
hermes gateway migrate --multiplex             # 收敛;非交互环境加 --yes
--dry-run 的输出会把每个 profile 的网关 PID 与服务类型列成一张表,然后逐条列出它将做什么,例如“coder: stop pid 4101 + uninstall systemd (user)”、“default: 在 config.yaml 写入 gateway.multiplex_profiles: true”、“default: 通过 systemd 启动网关并验证它服务 3 个 profile”,最后一行告诉你会把迁移前的状态记到 ~/.hermes/gateway_migration.json。它不会静默 SIGTERM 你的网关:计划里会明确写出“这一步会终止 coder (pid 4101)、ops (pid 4102)”,两个进程会先把在途回合排干再退出。
有两点设计值得记住,因为它们决定了你出问题时该怎么处理:
- 收敛由拓扑定义,不由配置开关定义。 一个“已经收敛”的宿主 = 没有任何次级 profile 还拥有网关进程或 supervisor unit。旧实现只看“开关打开了没”,于是“开关翻了、unit 还在、中间崩了一次”这种半迁移机器会被判定为 already multiplexed——最需要这条命令的机器反而什么都不做。现在开关本身永远不满足收敛条件,所以重跑这条命令就是恢复手段。
- manifest 就是续跑记录:文件在 = 没做完。 命令发现磁盘上已有 manifest 时会从它续跑,而不是覆盖它(它是“当时存在哪些 unit”的唯一记录)。确认收敛后才清掉。
迁移覆盖 systemd(user 与 system,移除 unit 前会先读 User=)、launchd,以及 Windows 计划任务——Windows 过去是“不支持自动迁移,请手工操作”,现在会同时处理任务和 gateway install 在无法注册任务时写下的启动文件夹入口(只删任务会留下那个 fallback,下次登录再拉起一个网关)。s6 容器仍然拒绝迁移,而且是对的:那里的 per-profile 网关是容器自己的启动流程注册的槽位,收敛属于那次启动的事。
三个真实事故:为什么必须“一个后端只服务它自己的 profile”
这次收敛之所以是 P1 级别的工作,是因为“一个后端服务多个 profile”会放大一类非常隐蔽的 bug。窗口里修掉的三个都有名有姓:
其一,REST 路由会改错 profile 的数据。 在一个后端服务所有 profile 的前提下,有一批 REST handler 直接读进程的 get_hermes_home(),完全忽略请求里点名的 profile。后果不是“读错”,而是删错:POST /api/memory/reset?profile=worker_beta 删掉的是启动 profile 的 memories/MEMORY.md 和 USER.md,worker_beta 毫发无损。同类的还有删除 webhook 订阅、删除 ops hook(顺带吊销启动 profile 的授权)、清理 checkpoints、导入备份(会覆盖启动 profile)、删除凭据池里的一项、以及运行 curator(对启动 profile 的技能目录做归档/改写)。现在每条路由都尊重它被给予的 profile,并且破坏性路由在多元 profile 环境下收到不带 profile 的请求时直接返回 400,而不是“随便挑一个”。
其二,命名 profile 变成了“凭据孤岛”。 一个更早的改动让每个命名 profile 只读自己的 auth.json,于是升级后桌面端的 bot 开始报 No Codex credentials stored. Run hermes -p <bot> auth add openai-codex --type oauth ——而根 profile 明明登录着。现在命名 profile 重新解析根 profile 的 OAuth 登录,同时保留 profile 自己的凭据作用域。
其三,桌面端为每个 profile 起一个后端。 桌面应用过去会给每个 profile 拉一个 hermes serve,在多 profile 机器上就是一堆后端进程和一堆重复的 MCP 启动。现在桌面端附着到运行中的宿主后端(这条改动依赖“REST 路由尊重 profile”先落地——顺序反了会把未定域的破坏性调用打到主 profile 的家目录,PR 里专门写了这条依赖)。
顺带一提,升级流程也跟着收敛了:hermes -p coder update 和 hermes -p writer update 现在合计只重启一次宿主网关,重启通知会送达每个被服务的 profile。
存储侧的收尾:hermes sessions set-journal-mode
同一波工作(跟踪 issue #109417,累计 70 多个 PR)里还有一个自服务命令,负责把 state.db 在 WAL 与 DELETE 日志模式之间离线转换:
hermes sessions set-journal-mode delete                          # WAL -> rollback journal
hermes sessions set-journal-mode wal                             # 改回 WAL
hermes sessions set-journal-mode delete --db ~/.hermes/kanban.db # 其他 Hermes 存储关键前提:Hermes 永远不会在打开数据库时现场降级 WAL(网关/cron/worker 可能握着未 checkpoint 的提交,现场降级会毁掉它们),所以配置里的 database.journal_mode: delete 对已存在的 WAL 库一直是“不生效 + 打一行 ERROR”。这条命令的准入条件就是“没有任何进程持着这个文件”:扫描到持有者会逐个列出 pid — 命令: 路径 并拒绝执行;转换时不等待任何 opener(中途出现的进程会让 SQLite 直接拒绝,而不是和它赛跑);转换后回读文件头字节确认模式。它还会在配置与新模式不一致时提醒你去改配置——因为下一次打开会重新应用配置值。
升级后自查清单
hermes version                                  # 期望 v0.21.4(tag v2026.9.21)
hermes gateway status                           # 谁在服务哪些 profile
hermes gateway migrate --multiplex --dry-run    # 从旧拓扑升上来的必看:计划 + 阻塞项
hermes -p coder gateway run                     # 应该附着并打印宿主 PID,而不是起第二个进程
hermes doctor # 存储与网关拓扑的告警在这里另外两个值得知道的行为:迁移之后新建的 profile 会被运行中的多路复用器自动服务(它在 profile 创建/删除时重扫 profiles/,平时每 30 秒扫一次,实测约 0.5 秒生效);显式写 gateway.multiplex_profiles: true 的机器永远不会被 preflight 二次判断(你或迁移做的决定就是决定),而环境变量 GATEWAY_MULTIPLEX_PROFILES 也能按同样方式覆盖“未设置”时的自动判断。
被挡住的情况:什么时候还需要 --force
多路复用默认开启,但“未设置”是对宿主网关的一次请求,不是判决书。每次启动它都会跑与迁移相同的 preflight:至少两个 profile、没有次级 profile 还跑着自己的网关(活进程或已安装的 unit 都算)、没有重复的 bot 凭据、没有缺少 /p/<profile>/ 入口的端口绑定类平台、并且是迁移能理解的主机类型。任何一条不满足,它就照旧只服务默认 profile 并打印阻塞项和迁移命令——磁盘上什么都不动,等阻塞消失后自己收敛。
真正需要 --force 的情况只剩两类:跨 UNIX 用户的 fleet,以及 HERMES_HOME 不在 profiles/ 目录下(unix 之外的树外布局)。命名 profile 的 hermes -p <name> gateway install / start / run 在没有 --force 时一律退出 78,并指向默认 profile 的 hermes gateway install 或迁移命令;只有已经用 --force 装过 unit 的机器才允许后续 gateway start 继续找到它。
小结
这次收敛的价值不在“少一个进程”,而在边界:一个后端只服务一个 profile 意味着凭据、记忆、会话、钩子、cron 都必须按 profile 定域,任何一个漏掉都会变成“删错数据”或“读错密钥”。所以如果你的机器上有两个以上 profile,升级后第一件事是 --dry-run 看计划,第二件事是跑一遍上面的自查清单。想先看这个版本整体改了什么,可以读 v0.21.4 都带了什么;网关本身的历史与命令细节在 hermes gateway 命令参考 和 多路复用 profile 默认开启 里。