Um gateway por host: a migração multiplex-only, três incidentes reais e uma checklist pós-atualização
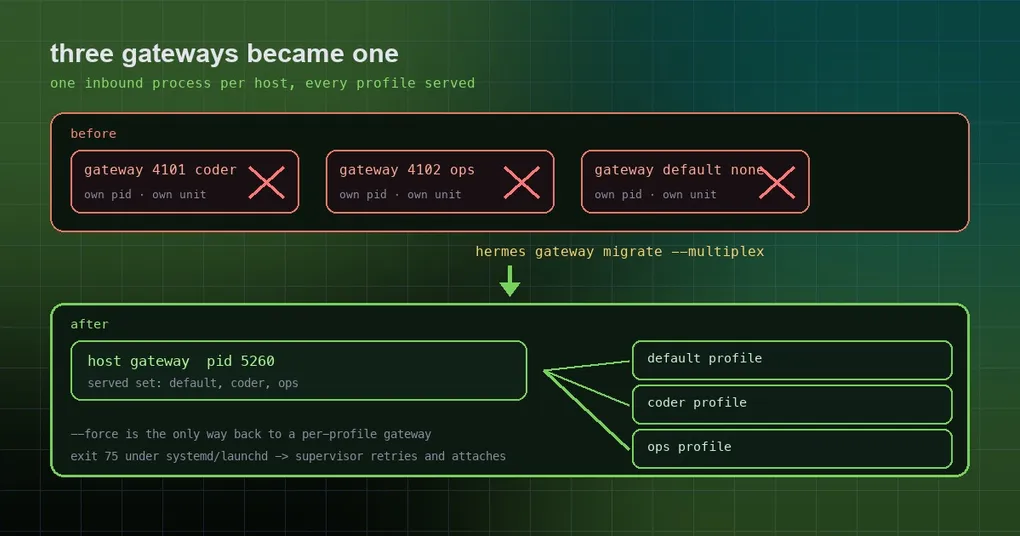
Você roda três agentes Hermes numa máquina pequena: um pessoal, um de código e um vigiando alertas de produção. Depois de cada atualização você digitava hermes -p coder gateway restart sem pensar, porque sabia que aquilo tocava exatamente um processo. Desde a v0.21.4 esse comando significa outra coisa: ele agora mira o único gateway desta máquina, e esse gateway está servindo os outros dois profiles ao mesmo tempo. Se você prefere saber sobre o que está pisando antes de atualizar, aqui estão a nova topologia, o comando de migração, o que ele recusa e os três incidentes reais que a convergência limpou pelo caminho.
A nova regra: um hermes gateway run por host, por usuário do SO
A diretriz de arquitetura é direta: multiplex-only. Um processo de gateway por máquina recebe as mensagens das plataformas, e ele serve todos os profiles sob profiles/. Isto não é uma recomendação — é a topologia entregue a partir da v0.21.4. hermes gateway migrate --multiplex converge uma máquina antiga para ela, e um profile nomeado recém-criado não consegue mais instalar um gateway próprio (veja o caso forçado abaixo).
O que mudou junto foi o significado de cada verbo de ciclo de vida. A função de decisão é attach → rescan → refuse, e a regra é que um segundo processo nunca é iniciado:
hermes -p X gateway runcom X sendo servido: imprime o PID do gateway do host e o conjunto servido, sai com 0, não gera nada.hermes -p X gateway runcom X não sendo servido: pede ao gateway do host, pelo seu socket de controle, para reescanearprofiles/, e então se anexa quando a resposta inclui X. Exit 0.- O dono não consegue servir X (digamos, uma credencial duplicada): recusa com o motivo, sai com 78. Uma recusa transitória — dono vivo mas silencioso — sai com 75 para que um supervisor tente de novo.
hermes gateway start --all/restart --allsignificam aquele único multiplexador de host. Eles não varrem mais processos de gateway em execução; um profile que ainda segura o próprio gateway é reportado, nunca morto, com o one-linerhermes gateway migrate --multiplexanexado.hermes gateway stopnum secundário servido não é mais “nenhum gateway rodando para este profile” com exit 0 — ele nomeia o processo do host e manda você parar aquele em vez disso, exit 78.hermes gateway run --replacedecide pelo conjunto servido ao vivo: o profile que lançou o processo assume o papel de host.--forceé a saída de emergência que inicia um gateway separado sem perguntar nada ao dono.
Um detalhe que morde as pessoas: sob um supervisor, o caminho de attach sai com 75, não 0. systemd, launchd e s6 reiniciam um 75 depois de um pequeno atraso, então a unit continua tentando e assume sozinha no momento em que o processo do host desaparece.
Migrando: leia o plano, depois deixe ele retomar sozinho
Numa máquina atualizada de uma topologia por profile, o movimento padrão são dois comandos:
hermes gateway migrate --multiplex --dry-run   # imprime o plano, os bloqueadores e os reinícios que ele implica
hermes gateway migrate --multiplex             # converge (adicione --yes em shells não interativos)
O dry run lista o PID do gateway e o tipo de serviço de cada profile como uma tabela, depois detalha o que vai fazer — parar o pid 4101 e desinstalar a unit systemd (user) do coder, definir gateway.multiplex_profiles: true no config.yaml do profile default, iniciar o gateway e verificar que ele serve três profiles — e registra o estado anterior em ~/.hermes/gateway_migration.json. Ele nunca dá SIGTERM num gateway em silêncio: o plano diz quais processos serão terminados, e eles drenam os turnos em andamento antes de sair.
Duas decisões de design valem ser lembradas, porque decidem o que você faz quando algo dá errado:
- A convergência é definida pela topologia, não pela flag de configuração. Uma máquina convergida não tem nenhum profile secundário dono de um processo de gateway nem de uma unit de supervisor. A checagem antiga só perguntava “a flag está ligada?”, então uma máquina meio-migrada — flag trocada, unit deixada para trás, um crash no meio — era reportada como já multiplexada, e o comando não fazia nada exatamente na máquina que precisava dele. Agora a flag sozinha nunca satisfaz a checagem, o que significa que rodar o comando de novo é a recuperação.
- O manifest é o registro de retomada: presente significa inacabado. Quando o comando encontra um em disco, ele retoma a partir dele em vez de sobrescrevê-lo (é o único registro de quais units existiram), e só uma convergência confirmada o apaga.
A migração cobre systemd (user e system, lendo User= antes de remover a unit), launchd e Tarefas Agendadas do Windows — o Windows antes era uma recusa seca, com instruções para fazer na mão, e agora também limpa a entrada da pasta Startup que o gateway install escreve quando não consegue registrar uma tarefa (remover só a tarefa deixaria aquele fallback lançando um segundo gateway no próximo logon). Contêineres s6 continuam sendo recusados, corretamente: ali os gateways por profile são slots que o próprio boot do contêiner registra, então a dobra pertence àquele boot.
Três incidentes reais: por que um backend deve servir um profile
Esta convergência é trabalho de P1 porque “um backend, muitos profiles” amplifica uma classe de falha muito silenciosa. Três instâncias caíram nesta janela, com nomes anexados.
Primeiro, rotas REST mutavam os dados do profile errado. Com um backend servindo todo mundo, um punhado de handlers lia o get_hermes_home() do processo e ignorava o profile que a requisição nomeava. O resultado não era uma leitura errada, mas uma exclusão errada: POST /api/memory/reset?profile=worker_beta removeu o memories/MEMORY.md e o USER.md do profile de lançamento, enquanto o worker_beta ficou intacto. A mesma forma cobria excluir uma assinatura de webhook, excluir um hook de operações (que também revogava o consentimento do profile de lançamento), podar checkpoints, importar um backup por cima do profile de lançamento, excluir uma entrada do pool de credenciais e rodar o curator contra as skills do profile de lançamento. Agora toda rota honra o profile que lhe é dado, e as destrutivas retornam 400 quando uma requisição não nomeia nenhum profile num host multi-profile, em vez de escolher um.
Segundo, profiles nomeados viraram ilhas de credenciais. Uma mudança anterior fez todo profile nomeado ler apenas o seu próprio auth.json, então depois de uma atualização os bots do Desktop começaram a falhar com No Codex credentials stored. Run hermes -p <bot> auth add openai-codex --type oauth enquanto o profile raiz estava logado. Profiles nomeados agora resolvem de novo o login OAuth do profile raiz, mantendo o próprio escopo de credenciais.
Terceiro, o Desktop iniciava um backend por profile. O app costumava gerar um hermes serve para cada profile — uma pilha de processos de backend e boot de MCP duplicado numa máquina multi-profile. O Desktop agora se anexa ao backend do host em execução. Essa mudança depende explicitamente de as rotas REST cientes de profile entrarem primeiro: com a ordem invertida, o colapso envia chamadas destrutivas sem escopo para o diretório home do primário, e o PR diz isso.
O caminho de atualização também convergiu: hermes -p coder update e hermes -p writer update agora reiniciam o gateway do host uma vez entre eles, e o aviso de reinício chega a todos os profiles servidos.
A metade de armazenamento: hermes sessions set-journal-mode
A mesma campanha (issue de acompanhamento #109417, mais de 70 PRs nela) adicionou um comando self-service para converter o state.db entre os modos de journal WAL e DELETE offline:
hermes sessions set-journal-mode delete                          # WAL -> rollback journal
hermes sessions set-journal-mode wal                             # de volta para WAL
hermes sessions set-journal-mode delete --db ~/.hermes/kanban.db # outro store do Hermes
A premissa importa: o Hermes nunca faz downgrade ao vivo de um banco WAL na abertura — o gateway, o cron ou um worker podem segurar commits não checkpointados, e um downgrade por baixo deles destrói esses commits. Então um database.journal_mode: delete configurado contra um store WAL já existente sempre significou “não aplicado, um ERROR por processo”. O teste de admissão do comando é simplesmente “nenhum processo segura o arquivo”: ele lista cada detentor como pid — comando: caminho e recusa caso contrário, troca o modo sem esperar pelos openers (um que apareça no meio faz o SQLite recusar, em vez de correr), e relê os bytes do cabeçalho para confirmar o modo. Ele te lembra de alinhar o database.journal_mode quando a configuração discorda, porque a próxima abertura reaplica o valor configurado.
Checklist pós-atualização
hermes version                                  # esperado v0.21.4 (tag v2026.9.21)
hermes gateway status                           # quem serve quais profiles
hermes gateway migrate --multiplex --dry-run    # atualizações de uma topologia por profile: plano + bloqueadores
hermes -p coder gateway run                     # deve se anexar e imprimir o PID do host, não gerar um segundo processo
hermes doctor                                   # avisos de storage e topologia de gateway aparecem aqui
Mais dois comportamentos que vale conhecer: profiles criados depois da migração são servidos automaticamente pelo multiplexador em execução (ele reescaneia profiles/ na criação e na exclusão, e a cada 30 segundos no resto do tempo — cerca de meio segundo na prática), e um host com gateway.multiplex_profiles: true explícito nunca é questionado pelo preflight de boot — a sua decisão, ou a da migração, prevalece. A variável de ambiente GATEWAY_MULTIPLEX_PROFILES sobrescreve a decisão de chave não definida da mesma forma.
O caso forçado: quando --force ainda está correto
O multiplexing está ligado por padrão, mas uma flag não definida é um pedido que o gateway do host resolve no boot, não um veredito. Cada start roda o mesmo preflight da migração: dois ou mais profiles, nenhum secundário ainda rodando o próprio gateway (um processo vivo ou uma unit instalada contam os dois), nenhuma credencial de bot duplicada, nenhuma plataforma com bind de porta sem um ingress /p/<profile>/, e um tipo de host que a migração entende. Se qualquer checagem falhar, ele sobe exatamente como antes, servindo só o profile default, registrando o bloqueador e o one-liner de migração — e sem mudar nada em disco, convergindo sozinho quando o bloqueador sumir.
Isso deixa exatamente duas situações em que --force é a resposta certa: uma frota dividida entre usuários UNIX, e um HERMES_HOME fora de profiles/. Para um profile nomeado, hermes -p <name> gateway install, start e run saem todos com 78 sem --force e apontam para o hermes gateway install do profile default ou para o comando de migração; só uma máquina que já instalou uma unit com --force continua alcançando-a a partir de um simples gateway start.
A versão curta
O valor desta convergência não é “um processo a menos” — é a fronteira. Um backend servindo um profile significa que credenciais, memória, sessões, hooks e cron têm todos de ser escopados por profile, e cada um que passa batido vira dado excluído ou chave vazada. Então, se a sua máquina roda mais de um profile: rode o dry run depois de atualizar e depois percorra a checklist acima. Para o panorama mais amplo do que mais mudou neste tag, leia o que a v0.21.4 realmente entregou; para a superfície do gateway em si, veja a referência do comando hermes gateway e o guia anterior, multiplex por padrão.