Un seul gateway par hôte : la migration multiplex-only, trois incidents réels et une checklist d'après mise à niveau
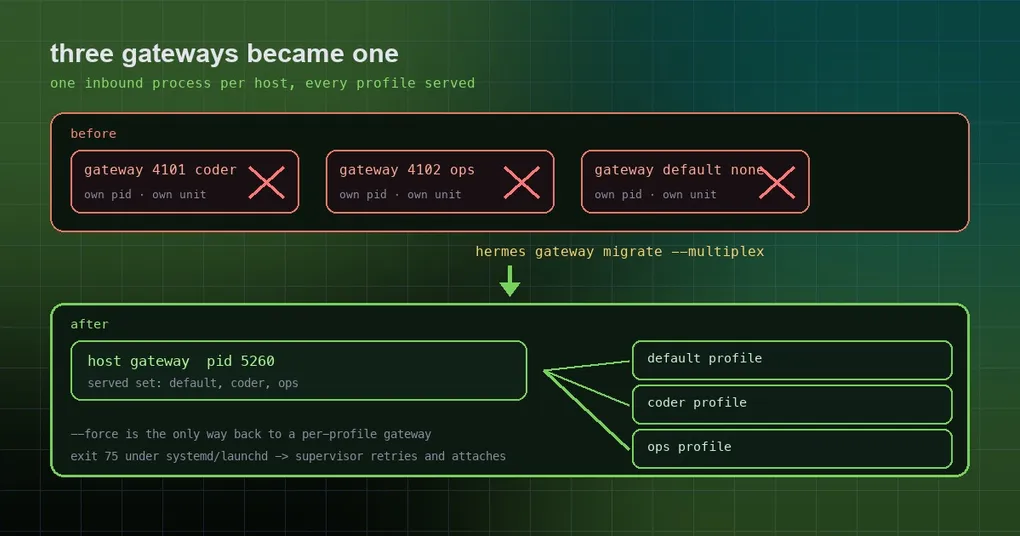
Vous faites tourner trois agents Hermes sur une petite machine : un personnel, un pour le code, et un qui surveille les alertes de production. Après chaque mise à jour, vous tapiez hermes -p coder gateway restart sans réfléchir, parce que vous saviez que la commande ne touchait qu’un seul processus. Depuis la v0.21.4, cette commande veut dire autre chose : elle vise désormais l’unique gateway de cette machine, et ce gateway sert les deux autres profiles en même temps. Si vous préférez savoir sur quoi vous vous appuyez avant de monter en version, voici la nouvelle topologie, la commande de migration, ce qu’elle refuse, et les trois incidents réels que la convergence a nettoyés au passage.
La nouvelle règle : un seul hermes gateway run par hôte et par utilisateur OS
La directive d’architecture est sans détour : multiplex-only. Un seul processus gateway par machine reçoit les messages des plateformes, et il sert tous les profiles sous profiles/. Ce n’est pas une recommandation — c’est la topologie livrée à partir de la v0.21.4. hermes gateway migrate --multiplex y fait converger une machine plus ancienne, et un profile nommé fraîchement créé ne peut plus installer son propre gateway (voir le cas forcé plus bas).
Ce qui a changé avec elle, c’est le sens de chaque verbe de cycle de vie. La logique de décision se lit dans cet ordre : rattacher → re-scanner → refuser, avec pour règle qu’aucun second processus n’est jamais lancé :
hermes -p X gateway runalors que X est servi : affiche le PID du gateway hôte et l’ensemble servi, sort avec le code 0, ne lance rien.hermes -p X gateway runalors que X n’est pas servi : demande au gateway hôte, via sa socket de contrôle, de re-scannerprofiles/, puis se rattache dès que la réponse inclut X. Code de sortie 0.- Le propriétaire ne peut pas servir X (des credentials en doublon, par exemple) : refus avec la raison, code de sortie 78. Un refus transitoire — propriétaire vivant mais silencieux — sort avec le code 75, pour qu’un superviseur retente.
hermes gateway start --all/restart --alldésignent l’unique multiplexeur de l’hôte. Ils ne balayent plus les processus gateway en cours ; un profile qui détient encore son propre gateway est signalé, jamais tué, avec la commandehermes gateway migrate --multiplexen une ligne.hermes gateway stopsur un profile secondaire servi n’est plus un « aucun gateway en cours pour ce profile » avec code 0 : la commande nomme le processus hôte et vous invite à arrêter celui-ci, code 78.hermes gateway run --replacetranche selon l’ensemble servi en direct : le profile qui a lancé le processus reprend le rôle hôte.--forceest la porte de sortie qui démarre un gateway séparé sans même demander au propriétaire.
Un détail qui fait trébucher : sous un superviseur, le chemin de rattachement sort avec 75, pas 0. systemd, launchd et s6 relancent tous un 75 après un court délai, si bien que l’unité continue de réessayer et prend la main d’elle-même à l’instant où le processus hôte disparaît.
Migrer : lisez le plan, puis laissez-le reprendre tout seul
Sur une machine mise à niveau depuis une topologie par profile, le geste standard tient en deux commandes :
hermes gateway migrate --multiplex --dry-run   # affiche le plan, les blocages et les redémarrages qu'il implique
hermes gateway migrate --multiplex             # fait converger (ajoutez --yes dans un shell non interactif)
Le dry run liste sous forme de tableau le PID et le type de service du gateway de chaque profile, puis détaille ce qu’il va faire — arrêter le pid 4101 et désinstaller l’unité systemd (user) de coder, écrire gateway.multiplex_profiles: true dans le config.yaml du profile par défaut, démarrer le gateway et vérifier qu’il sert trois profiles — et consigne l’état précédent dans ~/.hermes/gateway_migration.json. Il ne SIGTERM jamais un gateway en silence : le plan dit quels processus seront terminés, et ceux-ci achèvent leurs tours en cours avant de sortir.
Deux décisions de conception méritent d’être retenues, parce qu’elles déterminent ce que vous faites quand quelque chose tourne mal :
- La convergence se définit par la topologie, pas par le drapeau de configuration. Un hôte convergé n’a aucun profile secondaire propriétaire d’un processus gateway ni d’une unité de superviseur. L’ancienne vérification demandait seulement « le drapeau est-il actif ? », si bien qu’un hôte à moitié migré — drapeau basculé, unité laissée derrière, plantage entre les deux — se déclarait déjà multiplexé, et la commande ne faisait rien sur précisément la machine qui en avait besoin. Désormais le drapeau seul ne satisfait jamais la vérification, ce qui signifie que relancer la commande est la procédure de reprise.
- Le manifeste est l’enregistrement de reprise : présent, il veut dire travail inachevé. Quand la commande en trouve un sur le disque, elle reprend à partir de lui au lieu de l’écraser (c’est le seul témoin des unités qui existaient), et seule une convergence confirmée l’efface.
La migration couvre systemd (user et système, en lisant User= avant de retirer l’unité), launchd et les tâches planifiées Windows — Windows était auparavant un refus net avec des instructions pour le faire à la main ; il nettoie désormais aussi l’entrée du dossier Startup qu’écrit gateway install quand il ne parvient pas à enregistrer de tâche (supprimer la seule tâche laisserait ce repli lancer un second gateway à la prochaine ouverture de session). Les conteneurs s6 restent refusés, à juste titre : les gateways par profile y sont des emplacements enregistrés par le boot du conteneur lui-même, donc le regroupement appartient à ce boot.
Trois incidents réels : pourquoi un backend ne doit servir qu’un profile
Cette convergence relève du P1 parce que « un backend, plusieurs profiles » amplifie une classe de pannes très discrète. Trois cas se sont concrétisés dans cette fenêtre, avec des noms.
Premier cas : les routes REST modifiaient les données du mauvais profile. Avec un backend qui sert tout le monde, une poignée de handlers lisait le get_hermes_home() du processus et ignorait le profile nommé par la requête. Le résultat n’était pas une mauvaise lecture mais une mauvaise suppression : POST /api/memory/reset?profile=worker_beta supprimait le memories/MEMORY.md et le USER.md du profile de lancement, tandis que worker_beta restait intact. Le même schéma couvrait la suppression d’un abonnement webhook, la suppression d’un hook d’ops (qui révoquait en outre le consentement du profile de lancement), l’élagage des checkpoints, l’import d’une sauvegarde par-dessus le profile de lancement, la suppression d’une entrée du pool de credentials, et l’exécution du curator sur les skills du profile de lancement. Chaque route honore désormais le profile qu’on lui donne, et les routes destructrices renvoient 400 quand une requête ne nomme aucun profile sur un hôte multi-profile, au lieu d’en choisir un.
Deuxième cas : les profiles nommés sont devenus des îlots de credentials. Un changement antérieur avait fait que chaque profile nommé ne lisait que son propre auth.json, si bien qu’après une mise à jour les bots du desktop échouaient avec No Codex credentials stored. Run hermes -p <bot> auth add openai-codex --type oauth, alors que le profile racine était connecté. Les profiles nommés relisent maintenant la connexion OAuth du profile racine, tout en conservant leur propre périmètre de credentials.
Troisième cas : le desktop lançait un backend par profile. L’application créait autrefois un hermes serve pour chaque profile — un paquet de processus backend et un boot MCP dupliqué sur une machine multi-profile. Le desktop se rattache désormais au backend hôte en cours d’exécution. Ce changement dépend explicitement de l’arrivée préalable des routes REST conscientes du profile : dans l’ordre inverse, l’effondrement envoie des appels destructeurs sans périmètre dans le répertoire personnel du profile primaire, et la PR le dit.
Le chemin de mise à jour a convergé lui aussi : hermes -p coder update et hermes -p writer update ne redémarrent plus le gateway hôte qu’une seule fois à eux deux, et la notification de redémarrage atteint chaque profile servi.
La moitié stockage : hermes sessions set-journal-mode
La même campagne (issue de suivi #109417, plus de 70 PR) a ajouté une commande en libre-service pour convertir state.db entre les modes journal WAL et DELETE, hors ligne :
hermes sessions set-journal-mode delete                          # WAL -> journal rollback
hermes sessions set-journal-mode wal                             # retour au WAL
hermes sessions set-journal-mode delete --db ~/.hermes/kanban.db # un autre stockage Hermes
La prémisse compte : Hermes ne rétrograde jamais une base WAL à l’ouverture — le gateway, le cron ou un worker peuvent détenir des commits non checkpointés, et une rétrogradation sous leurs pieds les détruit. Une configuration database.journal_mode: delete face à un stockage déjà en WAL signifiait donc toujours « non appliqué, une ERROR par processus ». Le test d’admission de la commande est simple — « aucun processus ne détient le fichier » : elle liste chaque détenteur sous la forme pid — command: path et refuse dans le cas contraire, bascule le mode sans attendre la disparition des ouvreurs (un processus qui apparaît en cours de route fait échouer SQLite plutôt que de créer une course), puis relit les octets d’en-tête pour confirmer le mode. Elle vous rappelle d’aligner database.journal_mode quand la configuration n’est pas d’accord, car la prochaine ouverture réapplique la valeur configurée.
Checklist d’après mise à niveau
hermes version                                  # attendez-vous à v0.21.4 (tag v2026.9.21)
hermes gateway status                           # qui sert quels profiles
hermes gateway migrate --multiplex --dry-run    # mise à niveau depuis une topologie par profile : plan + blocages
hermes -p coder gateway run                     # doit se rattacher et afficher le PID hôte, pas lancer un second processus
hermes doctor                                   # les avertissements stockage et topologie gateway remontent ici
Deux comportements de plus à connaître : les profiles créés après la migration sont servis automatiquement par le multiplexeur en cours d’exécution (il re-scanne profiles/ à la création et à la suppression, et toutes les 30 secondes sinon — environ une demi-seconde en pratique), et un hôte portant un gateway.multiplex_profiles: true explicite n’est jamais contredit par le pré-vol de démarrage — votre décision, ou celle de la migration, tient. La variable d’environnement GATEWAY_MULTIPLEX_PROFILES surcharge de la même manière la décision prise sur une clé non définie.
Le cas forcé : quand --force reste la bonne réponse
Le multiplexage est actif par défaut, mais un drapeau non défini est une demande que le gateway hôte tranche au démarrage, pas un verdict. Chaque démarrage exécute le même pré-vol que la migration : au moins deux profiles, aucun profile secondaire faisant encore tourner son propre gateway (un processus vivant ou une unité installée comptent tous les deux), aucun credential de bot en doublon, aucune plateforme à liaison de port sans entrée /p/<profile>/, et un type d’hôte que la migration comprend. Si un contrôle échoue, le gateway démarre exactement comme avant, ne servant que le profile par défaut, journalise le blocage et la commande de migration en une ligne — et ne change rien sur le disque, convergeant de lui-même une fois le blocage levé.
Cela laisse exactement deux situations où --force est la bonne réponse : une flotte répartie sur plusieurs utilisateurs UNIX, et un HERMES_HOME en dehors de profiles/. Pour un profile nommé, hermes -p <name> gateway install, start et run sortent tous avec le code 78 sans --force et vous renvoient au hermes gateway install du profile par défaut ou à la commande de migration ; seule une machine ayant déjà installé une unité avec --force continue de l’atteindre par un simple gateway start.
En résumé
La valeur de cette convergence n’est pas « un processus de moins » — c’est la frontière. Un backend servant un seul profile signifie que credentials, mémoire, sessions, hooks et cron doivent tous être cadrés par profile, et chaque oubli se transforme en données supprimées ou en clé divulguée. Donc si votre machine fait tourner plus d’un profile : lancez le dry run après la mise à niveau, puis déroulez la checklist ci-dessus. Pour la vue d’ensemble des autres changements de ce tag, lisez ce que la v0.21.4 a réellement livré ; pour la surface gateway elle-même, voyez la référence de la commande hermes gateway et le précédent guide du multiplex activé par défaut.