Un gateway por host: la migración a multiplex-only, tres incidentes reales y una checklist posterior a la actualización
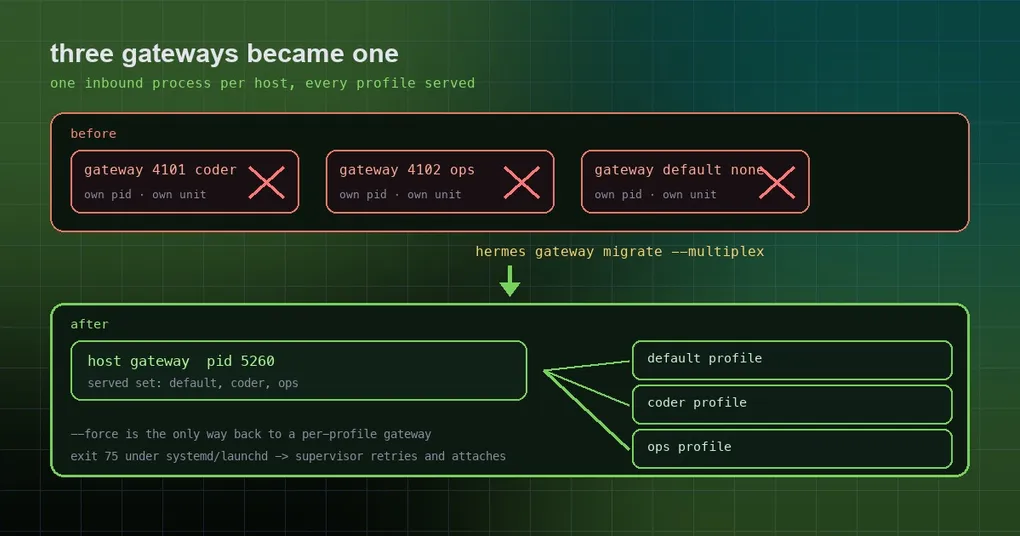
Ejecutas tres agentes de Hermes en una máquina pequeña: uno personal, uno de código y uno vigilando alertas de producción. Después de cada actualización escribías hermes -p coder gateway restart sin pensar, porque sabías que tocaba exactamente un proceso. Desde v0.21.4 ese comando significa otra cosa: ahora apunta al único gateway de esta máquina, y ese gateway está sirviendo a los otros dos profiles al mismo tiempo. Si prefieres saber sobre qué estás parado antes de actualizar, aquí tienes la nueva topología, el comando de migración, qué rechaza y los tres incidentes reales que la convergencia limpió por el camino.
La nueva regla: un hermes gateway run por host y por usuario del sistema operativo
La directiva de arquitectura es tajante: multiplex-only. Un proceso de gateway por máquina recibe los mensajes de las plataformas y sirve todos los profiles bajo profiles/. No es una recomendación: es la topología que se envía desde v0.21.4. hermes gateway migrate --multiplex converge una máquina antigua hacia ella, y un profile con nombre recién creado ya no puede instalar un gateway propio (ver el caso forzado más abajo).
Lo que cambió con ella es el significado de cada verbo de ciclo de vida. La función de decisión es attach → rescan → refuse, y la regla es que nunca se arranca un segundo proceso:
hermes -p X gateway runcon X servido: imprime el PID del gateway del host y el conjunto servido, sale con 0, no arranca nada.hermes -p X gateway runcon X no servido: pide al gateway del host, por su socket de control, que vuelva a escanearprofiles/, y luego se engancha cuando la respuesta incluye X. Sale con 0.- El propietario no puede servir X (por ejemplo, una credencial duplicada): rechaza con el motivo, sale con 78. Un rechazo transitorio (el propietario vivo pero en silencio) sale con 75 para que un supervisor lo reintente.
hermes gateway start --all/restart --allsignifican el único multiplexor del host. Ya no barren con procesos de gateway en ejecución; un profile que aún mantiene su propio gateway se reporta, nunca se mata, con el one-linerhermes gateway migrate --multiplexadjunto.hermes gateway stopsobre un secundario servido ya no es «no hay ningún gateway en ejecución para este profile» con salida 0: nombra el proceso del host y te dice que pares ese, salida 78.hermes gateway run --replacedecide por el conjunto servido en vivo: el profile que lanzó el proceso asume el rol de host.--forcees la escapatoria que arranca un gateway separado sin preguntar al propietario.
Un detalle que muerde a la gente: bajo un supervisor, la ruta de attach sale con 75, no con 0. systemd, launchd y s6 reinician un 75 tras un breve retraso, así que la unidad sigue reintentando y toma el control por sí sola en el momento en que el proceso del host desaparece.
Migrar: lee el plan y deja que se reanude solo
En una máquina actualizada desde una topología por profile, el movimiento estándar son dos comandos:
hermes gateway migrate --multiplex --dry-run   # imprime el plan, los bloqueos y los reinicios que implica
hermes gateway migrate --multiplex             # converge (añade --yes en shells no interactivos)
El dry run lista en una tabla el PID de gateway y el tipo de servicio de cada profile, luego detalla qué hará — parar el pid 4101 y desinstalar la unidad systemd (de usuario) de coder, poner gateway.multiplex_profiles: true en el config.yaml del profile por defecto, arrancar el gateway y verificar que sirve tres profiles — y guarda el estado anterior en ~/.hermes/gateway_migration.json. Nunca manda un SIGTERM a un gateway en silencio: el plan dice qué procesos se van a terminar, y estos drenan sus turnos en curso antes de salir.
Hay dos decisiones de diseño que conviene recordar, porque deciden qué haces cuando algo va mal:
- La convergencia se define por la topología, no por el flag de config. Una máquina convergida no tiene ningún profile secundario con un proceso de gateway ni con una unidad de supervisor. La comprobación antigua solo preguntaba «¿está el flag activado?», así que una máquina a medio migrar —flag cambiado, unidad olvidada, un crash por el medio— se reportaba como ya multiplexada, y el comando no hacía nada justo en la máquina que lo necesitaba. Ahora el flag por sí solo nunca satisface la comprobación, lo que significa que volver a ejecutar el comando es la recuperación.
- El manifiesto es el registro de reanudación: si está presente, es que no se terminó. Cuando el comando encuentra uno en disco, reanuda desde él en lugar de sobrescribirlo (es el único registro de qué unidades existían), y solo una convergencia confirmada lo borra.
La migración cubre systemd (de usuario y de sistema, leyendo User= antes de eliminar la unidad), launchd y las tareas programadas de Windows: Windows era antes un rechazo plano con instrucciones para hacerlo a mano, y ahora además limpia la entrada de la carpeta Inicio que gateway install escribe cuando no puede registrar una tarea (eliminar solo la tarea dejaría ese fallback lanzando un segundo gateway en el siguiente inicio de sesión). Los contenedores s6 siguen rechazándose, con razón: ahí los gateways por profile son slots que registra el propio arranque del contenedor, así que el plegado corresponde a ese arranque.
Tres incidentes reales: por qué un backend debe servir a un solo profile
Esta convergencia es trabajo P1 porque «un backend, muchos profiles» amplifica una clase de fallo muy silenciosa. Tres instancias llegaron en esta ventana con nombre propio.
Primero, las rutas REST mutaban los datos del profile equivocado. Con un backend sirviendo a todos, un puñado de handlers leían el get_hermes_home() del proceso e ignoraban el profile que nombraba la petición. El resultado no era una lectura incorrecta, sino un borrado incorrecto: POST /api/memory/reset?profile=worker_beta eliminaba el memories/MEMORY.md y el USER.md del profile de lanzamiento mientras worker_beta quedaba intacto. La misma forma abarcaba borrar una suscripción de webhook, borrar un hook de ops (que además revocaba el consentimiento del profile de lanzamiento), podar checkpoints, importar un backup sobre el profile de lanzamiento, borrar una entrada del pool de credenciales y ejecutar el curator contra los skills del profile de lanzamiento. Ahora todas las rutas respetan el profile que se les da, y las destructivas devuelven 400 cuando una petición no nombra ningún profile en un host multi-profile en vez de elegir uno.
Segundo, los profiles con nombre se convirtieron en islas de credenciales. Un cambio anterior hizo que cada profile con nombre leyera solo su propio auth.json, así que tras una actualización los bots de Desktop empezaron a fallar con No Codex credentials stored. Run hermes -p <bot> auth add openai-codex --type oauth mientras el profile raíz seguía con la sesión iniciada. Ahora los profiles con nombre vuelven a resolver el login OAuth del profile raíz, manteniendo su propio ámbito de credenciales.
Tercero, Desktop arrancaba un backend por profile. La app lanzaba un hermes serve por cada profile: un montón de procesos de backend y un arranque de MCP duplicado en una máquina multi-profile. Ahora Desktop se engancha al backend del host en ejecución. Ese cambio depende explícitamente de que las rutas REST conscientes del profile llegaran primero: con el orden invertido, el colapso manda llamadas destructivas sin ámbito al directorio home del primario, y el PR lo dice.
La ruta de actualización también convergió: hermes -p coder update y hermes -p writer update ahora reinician el gateway del host una vez entre los dos, y el aviso de reinicio llega a todos los profiles servidos.
La mitad de almacenamiento: hermes sessions set-journal-mode
La misma campaña (issue de seguimiento #109417, más de 70 PRs en ella) añadió un comando de autoservicio para convertir state.db entre el modo de journal WAL y DELETE sin conexiones activas:
hermes sessions set-journal-mode delete                          # WAL -> rollback journal
hermes sessions set-journal-mode wal                             # volver a WAL
hermes sessions set-journal-mode delete --db ~/.hermes/kanban.db # otro almacén de Hermes
La premisa importa: Hermes nunca degrada en caliente una base de datos WAL al abrirla; el gateway, cron o un worker pueden tener commits sin checkpoint, y una degradación por debajo de ellos destruye esos commits. Así que un database.journal_mode: delete configurado contra un almacén WAL existente siempre ha significado «no se aplicó, un ERROR por proceso». La prueba de admisión del comando es simplemente «ningún proceso tiene el archivo»: lista cada tenedor como pid — comando: ruta y se niega en caso contrario, cambia el modo sin esperar a que se cierren los que lo tengan abierto (uno que aparezca a mitad hace que SQLite se niegue en lugar de competir en una carrera), y vuelve a leer los bytes de cabecera para confirmar el modo. Te recuerda alinear database.journal_mode cuando la config no coincide, porque la siguiente apertura vuelve a aplicar el valor configurado.
Checklist posterior a la actualización
hermes version                                  # espera v0.21.4 (etiqueta v2026.9.21)
hermes gateway status                           # quién sirve qué profiles
hermes gateway migrate --multiplex --dry-run    # actualizaciones desde una topología por profile: plan + bloqueos
hermes -p coder gateway run                     # debería engancharse e imprimir el PID del host, no arrancar un segundo proceso
hermes doctor                                   # aquí salen los avisos de almacenamiento y de topología de gateway
Dos comportamientos más que conviene conocer: los profiles creados después de la migración los sirve automáticamente el multiplexor en ejecución (vuelve a escanear profiles/ al crear y borrar, y cada 30 segundos en el resto de casos, unos medio segundo en la práctica), y un host con un gateway.multiplex_profiles: true explícito nunca es cuestionado por el preflight de arranque: tu decisión, o la de la migración, se mantiene. La variable de entorno GATEWAY_MULTIPLEX_PROFILES sobrescribe de la misma forma la decisión de clave sin definir.
El caso forzado: cuándo --force sigue siendo correcto
El multiplexado está activo por defecto, pero un flag sin definir es una petición que el gateway del host resuelve en el arranque, no un veredicto. Cada arranque ejecuta el mismo preflight que la migración: dos o más profiles, ningún secundario que siga ejecutando su propio gateway (cuentan tanto un proceso vivo como una unidad instalada), sin credencial de bot duplicada, sin plataforma que enlace un puerto sin un ingress /p/<profile>/, y un tipo de host que la migración entienda. Si alguna comprobación falla, arranca exactamente como antes, sirviendo solo el profile por defecto, registrando el bloqueo y el one-liner de migración, y sin cambiar nada en disco; converge por sí solo una vez que el bloqueo desaparece.
Eso deja exactamente dos situaciones en las que --force es la respuesta correcta: una flota repartida entre usuarios UNIX y un HERMES_HOME fuera de profiles/. Para un profile con nombre, hermes -p <name> gateway install, start y run salen con 78 sin --force y te remiten al hermes gateway install del profile por defecto o al comando de migración; solo una máquina que ya instaló una unidad con --force sigue llegando a ella desde un gateway start a secas.
La versión corta
El valor de esta convergencia no es «un proceso menos»: es la frontera. Un backend sirviendo a un solo profile significa que credenciales, memoria, sesiones, hooks y cron tienen que estar todos en el ámbito del profile, y cada uno que se olvide se convierte en datos borrados o en una clave filtrada. Así que si tu máquina ejecuta más de un profile: lanza el dry run después de actualizar y recorre la checklist de arriba. Para el panorama más amplio de qué más cambió en esta etiqueta, lee qué envió realmente v0.21.4; para la superficie del gateway en sí, consulta la referencia del comando hermes gateway y la guía anterior de multiplex por defecto.