Ein Gateway pro Host: die Multiplex-only-Migration, drei echte Vorfälle und eine Checkliste nach dem Upgrade
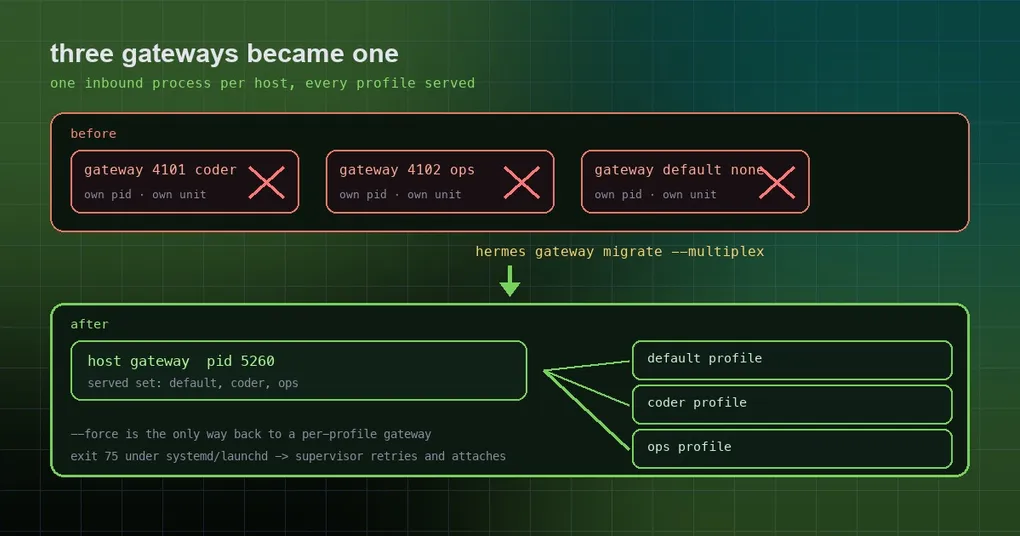
Du betreibst drei Hermes-Agents auf einer kleinen Maschine: einen persönlichen, einen fürs Coding und einen, der die Produktions-Alerts überwacht. Nach jedem Upgrade hast du früher gedankenlos hermes -p coder gateway restart getippt, weil du wusstest, dass es genau einen Prozess anfasst. Seit v0.21.4 bedeutet dieser Befehl etwas anderes: Er zielt jetzt auf das eine Gateway auf dieser Maschine, und dieses Gateway bedient gleichzeitig die beiden anderen Profile. Wenn du lieber wissen willst, worauf du stehst, bevor du upgradest, findest du hier die neue Topologie, den Migrationsbefehl, was er verweigert und die drei echten Vorfälle, die die Konvergenz unterwegs aufgeräumt hat.
Die neue Regel: ein hermes gateway run pro Host, pro OS-Benutzer
Die Architektur-Direktive ist unmissverständlich: multiplex-only. Ein Gateway-Prozess pro Maschine empfängt Plattformnachrichten, und er bedient jedes Profile unter profiles/. Das ist keine Empfehlung — es ist die ausgelieferte Topologie seit v0.21.4. hermes gateway migrate --multiplex konvergiert eine ältere Maschine darauf, und ein neu angelegtes benanntes Profile kann kein eigenes Gateway mehr installieren (siehe den erzwungenen Fall unten).
Was sich damit geändert hat, ist die Bedeutung jedes Lifecycle-Verbs. Die Entscheidungsfunktion lautet attach → rescan → refuse, und die Regel ist, dass ein zweiter Prozess niemals gestartet wird:
hermes -p X gateway run, während X bedient wird: gibt die PID des Host-Gateways und die bediente Menge aus, beendet mit 0, spawnt nichts.hermes -p X gateway run, während X nicht bedient wird: bittet das Host-Gateway über seinen Control-Socket,profiles/neu zu scannen, und hängt sich an, sobald die Antwort X enthält. Exit 0.- Der Owner kann X nicht bedienen (etwa ein doppeltes Credential): Verweigerung mit Begründung, Exit 78. Eine transiente Verweigerung — Owner lebt, antwortet aber nicht — endet mit 75, damit ein Supervisor einen Retry macht.
hermes gateway start --all/restart --allbedeuten der eine Host-Multiplexer. Sie fegen keine laufenden Gateway-Prozesse mehr weg; ein Profile, das noch sein eigenes Gateway hält, wird gemeldet, nie gekillt, mit demhermes gateway migrate --multiplex-Einzeiler als Anhang.hermes gateway stopauf einem bedienten Secondary ist nicht mehr „no gateway running for this profile“ mit Exit 0 — es nennt den Host-Prozess und sagt dir, stattdessen diesen zu stoppen, Exit 78.hermes gateway run --replaceentscheidet anhand der live bedienten Menge: Welches Profile den Prozess gestartet hat, übernimmt die Host-Rolle.--forceist die Escape-Hatch, die ein separates Gateway startet, ohne den Owner überhaupt zu fragen.
Ein Detail, das Leute beißt: unter einem Supervisor endet der Attach-Pfad mit 75, nicht mit 0. systemd, launchd und s6 starten ein 75 nach kurzer Verzögerung neu, also versucht die Unit es immer wieder und übernimmt von selbst in dem Moment, in dem der Host-Prozess verschwindet.
Migration: erst den Plan lesen, dann selbst fortsetzen lassen
Auf einer Maschine, die von einer Per-Profile-Topologie heraufgeupgradet wurde, sind die zwei Standardbefehle:
hermes gateway migrate --multiplex --dry-run   # Plan, Blocker und die implizierten Neustarts ausgeben
hermes gateway migrate --multiplex             # konvergieren (in nicht-interaktiven Shells --yes ergänzen)
Der Dry Run listet die Gateway-PID und den Servicetyp jedes Profiles als Tabelle auf, schreibt dann aus, was er tun wird — pid 4101 stoppen und die systemd-Unit (user) für coder deinstallieren, gateway.multiplex_profiles: true in die config.yaml des Default-Profiles schreiben, das Gateway starten und verifizieren, dass es drei Profile bedient — und zeichnet den vorherigen Zustand in ~/.hermes/gateway_migration.json auf. Er SIGTERMt niemals still ein Gateway: Der Plan sagt, welche Prozesse terminiert werden, und sie drainen laufende Turns, bevor sie beenden.
Zwei Designentscheidungen sind es wert, im Gedächtnis zu bleiben, weil sie bestimmen, was du tust, wenn etwas schiefgeht:
- Konvergenz wird durch die Topologie definiert, nicht durch das Config-Flag. Eine konvergierte Maschine hat kein Secondary-Profile, das einen Gateway-Prozess oder eine Supervisor-Unit besitzt. Die ältere Prüfung fragte nur „ist das Flag an?“, sodass eine halbmigrierte Maschine — Flag umgelegt, Unit zurückgelassen, ein Crash dazwischen — als bereits gemultiplext gemeldet wurde, und der Befehl tat auf genau der Maschine nichts, die ihn brauchte. Jetzt genügt das Flag allein nie der Prüfung, was bedeutet: den Befehl erneut auszuführen ist die Wiederherstellung.
- Das Manifest ist der Resume-Record: vorhanden heißt unfertig. Wenn der Befehl eines auf der Platte findet, setzt er es fort, statt es zu überschreiben (es ist der einzige Beleg darüber, welche Units existierten), und nur eine bestätigte Konvergenz löscht es.
Die Migration deckt systemd ab (user und system, liest User= vor dem Entfernen der Unit), launchd und Windows Scheduled Tasks — Windows war früher eine pauschale Verweigerung mit dem Hinweis, es von Hand zu tun, und räumt jetzt auch den Startup-Folder-Eintrag auf, den gateway install schreibt, wenn es keine Task registrieren kann (nur die Task zu entfernen würde diesen Fallback zurücklassen, der bei der nächsten Anmeldung ein zweites Gateway startet). s6-Container werden weiterhin verweigert, und das zu Recht: Dort sind die Per-Profile-Gateways Slots, die der Boot des Containers selbst registriert, also gehört das Zusammenfalten zu diesem Boot.
Drei echte Vorfälle: warum ein Backend nur ein Profile bedienen muss
Diese Konvergenz ist P1-Arbeit, weil „ein Backend, viele Profile“ eine sehr leise Fehlerklasse verstärkt. Drei Fälle sind in diesem Fenster mit Namen gelandet.
Erstens: REST-Routen mutierten die Daten des falschen Profiles. Mit einem Backend, das alle bedient, lasen eine Handvoll Handler get_hermes_home() des Prozesses und ignorierten das Profile, das die Anfrage nannte. Das Ergebnis war kein falscher Read, sondern ein falsches Delete: POST /api/memory/reset?profile=worker_beta entfernte die memories/MEMORY.md und USER.md des Launch-Profiles, während worker_beta unberührt blieb. Dieselbe Form betraf das Löschen einer Webhook-Subscription, das Löschen eines Ops-Hooks (was zusätzlich die Zustimmung des Launch-Profiles widerrief), das Prunen von Checkpoints, das Importieren eines Backups über das Launch-Profile, das Löschen eines Credential-Pool-Eintrags und das Ausführen des Curators gegen die Skills des Launch-Profiles. Jede Route respektiert jetzt das Profile, das ihr gegeben wird, und die destruktiven geben 400 zurück, wenn eine Anfrage auf einer Multi-Profile-Maschine kein Profile nennt, statt eines auszuwählen.
Zweitens: benannte Profile wurden zu Credential-Inseln. Eine frühere Änderung ließ jedes benannte Profile nur seine eigene auth.json lesen, sodass nach einem Update Desktop-Bots mit No Codex credentials stored. Run hermes -p <bot> auth add openai-codex --type oauth fehlschlugen, während das Root-Profile eingeloggt war. Benannte Profile lösen jetzt wieder den OAuth-Login des Root-Profiles auf und behalten dabei ihren eigenen Credential-Scope.
Drittens: Desktop startete ein Backend pro Profile. Die App spawnte früher ein hermes serve für jedes Profile — ein Haufen Backend-Prozesse und duplizierter MCP-Boot auf einer Multi-Profile-Maschine. Desktop hängt sich jetzt an das laufende Host-Backend. Diese Änderung hängt explizit davon ab, dass die profile-aware REST-Routen zuerst landen: Bei umgekehrter Reihenfolge schickt das Zusammenfalten unscoped destruktive Calls an das Home-Verzeichnis des Primaries, und der PR sagt das auch.
Der Update-Pfad konvergierte ebenfalls: hermes -p coder update und hermes -p writer update starten das Host-Gateway jetzt einmal zwischen sich, und der Neustart-Hinweis erreicht jedes bediente Profile.
Die Storage-Hälfte: hermes sessions set-journal-mode
Dieselbe Kampagne (Tracking-Issue #109417, über 70 PRs darin) fügte einen Self-Service-Befehl hinzu, um state.db offline zwischen WAL- und DELETE-Journal-Modus umzustellen:
hermes sessions set-journal-mode delete                          # WAL -> rollback journal
hermes sessions set-journal-mode wal                             # zurück zu WAL
hermes sessions set-journal-mode delete --db ~/.hermes/kanban.db # ein anderer Hermes-Store
Die Prämisse ist wichtig: Hermes stuft eine WAL-Datenbank beim Öffnen niemals live herunter — das Gateway, Cron oder ein Worker können nicht gecheckpointete Commits halten, und ein Downgrade darunter zerstört diese Commits. Ein konfiguriertes database.journal_mode: delete gegen einen bestehenden WAL-Store bedeutete also schon immer „nicht angewendet, ein ERROR pro Prozess“. Der Admission-Test des Befehls ist einfach „kein Prozess hält die Datei“: Er listet jeden Halter als pid — command: path und verweigert sonst die Ausführung, schaltet den Modus um, ohne auf Opener zu warten (einer, der mittendrin auftaucht, lässt SQLite verweigern statt zu racen), und liest die Header-Bytes zurück, um den Modus zu bestätigen. Er erinnert dich daran, database.journal_mode anzugleichen, wenn die Config widerspricht, weil das nächste Öffnen den konfigurierten Wert erneut anwendet.
Checkliste nach dem Upgrade
hermes version                                  # erwartet v0.21.4 (Tag v2026.9.21)
hermes gateway status                           # wer welche Profile bedient
hermes gateway migrate --multiplex --dry-run    # Upgrades von einer Per-Profile-Topologie: Plan + Blocker
hermes -p coder gateway run                     # sollte sich anhängen und die Host-PID ausgeben, keinen zweiten Prozess starten
hermes doctor                                   # Warnungen zu Storage und Gateway-Topologie tauchen hier auf
Zwei weitere Verhaltensweisen sind wissenswert: Profile, die nach der Migration angelegt werden, werden automatisch vom laufenden Multiplexer bedient (er scannt profiles/ bei Create und Delete neu und ansonsten alle 30 Sekunden — in der Praxis etwa eine halbe Sekunde), und eine Maschine mit explizitem gateway.multiplex_profiles: true wird vom Boot-Preflight niemals in Frage gestellt — deine Entscheidung, oder die der Migration, gilt. Die Umgebungsvariable GATEWAY_MULTIPLEX_PROFILES überschreibt die Unset-Key-Entscheidung auf dieselbe Weise.
Der erzwungene Fall: wann --force noch richtig ist
Multiplexing ist standardmäßig an, aber ein nicht gesetztes Flag ist eine Bitte, die das Host-Gateway beim Boot entscheidet, kein Urteil. Jeder Start führt denselben Preflight aus wie die Migration: zwei oder mehr Profile, kein Secondary, das noch sein eigenes Gateway laufen lässt (ein lebender Prozess oder eine installierte Unit zählen beide), kein doppeltes Bot-Credential, keine port-bindende Plattform ohne /p/<profile>/-Ingress, und ein Host-Typ, den die Migration versteht. Schlägt eine dieser Prüfungen fehl, kommt es genau wie vorher hoch und bedient nur das Default-Profile, protokolliert den Blocker und den Migrations-Einzeiler — und ändert nichts auf der Platte, konvergiert von selbst, sobald der Blocker weg ist.
Das lässt genau zwei Situationen übrig, in denen --force die richtige Antwort ist: eine Flotte, die über UNIX-Benutzer aufgeteilt ist, und ein HERMES_HOME außerhalb von profiles/. Für ein benanntes Profile enden hermes -p <name> gateway install, start und run ohne --force alle mit 78 und verweisen dich auf das hermes gateway install des Default-Profiles oder den Migrationsbefehl; nur eine Maschine, die mit --force bereits eine Unit installiert hat, erreicht sie weiterhin über ein einfaches gateway start.
Die Kurzfassung
Der Wert dieser Konvergenz ist nicht „ein Prozess weniger“ — es ist die Grenze. Ein Backend, das ein Profile bedient, bedeutet, dass Credentials, Memory, Sessions, Hooks und Cron alle profile-scoped sein müssen, und jede vergessene wird zu gelöschten Daten oder einem geleakten Key. Wenn auf deiner Maschine also mehr als ein Profile läuft: Führe nach dem Upgrade den Dry Run aus und arbeite dann die Checkliste oben durch. Für das größere Bild, was sich in diesem Tag sonst noch geändert hat, lies was v0.21.4 tatsächlich ausgeliefert hat; zur Gateway-Oberfläche selbst siehe die hermes gateway Befehl-Referenz und den früheren Multiplex-by-default-Leitfaden.