15 个 profile 拖垮一个 gateway:每个 MCP 都被开了 15 份
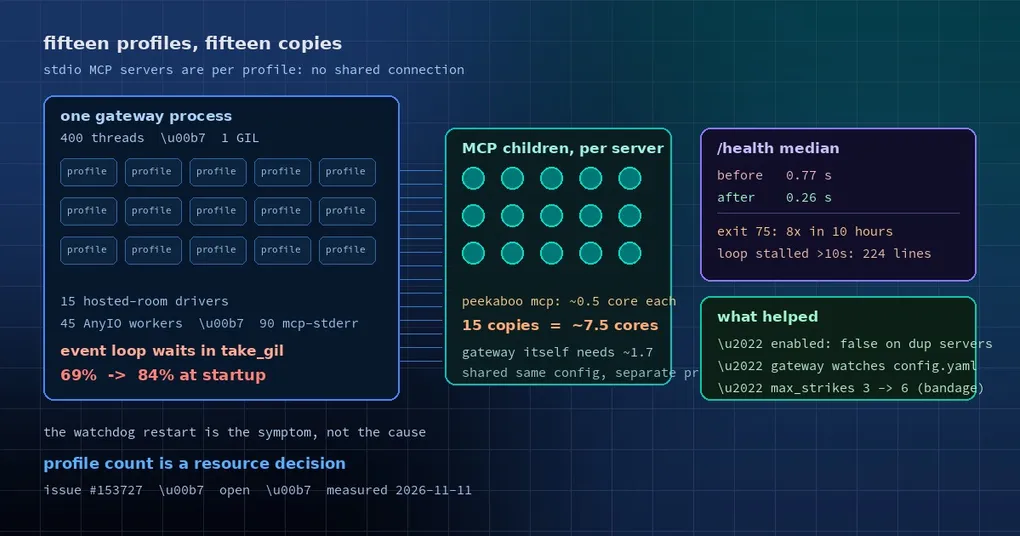
你用一个 gateway 服务十几个 profile:写代码的、查资料的、跑 cron 的、接不同聊天平台的。平时挺好用,直到某天桌面端开始报 request timed out after 30s: session.resume,日志里反复出现 Gateway event loop missed 3 consecutive liveness probes … exiting with code 75,curl /health 也要等半分钟才回。你以为是网络问题,重启一遍,几小时后又来一次。
有个用户把这件事测了个底朝天,结论不太像“网络问题”:一个 gateway 里跑着 400 个线程,事件循环有 69% 的时间在等 Python 的 GIL。
先把症状摊开
他在一台 macOS 主机上开了 15 个 profile,用默认的多路复用 gateway(一个进程服务所有 profile)。用 sample <pid> 采样 6–8 秒,按线程统计停在 take_gil 的次数:
| 指标 | 稳态(缓解前) | 稳态(缓解后) | 启动期 |
|---|---|---|---|
| gateway 线程数 | 399–401 | 400 | 152 |
| 事件循环线程等 GIL 占比 | 69% | 76% | 84% |
| 事件循环线程空闲在 kevent | 0% | 2% | 15% |
同一时间段里:exit 75 的存活探针失败在约 10 小时内出现 8 次;ws write slow (loop stalled >10.0s) 记了 224 行;桌面端 session.resume 30 秒超时;一次 GET /health 在循环卡住时 30 秒没有任何响应。
注意“缓解后 76%“这个数字——它说明缓解措施减少了触发频率,但没有改变”事件循环在抢 GIL“这个结构。
真正的元凶:MCP 服务按 profile 各起一份
线程构成里有几个数字很说明问题:90 个 mcp-stderr 线程、44–45 个 AnyIO worker、30 个 tokio-rt-worker、15 个 hosted-room-driver-supervisor(每个 profile 一个)。
关键在于 MCP。stdio 类型的 MCP 服务是“一个服务一个子进程”,由使用它的 agent 启动。多路复用 gateway 里的每个 profile 都是一个独立的运行时,各自读自己的 config.yaml、各自连自己的 MCP 服务。如果 15 个 profile 列了同一批 stdio MCP 服务,那就是 15 份子进程,而不是一份共享。
这位用户配的其中一个服务(peekaboo mcp)会持续监听应用的启动/退出通知,单份约占半个核。15 份加起来就是 7.5 个核——而 gateway 自己实际只需要大约 1.7 个核。
把它停掉、在配置里设 enabled: false 之后,/health 的中位延迟从 0.77 秒降到 0.26 秒,loop stalled 日志也停了。这说明“GIL 饥饿”不是 Python 的锅,是有人在你家门口开了 15 台吸尘器。
为什么单个 GIL 会拖垮所有 profile
Python 的线程共享一把全局解释器锁。多路复用 gateway 的所有 profile 跑在同一个进程里,事件循环线程要和几百个工作线程轮流拿这把锁。
平时这没问题:工作线程大部分时间在等 IO,锁是空闲的。但当 15 份 MCP 子进程的 stderr 读取线程、45 个 AnyIO worker 都在积极活动时,锁的持有者频繁被抢占;一旦持有者被操作系统调度下去,整个进程里所有线程都得等——包括那个负责响应健康检查、转发消息、处理 session.resume 的事件循环线程。
更糟的是 watchdog 的判定逻辑:连续 3 次探针超时(默认间隔 30 秒、单次超时 10 秒),它就以 75 退出,让守护进程重启 gateway。这就是“看起来随机重启”的来源:它不是崩溃,是主动重启。
怎么自查有没有踩到
1. 看看每个 profile 配了什么 MCP。 profile 各自的配置在 ~/.hermes/profiles/<name>/config.yaml,用命令看更省事(HERMES_PROFILE 指定 profile,先 hermes profile list 拿到名字):
HERMES_PROFILE=<name> hermes mcp list对每个 profile 跑一遍,把 mcp_servers 名字列出来对比。同一个 stdio 服务出现在多个 profile 里,就是潜在的多份进程。
2. 数一下线程。 找到 gateway 进程(hermes gateway status 会给 PID),看线程数和名字(macOS 用 ps -M,Linux 用 ps -L):
ps -L <pid> | awk '{print $NF}' | sort | uniq -c | sort -rn | headmcp-stderr 的数量基本等于“当前活着的 stdio MCP 连接数”。15 个 profile 各配 3 个服务,就是 45 个。
3. 看 gateway 的健康状况。 hermes gateway status --deep 会显示更深的状态;如果日志里反复出现 loop stalled 或 exiting with code 75,就不要再往“网络抖动”上猜了。
怎么减负
按需关闭重复的 MCP 服务。 在 config.yaml 的 mcp_servers 条目下写 enabled: false,Hermes 会完全跳过这个服务、连连接都不尝试。文档里还有一条很实用的说明:运行中的 gateway 会监听 config.yaml,改完大约一分钟内就会把那个连接拆掉,不需要重启,也不需要 /reload-mcp。
只给需要的 profile 配服务。 一个只处理邮件的 profile 通常不需要浏览器控制类服务。把“工具面”和“profile”对齐,比给所有 profile 一份全量配置更省资源,也更安全。
给 watchdog 留余地,但别关掉它。 默认是 30 秒探针间隔、10 秒超时、连续 3 次失败就退出。如果只是偶发重启,可以先把 gateway.loop_watchdog_max_strikes 从 3 调到 6,让更多探针失败才触发退出:
gateway:
  loop_watchdog_max_strikes: 6
但这是止血,不是治疗。把 watchdog 整个关掉(gateway.loop_watchdog: false)更不划算——它去掉的正是“循环真的卡死时”唯一的恢复路径。
profile 数量本身也是成本。 15 个 profile 意味着一份常驻的调度、连接、监听开销。把不常用的 profile 合并,或者让它们按需启动,往往比任何参数调优都有效。
目前的状态
这条 issue 仍是打开状态,报告者列出的缓解措施是“减少 MCP 重复 + 调 watchdog”,不是根治。社区里还有人提出让 launchd 以 ProcessType=Interactive 启动 gateway(默认是 daemon,优先级被压到 20,任何前台程序都能抢在它前面),以及把 session.resume 的全局锁按 profile 拆开——这些属于提议,还没有合并。修复形态可能会变,但“多路复用 + 每个 profile 各起一份 stdio MCP”这个成本模型不会变。
用多 profile 的人通常是为了隔离:不同平台、不同项目、不同权限。隔离是对的,但隔离的代价要算清楚——尤其是那些“每个 profile 都配一遍”的 stdio 服务。