15 Profile, ein Gateway: Jeder MCP-Server wurde 15-mal gestartet
Du betreibst ein Gateway für ein Dutzend Profile: eines schreibt Code, eines recherchiert, eines fährt cron, ein paar hängen an verschiedenen Chat-Plattformen. Das läuft gut – bis die Desktop-App request timed out after 30s: session.resume meldet, das Log wiederholt Gateway event loop missed 3 consecutive liveness probes … exiting with code 75 schreibt und curl /health eine halbe Minute braucht. Du schiebst es aufs Netzwerk, startest neu, und ein paar Stunden später passiert es wieder.
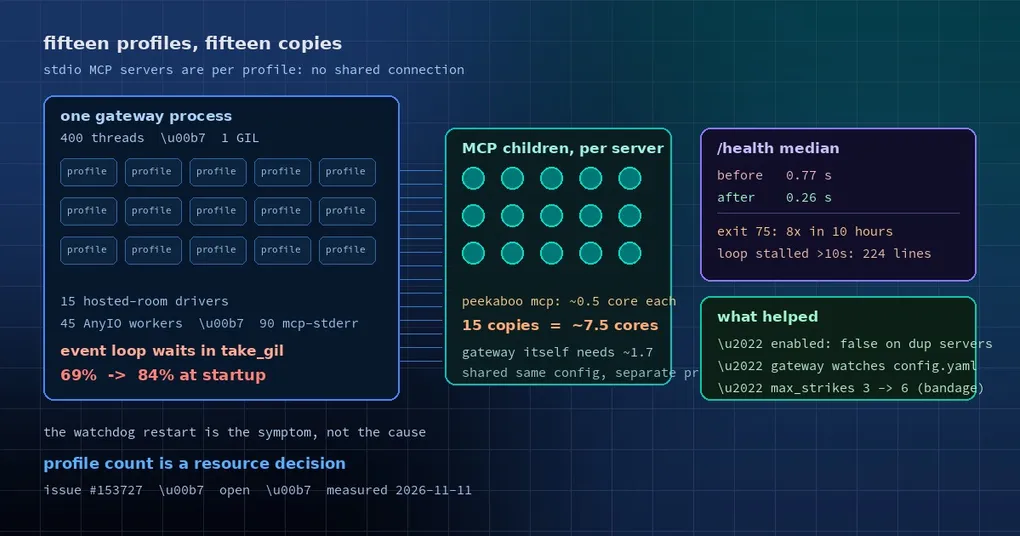
Ein User hat das ordentlich gemessen, und die Antwort ist nicht das Netzwerk: 400 Threads in einem Gateway-Prozess, wobei der Event-Loop 69 % seiner Zeit mit Warten auf den GIL von Python verbringt.
Die Symptome im Einzelnen
Auf einem macOS-Host mit 15 Profilen hinter dem standardmäßigen multiplexenden Gateway (ein Prozess für alle Profile) haben sie den Prozess 6–8 Sekunden mit sample <pid> gesampelt und take_gil-Frames pro Thread gezählt:
| Metrik | Steady State (vorher) | Steady State (nach Mitigation) | Während des Starts |
|---|---|---|---|
| Gateway-Threads | 399–401 | 400 | 152 |
Event-Loop-Thread wartend in take_gil |
69 % | 76 % | 84 % |
Event-Loop-Thread idle in kevent |
0 % | 2 % | 15 % |
Im selben Zeitraum: Der Liveness-Watchdog beendete sich achtmal mit Code 75 in etwa zehn Stunden; ws write slow (loop stalled >10.0s) wurde 224-mal geloggt; das session.resume der Desktop-App lief in sein 30-Sekunden-Timeout; ein GET /health bekam 30 Sekunden keine Antwort, während der Loop stand.
Beachte die „76 % danach“. Die Mitigation senkte die Auslöserate; sie änderte nicht die Struktur – der Loop konkurriert weiterhin um den GIL.
Der eigentliche Übeltäter: MCP-Server wurden pro Profile gestartet
Die Thread-Aufschlüsselung sagt viel: 90 mcp-stderr-Threads, 44–45 AnyIO-Worker, 30 tokio-rt-worker und 15 hosted-room-driver-supervisor-Threads (eines pro Profile).
MCP ist der wichtige Teil. Ein stdio-MCP-Server ist ein Kindprozess, gestartet von dem Agenten, der ihn nutzt. In einem multiplexenden Gateway ist jedes Profile eine unabhängige Runtime: Es liest seine eigene config.yaml und verbindet sich mit seinen eigenen MCP-Servern. Listen 15 Profile dieselben stdio-MCP-Server, bekommst du 15 Kindprozesse pro Server – keine geteilte Verbindung.
Einer der Server in diesem Setup (peekaboo mcp) beobachtet App-Start- und -Beenden-Notifications und brauchte etwa einen halben Kern pro Kopie. Fünfzehn Kopien sind rund 7,5 Kerne – während das Gateway selbst nur etwa 1,7 will.
Ihn zu deaktivieren (enabled: false) brachte /health von 0,77 Sekunden Median auf 0,26 Sekunden und stoppte die loop stalled-Zeilen. Der GIL war nicht die Krankheit; er war das Symptom von fünfzehn Staubsaugern im Flur.
Warum ein GIL jedes Profile blockiert
Python-Threads teilen einen einzigen globalen Interpreter-Lock. Ein multiplexendes Gateway führt alle Profile in einem Prozess aus, also wechselt sich der Event-Loop-Thread mit Hunderten Worker-Threads um diesen Lock ab.
Normalerweise ist das fein: Worker verbringen die meiste Zeit mit IO-Warten, und der Lock liegt frei. Aber wenn 15 MCP-Kindprozesse je stderr-Reader haben und 45 AnyIO-Worker aktiv sind, wechselt der Lock ständig den Besitzer – und sobald der aktuelle Halter vom OS descheduled wird, wartet jeder Thread im Prozess, auch der, der Health Checks beantwortet, Nachrichten weiterleitet und session.resume behandelt.
Der Watchdog macht dann genau das, wofür er gebaut ist: drei aufeinanderfolgende Probe-Timeouts (Standard: 30-Sekunden-Intervall, 10-Sekunden-Timeout) und er beendet sich mit Code 75, damit der Supervisor das Gateway neu startet. Daher kommen die „zufälligen Neustarts“ – kein Crash, ein bewusster Neustart.
So prüfst du, ob du betroffen bist
1. Vergleiche die MCP-Listen pro Profile. Jedes Profile hat seine eigene Config unter ~/.hermes/profiles/<name>/config.yaml. Die CLI ist schneller (HERMES_PROFILE wählt das Profile; hermes profile list gibt dir die Namen):
HERMES_PROFILE=<name> hermes mcp listFühre das für jedes Profile aus und vergleiche die Namen in mcp_servers. Derselbe stdio-Server in mehreren Profilen bedeutet mehrere Kopien des Prozesses.
2. Zähl die Threads. Finde die Gateway-PID (hermes gateway status meldet sie) und liste dann die Threads nach Namen (macOS ps -M, Linux ps -L):
ps -L <pid> | awk '{print $NF}' | sort | uniq -c | sort -rn | headDie Anzahl der mcp-stderr-Threads ist ungefähr die Anzahl lebender stdio-MCP-Verbindungen. Fünfzehn Profile mit je drei Servern sind 45.
3. Schau dir die Sicht des Gateways an. hermes gateway status --deep zeigt mehr Zustand; wenn das Log loop stalled oder exiting with code 75 wiederholt, hör auf, über Netzwerk-Flakiness zu rätseln.
So nimmst du die Last runter
Deaktiviere doppelte MCP-Server pro Profile. enabled: false an einem mcp_servers-Eintrag lässt Hermes ihn komplett überspringen – es versucht nicht einmal eine Verbindung. Die Doku merkt außerdem an, dass ein laufendes Gateway die config.yaml beobachtet: Innerhalb etwa einer Minute nach enabled: false (oder Entfernen des Eintrags) wird die Verbindung dieses Servers abgebaut, ohne Neustart und ohne /reload-mcp.
Gib einem Profile nur die Server, die es braucht. Ein Profile, das E-Mail bearbeitet, braucht selten Browser-Steuerung. Die Tool-Oberfläche am Profile auszurichten spart Ressourcen und verkleinert die Angriffsfläche.
Gib dem Watchdog Luft, aber schalte ihn nicht ab. Die Defaults sind 30-Sekunden-Probe-Intervall, 10-Sekunden-Timeout und drei Strikes. Bei gelegentlichem Neustart-Churn ist es der billige Notbehelf, gateway.loop_watchdog_max_strikes von 3 auf 6 zu heben:
gateway:
  loop_watchdog_max_strikes: 6
Das ist ein Pflaster, keine Heilung. Den Watchdog ganz abzuschalten (gateway.loop_watchdog: false) ist schlimmer: Du entfernst den einzigen Erholungspfad für einen wirklich hängenden Loop.
Die Profilanzahl ist selbst ein Kostenfaktor. Fünfzehn Profile bedeuten fünfzehn Sätze residentes Scheduling, Verbindungen und Watcher. Die selten genutzten zusammenzulegen – oder bei Bedarf zu starten – schlägt meist jedes Parameter-Tuning.
Stand der Dinge
Das Issue ist noch offen. Die Mitigationen des Reporters sind „die doppelten MCP-Server entfernen und den Watchdog tunen“, kein Root-Fix. Community-Mitglieder schlugen außerdem vor, das Gateway per launchd als ProcessType=Interactive zu starten (Default ist daemon, was es auf Priorität 20 setzt, sodass jede Vordergrund-App es überholt) und den prozessweiten session.resume-Lock pro Profile aufzuteilen. Das sind Vorschläge, keine gemergten Änderungen. Der Fix kann die Form wechseln; das Kostenmodell – Multiplexing plus ein stdio-MCP-Kindprozess pro Profile – nicht.
Leute betreiben viele Profile wegen Isolation: verschiedene Plattformen, Projekte, Berechtigungen. Isolation ist richtig. Kalkuliere sie nur ehrlich, besonders für stdio-Server, die du „der Einfachheit halber“ in jedes Profile kopiert hast.
Verwandt: Gateway-Befehle, MCP-Befehle, Loop-Watchdog-Tuning und mehrere Profile betreiben.