15 profiles, um gateway: cada servidor MCP foi iniciado 15 vezes
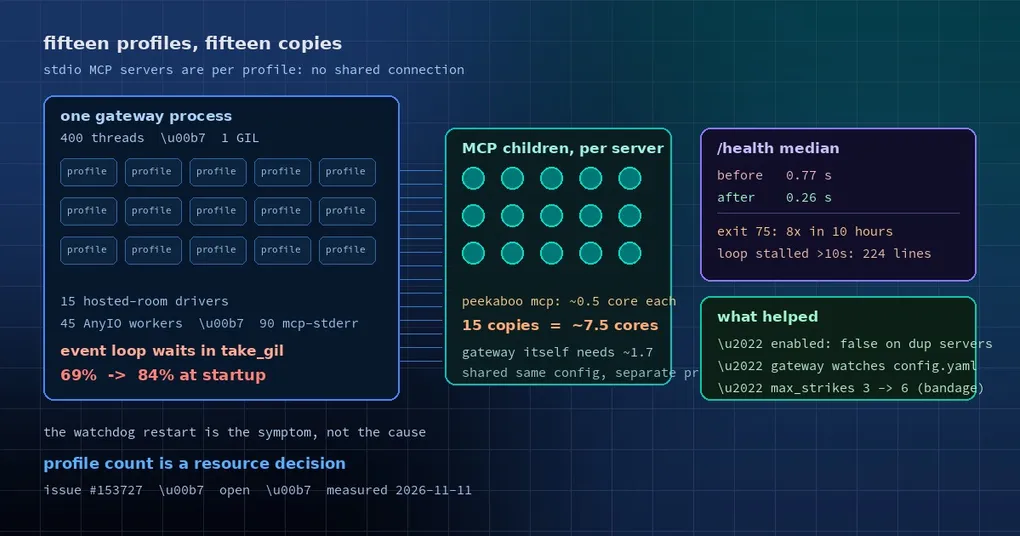
Você roda um gateway para uma dúzia de profiles: um escreve código, outro pesquisa, outro executa cron, alguns estão ligados a plataformas de chat diferentes. Funciona bem — até o app de desktop começar a reportar request timed out after 30s: session.resume, o log repetir Gateway event loop missed 3 consecutive liveness probes … exiting with code 75 e o curl /health demorar meio minuto. Você culpa a rede, reinicia, e algumas horas depois acontece de novo.
Um usuário mediu isso direito, e a resposta não é a rede: 400 threads em um processo de gateway, com o event loop passando 69% do seu tempo esperando o GIL do Python.
Os sintomas, por partes
Em um host macOS rodando 15 profiles atrás do gateway multiplexado padrão (um processo servindo todos os profiles), eles amostraram o processo com sample <pid> por 6–8 segundos e contaram os frames take_gil por thread:
| Métrica | Estado estável (antes) | Estado estável (depois da mitigação) | Durante o startup |
|---|---|---|---|
| Threads do gateway | 399–401 | 400 | 152 |
Thread do event loop esperando em take_gil |
69% | 76% | 84% |
Thread do event loop idle em kevent |
0% | 2% | 15% |
No mesmo período: o watchdog de liveness saiu com código 75 oito vezes em cerca de dez horas; ws write slow (loop stalled >10.0s) foi registrado 224 vezes; o session.resume do desktop estourou o timeout de 30 segundos; um GET /health ficou 30 segundos sem resposta enquanto o loop estava travado.
Repare no “76% depois”. A mitigação reduziu a taxa de disparo; não mudou a estrutura — o loop continua disputando o GIL.
O culpado real: servidores MCP iniciados uma vez por profile
A divisão de threads diz muito: 90 threads mcp-stderr, 44–45 workers de AnyIO, 30 tokio-rt-worker e 15 threads hosted-room-driver-supervisor (uma por profile).
MCP é a parte importante. Um servidor MCP stdio é um processo filho, iniciado pelo agente que o usa. Em um gateway multiplexado, cada profile é um runtime independente: ele lê o seu próprio config.yaml e se conecta aos seus próprios servidores MCP. Se 15 profiles listam os mesmos servidores MCP stdio, você tem 15 processos filhos por servidor — não uma conexão compartilhada.
Um dos servidores dessa configuração (peekaboo mcp) observa notificações de abertura e fechamento de apps e usava mais ou menos meio core por cópia. Quinze cópias são cerca de 7,5 cores — enquanto o gateway em si precisa de apenas uns 1,7.
Desativá-lo (enabled: false) levou o /health de uma mediana de 0,77 segundo para 0,26 segundo e acabou com as linhas de loop stalled. O GIL não era a doença; era o sintoma de quinze aspiradores de pó ligados no corredor.
Por que um único GIL trava todos os profiles
Threads de Python compartilham um único global interpreter lock. Um gateway multiplexado roda todos os profiles em um processo, então a thread do event loop reveza com centenas de threads de trabalho pela posse desse lock.
Normalmente isso não é problema: os workers passam a maior parte do tempo esperando IO, e o lock fica livre. Mas quando 15 processos filhos MCP têm cada um o seu leitor de stderr e 45 workers de AnyIO estão ativos, o lock troca de mãos o tempo todo — e sempre que o dono atual é desescalonado pelo sistema operacional, todas as threads do processo esperam, incluindo a que responde health checks, encaminha mensagens e trata session.resume.
O watchdog então faz exatamente o que foi feito para fazer: três timeouts de probe consecutivos (intervalo padrão de 30 segundos, timeout de 10 segundos) e ele sai com código 75 para que o supervisor reinicie o gateway. É daí que vêm os “reinícios aleatórios” — não é um crash, é um reinício deliberado.
Como verificar se é o seu caso
1. Compare as listas de MCP por profile. Cada profile tem a sua própria config em ~/.hermes/profiles/<name>/config.yaml. A CLI é mais rápida (HERMES_PROFILE seleciona o profile; hermes profile list mostra os nomes):
HERMES_PROFILE=<name> hermes mcp listRode para cada profile e compare os nomes em mcp_servers. O mesmo servidor stdio aparecendo em vários profiles significa várias cópias do processo.
2. Conte as threads. Encontre o PID do gateway (hermes gateway status informa), depois liste as threads por nome (ps -M no macOS, ps -L no Linux):
ps -L <pid> | awk '{print $NF}' | sort | uniq -c | sort -rn | headO número de threads mcp-stderr é aproximadamente o número de conexões MCP stdio ativas. Quinze profiles com três servidores cada dá 45.
3. Olhe a visão do próprio gateway. hermes gateway status --deep mostra mais estado; se o log repete loop stalled ou exiting with code 75, pare de especular sobre instabilidade de rede.
Como aliviar a carga
Desative servidores MCP duplicados por profile. Colocar enabled: false em uma entrada de mcp_servers faz o Hermes ignorá-la por completo — ele nem tenta a conexão. A documentação também observa que um gateway em execução vigia o config.yaml: em cerca de um minuto depois de definir enabled: false (ou remover a entrada), a conexão daquele servidor é derrubada, sem reinício e sem precisar de /reload-mcp.
Dê a cada profile só os servidores de que ele precisa. Um profile que cuida de e-mail raramente precisa de controle de browser. Alinhar a superfície de ferramentas com o profile economiza recursos e reduz a superfície de ataque.
Dê folga ao watchdog, mas não o desative. Os padrões são intervalo de probe de 30 segundos, timeout de 10 segundos e três strikes. Para uma rotatividade ocasional de reinícios, subir gateway.loop_watchdog_max_strikes de 3 para 6 é o paliativo barato:
gateway:
  loop_watchdog_max_strikes: 6
Isso é um curativo, não a cura. Desligar o watchdog por completo (gateway.loop_watchdog: false) é pior: você remove o único caminho de recuperação para um loop genuinamente travado.
A quantidade de profiles é, ela mesma, um custo. Quinze profiles significam quinze conjuntos residentes de agendamento, conexões e watchers. Juntar os que são usados raramente — ou iniciá-los sob demanda — normalmente rende mais do que ajustar qualquer parâmetro.
Onde as coisas estão
A issue continua aberta. As mitigações de quem reportou são “remover os servidores MCP duplicados e ajustar o watchdog”, não uma correção de raiz. Membros da comunidade também propuseram lançar o gateway via launchd como ProcessType=Interactive (o padrão é daemon, que o coloca na prioridade 20, de modo que qualquer app em primeiro plano fica à frente dele) e dividir o lock de session.resume, hoje de escopo do processo, por profile. São propostas, não mudanças já integradas. A correção pode mudar de forma; o modelo de custo — multiplexação mais um processo filho MCP stdio por profile — não muda.
As pessoas rodam muitos profiles por isolamento: plataformas, projetos e permissões diferentes. Isolamento é o certo. Só precifique isso com honestidade, especialmente no caso de servidores stdio que você copiou para todos os profiles “por conveniência”.
Relacionado: comandos do gateway, comandos de MCP, ajuste do loop watchdog e rodando múltiplos profiles.