15 profiles, un gateway: cada servidor MCP se arrancaba 15 veces
Tienes un gateway para una docena de profiles: uno escribe código, otro investiga, otro ejecuta cron, unos cuantos están conectados a plataformas de chat distintas. Va bien — hasta que la app de escritorio empieza a reportar request timed out after 30s: session.resume, el log repite Gateway event loop missed 3 consecutive liveness probes … exiting with code 75 y curl /health tarda medio minuto. Culpas a la red, reinicias, y unas horas después vuelve a pasar.
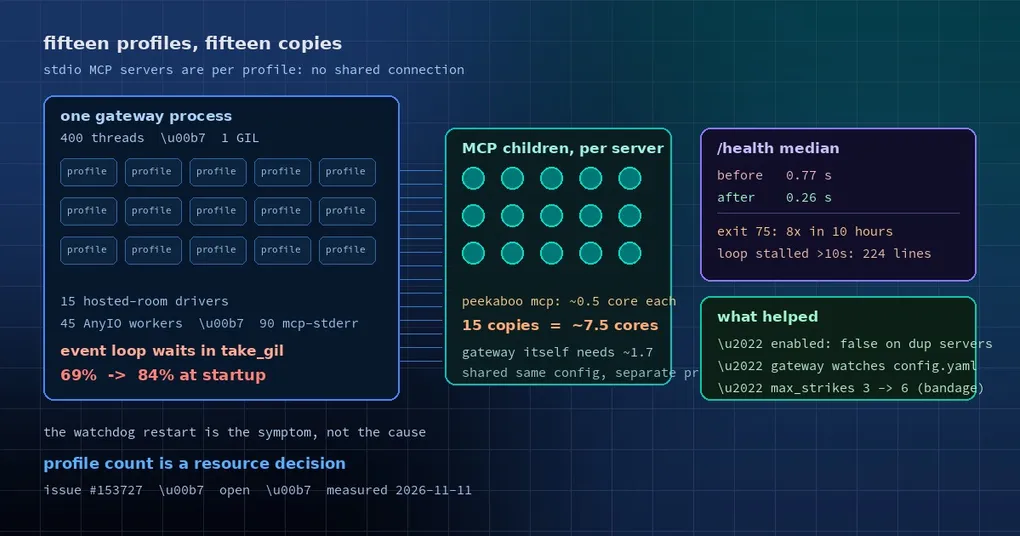
Un usuario lo midió como es debido, y la respuesta no es la red: 400 threads en un proceso de gateway, con el event loop pasando el 69% de su tiempo esperando el GIL de Python.
Los síntomas, por partes
En un host macOS con 15 profiles detrás del gateway multiplexado por defecto (un proceso sirviendo todos los profiles), muestrearon el proceso con sample <pid> durante 6–8 segundos y contaron los frames take_gil por thread:
| Métrica | Estado estable (antes) | Estado estable (después de la mitigación) | Durante el arranque |
|---|---|---|---|
| Threads del gateway | 399–401 | 400 | 152 |
Thread del event loop esperando en take_gil |
69% | 76% | 84% |
Thread del event loop idle en kevent |
0% | 2% | 15% |
Mismo periodo: el watchdog de liveness salió con código 75 ocho veces en unas diez horas; ws write slow (loop stalled >10.0s) se registró 224 veces; el session.resume de escritorio alcanzó su timeout de 30 segundos; un GET /health no recibió respuesta durante 30 segundos mientras el loop estaba atascado.
Fíjate en el «76% después». La mitigación bajó la tasa de disparo; no cambió la estructura — el loop sigue compitiendo por el GIL.
El culpable real: servidores MCP arrancados una vez por profile
El desglose de threads dice mucho: 90 threads mcp-stderr, 44–45 workers de AnyIO, 30 tokio-rt-worker y 15 threads hosted-room-driver-supervisor (uno por profile).
Lo importante es MCP. Un servidor MCP stdio es un proceso hijo, arrancado por el agente que lo usa. En un gateway multiplexado cada profile es un runtime independiente: lee su propio config.yaml y se conecta a sus propios servidores MCP. Si 15 profiles listan los mismos servidores MCP stdio, tienes 15 procesos hijo por servidor — no una conexión compartida.
Uno de los servidores de esa configuración (peekaboo mcp) vigila las notificaciones de apertura y cierre de apps y usaba más o menos medio core por copia. Quince copias son unos 7,5 cores — mientras el gateway en sí solo quiere unos 1,7.
Desactivarlo (enabled: false) movió /health de una mediana de 0,77 segundos a 0,26 y detuvo las líneas de loop stalled. El GIL no era la enfermedad; era el síntoma de quince aspiradoras funcionando en el pasillo.
Por qué un solo GIL atasca todos los profiles
Los threads de Python comparten un único lock global del intérprete. Un gateway multiplexado ejecuta todos los profiles en un proceso, así que el thread del event loop se turna con cientos de threads worker por ese lock.
Normalmente no pasa nada: los workers pasan la mayor parte del tiempo esperando IO y el lock queda libre. Pero cuando 15 procesos hijo MCP tienen cada uno su lector de stderr y 45 workers de AnyIO están activos, el lock cambia de manos constantemente — y cada vez que el SO desplanifica al que lo tiene, todos los threads del proceso esperan, incluido el que responde a los health checks, reenvía mensajes y atiende session.resume.
El watchdog entonces hace exactamente lo que se diseñó para hacer: tres timeouts de sonda consecutivos (intervalo por defecto de 30 segundos, timeout de 10) y sale con código 75 para que el supervisor reinicie el gateway. De ahí vienen los «reinicios aleatorios» — no de un crash, sino de un reinicio deliberado.
Cómo comprobar si el problema eres tú
1. Compara las listas de MCP por profile. Cada profile tiene su propia config en ~/.hermes/profiles/<name>/config.yaml. La CLI es más rápida (HERMES_PROFILE elige el profile; hermes profile list te da los nombres):
HERMES_PROFILE=<name> hermes mcp listEjecútalo para cada profile y compara los nombres de mcp_servers. Que el mismo servidor stdio aparezca en varios profiles significa varias copias del proceso.
2. Cuenta los threads. Busca el PID del gateway (hermes gateway status lo reporta) y luego lista los threads por nombre (ps -M en macOS, ps -L en Linux):
ps -L <pid> | awk '{print $NF}' | sort | uniq -c | sort -rn | headEl número de threads mcp-stderr es más o menos el número de conexiones MCP stdio vivas. Quince profiles con tres servidores cada uno son 45.
3. Mira la vista del propio gateway. hermes gateway status --deep muestra más estado; si el log repite loop stalled o exiting with code 75, deja de especular sobre problemas de red.
Cómo quitarse la carga de encima
Desactiva los servidores MCP duplicados en cada profile. Poner enabled: false en una entrada de mcp_servers hace que Hermes lo salte por completo — ni siquiera intenta conectar. La documentación también señala que un gateway en ejecución vigila config.yaml: en un minuto más o menos después de poner enabled: false (o quitar la entrada), la conexión de ese servidor se cierra, sin reiniciar y sin necesidad de /reload-mcp.
Dale a cada profile solo los servidores que necesita. Un profile que gestiona email rara vez necesita control de navegador. Alinear la superficie de herramientas con el profile ahorra recursos y reduce la superficie de ataque.
Dale margen al watchdog, pero no lo desactives. Los valores por defecto son intervalo de sonda de 30 segundos, timeout de 10 y tres strikes. Para el churn ocasional de reinicios, subir gateway.loop_watchdog_max_strikes de 3 a 6 es el apaño barato:
gateway:
  loop_watchdog_max_strikes: 6
Eso es una tirita, no una cura. Desactivar el watchdog del todo (gateway.loop_watchdog: false) es peor: eliminas la única vía de recuperación para un loop realmente atascado.
El número de profiles es en sí un coste. Quince profiles son quince conjuntos de scheduling residente, conexiones y watchers. Fusionar los que se usan poco — o arrancarlos bajo demanda — suele superar cualquier ajuste de parámetros.
En qué punto está
El issue sigue abierto. Las mitigaciones del reportero son «quitar los servidores MCP duplicados y ajustar el watchdog», no un arreglo de raíz. Miembros de la comunidad propusieron además lanzar el gateway vía launchd como ProcessType=Interactive (el valor por defecto es daemon, que lo deja en prioridad 20, por debajo de cualquier app en primer plano) y dividir por profile el lock de session.resume, que hoy es de todo el proceso. Son propuestas, no cambios fusionados. El arreglo puede cambiar de forma; el modelo de coste — multiplexado más un hijo MCP stdio por profile — no.
La gente ejecuta muchos profiles por aislamiento: plataformas distintas, proyectos distintos, permisos distintos. El aislamiento es lo correcto. Solo hay que pagarlo con honestidad, sobre todo con los servidores stdio que copiaste a todos los profiles «por comodidad».
Relacionado: comandos de gateway, comandos de MCP, ajuste del loop watchdog y ejecutar varios profiles.