15 profils, une seule gateway : chaque serveur MCP a été démarré 15 fois
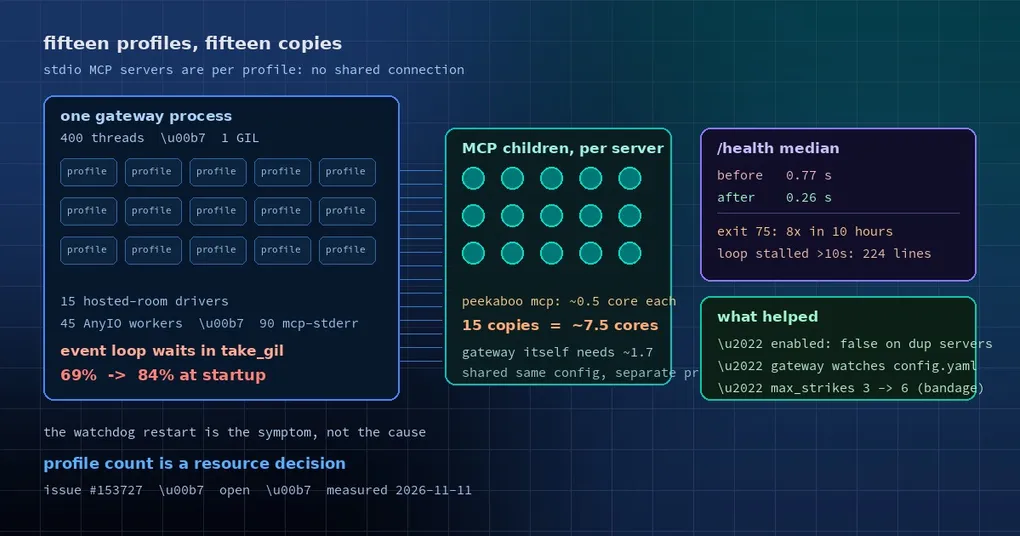
Vous faites tourner une seule gateway pour une douzaine de profils : l’un écrit du code, l’autre fait de la recherche, un troisième exécute le cron, quelques-uns sont branchés sur des plateformes de chat différentes. Tout va bien — jusqu’à ce que l’app desktop se mette à rapporter request timed out after 30s: session.resume, que le log répète Gateway event loop missed 3 consecutive liveness probes … exiting with code 75, et que curl /health prenne une demi-minute. Vous accusez le réseau, vous redémarrez, et quelques heures plus tard ça recommence.
Un utilisateur a mesuré la chose correctement, et la réponse n’est pas le réseau : 400 threads dans un seul processus gateway, avec une boucle d’événements qui passe 69 % de son temps à attendre le GIL de Python.
Les symptômes, posés à plat
Sur un hôte macOS faisant tourner 15 profils derrière la gateway multiplexée par défaut (un seul processus au service de tous les profils), il a échantillonné le processus avec sample <pid> pendant 6 à 8 secondes et compté les frames take_gil par thread :
| Métrique | Régime stable (avant) | Régime stable (après atténuation) | Pendant le démarrage |
|---|---|---|---|
| Threads de la gateway | 399–401 | 400 | 152 |
Thread de la boucle d’événements en attente dans take_gil |
69 % | 76 % | 84 % |
Thread de la boucle d’événements inactif dans kevent |
0 % | 2 % | 15 % |
Sur la même période : le watchdog de liveness est sorti avec le code 75 huit fois en une dizaine d’heures ; ws write slow (loop stalled >10.0s) a été loggé 224 fois ; le session.resume du desktop a atteint son timeout de 30 secondes ; un GET /health n’a reçu aucune réponse pendant 30 secondes, le temps que la boucle se débloque.
Remarquez le « 76 % après ». L’atténuation a réduit la fréquence du déclencheur ; elle n’a pas changé la structure — la boucle se bat toujours pour le GIL.
Le vrai coupable : des serveurs MCP démarrés une fois par profil
La répartition des threads parle d’elle-même : 90 threads mcp-stderr, 44 à 45 workers AnyIO, 30 threads tokio-rt-worker, et 15 threads hosted-room-driver-supervisor (un par profil).
MCP est la partie importante. Un serveur MCP stdio est un processus enfant, lancé par l’agent qui l’utilise. Dans une gateway multiplexée, chaque profil est un runtime indépendant : il lit son propre config.yaml et se connecte à ses propres serveurs MCP. Si 15 profils listent les mêmes serveurs MCP stdio, vous obtenez 15 processus enfants par serveur — pas une connexion partagée.
L’un des serveurs de cette installation (peekaboo mcp) surveille les notifications de lancement et de fermeture d’applications et consommait environ un demi-cœur par copie. Quinze copies, c’est environ 7,5 cœurs — alors que la gateway elle-même ne demande qu’environ 1,7.
Le désactiver (enabled: false) a fait passer /health d’une médiane de 0,77 seconde à 0,26 seconde et a arrêté les lignes loop stalled. Le GIL n’était pas la maladie ; c’était le symptôme de quinze aspirateurs qui tournaient dans le couloir.
Pourquoi un seul GIL bloque tous les profils
Les threads Python partagent un unique verrou global d’interpréteur. Une gateway multiplexée exécute tous les profils dans un seul processus, donc le thread de la boucle d’événements attend son tour pour ce verrou face à des centaines de threads de travail.
Normalement ça va : les workers passent l’essentiel de leur temps à attendre de l’IO, et le verrou reste libre. Mais quand 15 processus MCP enfants ont chacun des lecteurs stderr et que 45 workers AnyIO sont actifs, le verrou change de mains en permanence — et chaque fois que son détenteur est déplanifié par l’OS, tous les threads du processus attendent, y compris celui qui répond aux health checks, relaie les messages et traite session.resume.
Le watchdog fait alors exactement ce pour quoi il a été conçu : trois timeouts de sonde consécutifs (intervalle par défaut de 30 secondes, timeout de 10 secondes) et il sort avec le code 75 pour que le superviseur redémarre la gateway. Voilà d’où viennent les « redémarrages aléatoires » — pas un crash, un redémarrage délibéré.
Comment vérifier si vous êtes dans ce cas
1. Comparez les listes MCP par profil. Chaque profil a sa propre config dans ~/.hermes/profiles/<name>/config.yaml. Le CLI est plus rapide (HERMES_PROFILE sélectionne le profil ; hermes profile list donne les noms) :
HERMES_PROFILE=<name> hermes mcp listLancez-la pour chaque profil et comparez les noms de mcp_servers. Le même serveur stdio qui apparaît dans plusieurs profils signifie plusieurs copies du processus.
2. Comptez les threads. Trouvez le PID de la gateway (hermes gateway status l’indique), puis listez les threads par nom (ps -M sur macOS, ps -L sur Linux) :
ps -L <pid> | awk '{print $NF}' | sort | uniq -c | sort -rn | headLe nombre de threads mcp-stderr correspond à peu près au nombre de connexions MCP stdio vivantes. Quinze profils avec trois serveurs chacun, cela fait 45.
3. Regardez la vue de la gateway elle-même. hermes gateway status --deep montre davantage d’état ; si le log répète loop stalled ou exiting with code 75, arrêtez de chercher une instabilité réseau.
Comment alléger la charge
Désactivez les serveurs MCP dupliqués, profil par profil. Mettre enabled: false sur une entrée mcp_servers fait sauter Hermes complètement — il ne tente même pas de connexion. La doc précise aussi qu’une gateway en cours d’exécution surveille config.yaml : dans la minute qui suit le passage à enabled: false (ou la suppression de l’entrée), la connexion à ce serveur est démontée, sans redémarrage ni /reload-mcp.
Ne donnez à un profil que les serveurs dont il a besoin. Un profil qui traite de l’e-mail a rarement besoin du contrôle du navigateur. Aligner la surface d’outils sur le profil économise des ressources et réduit la surface d’attaque.
Laissez de la marge au watchdog, mais ne le désactivez pas. Les valeurs par défaut sont un intervalle de sonde de 30 secondes, un timeout de 10 secondes et trois échecs. En cas de redémarrages sporadiques, faire passer gateway.loop_watchdog_max_strikes de 3 à 6 est le stopgap le moins cher :
gateway:
  loop_watchdog_max_strikes: 6
C’est un pansement, pas un remède. Désactiver complètement le watchdog (gateway.loop_watchdog: false) est pire : vous supprimez le seul chemin de récupération pour une boucle réellement bloquée.
Le nombre de profils est lui-même un coût. Quinze profils, ce sont quinze jeux de scheduling résident, de connexions et de watchers. Fusionner ceux qu’on utilise rarement — ou les démarrer à la demande — bat généralement n’importe quel réglage de paramètre.
Où en sont les choses
L’issue est toujours ouverte. Les atténuations du rapporteur sont « supprimer les serveurs MCP dupliqués et régler le watchdog », pas un correctif de fond. Des membres de la communauté ont aussi proposé de lancer la gateway via launchd en ProcessType=Interactive (le défaut est daemon, ce qui la place en priorité 20, donc n’importe quelle app au premier plan la dépasse) et de scinder par profil le verrou session.resume à l’échelle du processus. Ce sont des propositions, pas des changements mergés. Le correctif peut changer de forme ; le modèle de coût — multiplexage plus un processus MCP stdio enfant par profil — ne changera pas.
On fait tourner beaucoup de profils pour l’isolation : plateformes, projets et permissions différents. L’isolation est la bonne réponse. Encore faut-il en payer le prix honnêtement, surtout pour les serveurs stdio que vous avez copiés dans chaque profil « pour plus de commodité ».
Pour aller plus loin : les commandes gateway, les commandes MCP, le réglage du loop watchdog, et faire tourner plusieurs profils.