Hermes 说你的机器能跑 27B,结果慢成幻灯片:现在它会劝你别装
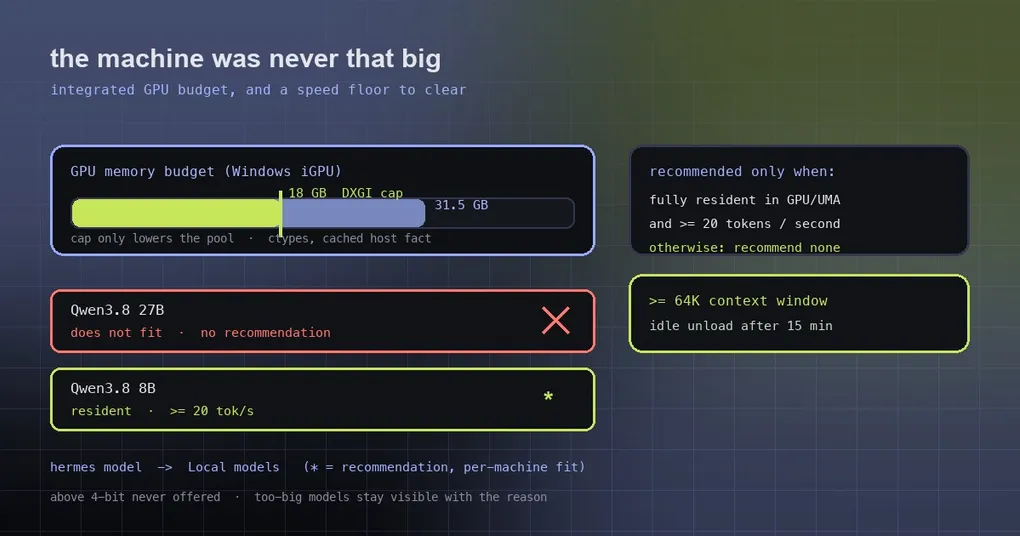
你在一台 GTX 1080、16GB 内存的机器上打开 Hermes 的本地模型界面,设置卡片写着:Qwen3.8 27B 适合这台机器。你花了半个多小时下载了二十多 GB 的权重,跑起来之后每秒两三个 token——一句完整回答要等半分钟,聊两句你就关掉了。你开始怀疑自己的硬件,其实该怀疑的是推荐逻辑。
10 月 9 日合并的 PR #135438 修掉了这个问题。它不是“调低一个阈值”那么简单:三个独立的 bug 叠在一起,才会有“16GB 的机器被推荐 27B 模型”这种结果。这篇把三处都讲清楚,顺便说清 Hermes 现在按什么标准给你推荐本地模型。
三个 bug 是怎么叠在一起的
1. 设置卡片推荐了解析器自己拒绝的模型
第一个 bug 在桌面端的设置卡片里。它的选法是:拿目录里被标为推荐的那一行,如果没有,就拿第一行被标记为“能跑”的。而“能跑”的判定很宽松——只要有一份量化版本溢出到系统内存还能跑起来,就算 fits。
于是卡片会推荐一个“能用但很慢”的模型,而真正做决策的解析器根本不会推荐它。现在的规则一致了:卡片只显示解析器认可的推荐模型;如果这台机器没有任何模型达标,就不显示卡片——不推荐,好过推荐一个错的。
2. 集成显卡被按“整机内存”记账
第二个 bug 在显存预算探测里,也是最隐蔽的一个。
当机器上没有 nvidia-smi 的答案、也没有独立的计算设备时,probe_budget 会把整机 RAM 当成统一内存来用。对 Apple Silicon 那种真·统一内存的机器这是对的;对一台带集成显卡(iGPU)的 Windows 笔记本就完全错了。PR 里举的例子很典型:一台 Intel Arc B390 的笔记本被报出 31.5 GB 显存,然后理所当然地推荐了 27B。
修法是引入一个真实的显卡内存上界:在 Windows 上通过 DXGI 读到该适配器的专用显存 + 共享内存(也就是任务管理器里那个“GPU 内存”数字),B390 那台机器实际上是 31.5 GB 里的 18 GB。技术实现是用 ctypes 调 DXGI(约 0.3 毫秒),并且把结果作为宿主机事实缓存在 hermes_platform 里——只对引擎点名的那个适配器取,或者在 Vulkan / HIP 引擎将要跑这个模型时取唯一的非 NVIDIA 适配器。
两个细节说明这个修补很克制:
- 上限只用来“压低”池子,从不用来抬高。 它不会把一台跑不满的机器吹成能跑。
- CPU 引擎(比如 Snapdragon)仍然按 RAM 记账,无论是用户主动选的,还是这台机器只有 CPU 这一种构建。
- 为什么不直接信 Vulkan 引擎自己报的数字?因为 ggml-vulkan 会把集成显卡的每一块堆都加起来,那个数字会高得离谱。
3. 解析器推荐了比自己速度底线还慢的模型
第三个 bug 最有意思:解析器违反了自己的规则。
Hermes 的推荐标准是“完全驻留在 GPU 或统一内存里、且预测速度达到每秒 20 token 以上”。但当一个常驻模型都达不到这条底线时,旧逻辑会退而推荐其中最快的一个(fastest-resident)。你想像一下:一台“32GB”、没有独立显卡的机器,预算被算错之后每个模型都常驻不了,于是它得到一个“最快”的推荐——实际上就是那个最慢的选项。
现在没有达标模型时,解析器返回“无推荐”。慢的、溢出的模型依然留在目录里可见可装,只是不再挂推荐标签——降级是可选的,而且你得自己看见代价。推荐理由也变得可解释:product-default(厂商指定且常驻)、best-quality-resident(质量优先且达到舒适底线)、speed-gated-quality(达到底线,但更高的质量档被速度刷掉了)。
现在按什么标准推荐
综合三处修复,今天的行为是:
- 只有完全跑在 GPU 或统一内存里、且预测 ≥ 20 tok/s 的模型才会被推荐;
- 推荐的是满足条件的里面质量最高的那一档量化;
- 一个模型都不达标 → 不推荐,但目录里仍然列出每一个“能跑”的选项;
- 一台机器最多有一个“默认推荐”,厂商可以在系统里指定别的默认——只要它能常驻,Hermes 就听厂商的。
顺带几条现在还成立的规则(值得记住,因为它们解释了为什么有些模型你永远看不到低质量版本):Hermes 从不提供低于 4-bit 的构建,因为质量损失太大;一个连 4-bit 都要溢出到系统内存才能跑的模型,等于这台机器跑不了它;装不下的模型依然显示,并附上原因,方便你知道升级什么硬件能解锁它。
怎么自己核对
hermes model # 选择 "Local models"在终端里走这条路,Hermes 会按你这台机器定价列出目录:★ 标出推荐项,每一行给出内存适配(绿色=完全在显存里跑 / 黄色=会用系统内存、更慢 / 红色=这台机器跑不了)、上下文窗口的起始值与可增长上限、以及为你硬件选中的那份构建的下载体积。模型下载页的“Find more models”会搜整个 Hugging Face,并对每个文件做一次针对你机器的适配检查——下载之前就知道它能不能完整跑在显存里。
本地模型的完整入门(引擎安装、目录、量化选择)看这份本地模型指南;模型与 provider 的切换方式在 hermes model 参考;如果你的瓶颈其实是上下文而不是显存,这份上下文优化实践更对症。
还有两条和“跑得动”直接相关的机制:每个被推荐的模型至少给 64K 上下文窗口,窗口会随对话需要增长(状态栏出现 “Context window grown” 是正常现象);装不下的时候,溢出部分按“伤害最小”的顺序放进系统内存——专家权重优先,永不牺牲注意力缓存。空闲 15 分钟会自动卸载模型释放显存,下一条消息再自动加载。
发布状态
PR #135438 合并于 2026-10-09,晚于 v0.21.6 的发布(10 月 8 日),因此目前只在 origin/main 上——想立刻用上就 hermes update。
小结
“推荐了一个跑不动的模型”看起来像一个小问题,实际代价是用户的时间、带宽和一段被败坏的第一印象。这个 PR 值得记住的地方在于它没有去调推荐阈值,而是修了三处错误的输入:卡片用一个过宽的拟合判断、显存预算把集成显卡当成整机内存、解析器在无可推荐时退回“最快的一个”。当输入正确之后,“宁可不推荐”反而成了最合理的行为——对本地模型来说,诚实的沉默比热情的误导有用得多。