Hermes empfahl einer 16-GB-Maschine, ein 27B-Modell laufen zu lassen: Jetzt sagt es Nein
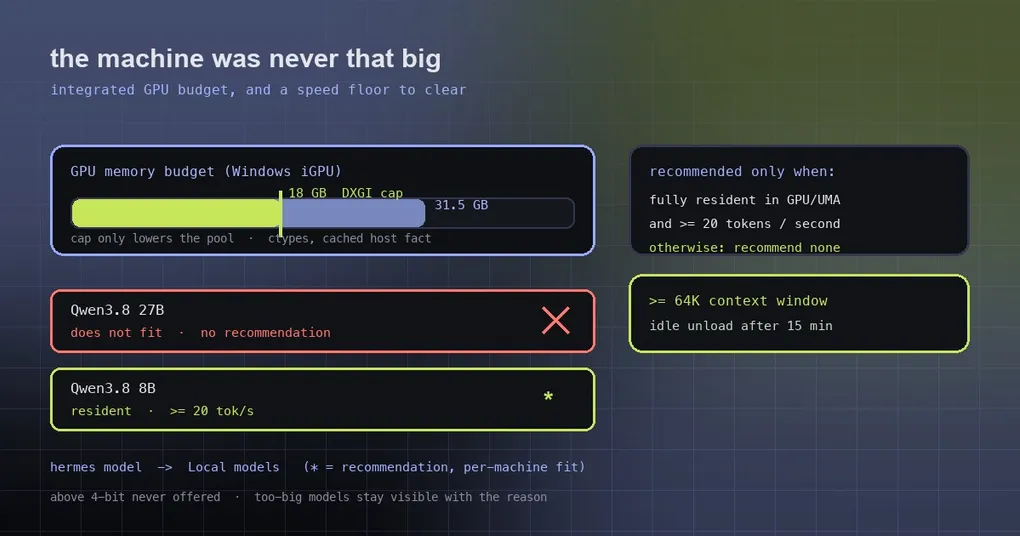
Du öffnest das Local-Models-Panel auf einer Maschine mit einer GTX 1080 und 16 GB RAM. Die Setup-Karte sagt dir: Qwen3.8 27B passt auf diese Maschine. Du verbringst eine halbe Stunde damit, gut zwanzig Gigabyte an Gewichten zu ziehen, führst es aus und bekommst zwei oder drei Tokens pro Sekunde — eine halbe Minute für eine Antwort. Nach zwei Nachrichten brichst du ab. Du beginnst, an deiner Hardware zu zweifeln. Was du hättest anzweifeln sollen, war die Empfehlung.
PR #135438 hat das am 9. Oktober behoben, und es geht nicht darum, eine einzelne Schwelle zu verschieben: Drei separate Bugs stapelten sich, um auf einer 16-GB-Kiste eine 27B-Empfehlung zu erzeugen. Hier sind alle drei und der Standard, den Hermes jetzt verwendet, um ein lokales Modell zu empfehlen.
Wie sich die drei Bugs stapelten
1. Die Setup-Karte bot Modelle an, die der Resolver selbst ablehnt
Der erste Bug saß in der Setup-Karte der Desktop-App. Ihre Auswahlregel war: Nimm die empfohlene Katalog-Zeile; wenn das scheitert, nimm die erste Zeile, die als passend markiert ist. Und „passt“ war großzügig — jeder Build, der überhaupt läuft, selbst in den System-RAM gespült, zählte.
Die Karte konnte also ein Modell empfehlen, das funktioniert, aber kriecht, während der Resolver, der die eigentliche Entscheidung trifft, es nie vorgeschlagen hätte. Die Regel ist jetzt an beiden Stellen dieselbe: Die Karte benennt das vom Resolver empfohlene Modell, und eine Maschine ohne Empfehlung bekommt gar keine Karte. Nichts zu empfehlen ist besser, als Falsches zu empfehlen.
2. Einer integrierten GPU wurde der gesamte System-RAM zugestanden
Der zweite Bug ist der hinterhältigste, und er sitzt in der Speicherbudget-Sonde.
Ohne Antwort von nvidia-smi und ohne diskretes Compute-Gerät behandelte probe_budget den gesamten System-RAM als Unified Memory. Auf einer echten Unified-Memory-Maschine wie einem Apple-Silicon-Laptop ist das korrekt. Auf einem Windows-Laptop mit integrierter GPU ist es gründlich falsch — das Beispiel des PR ist ein Intel-Arc-B390-Laptop, dem 31,5 GB „GPU-Speicher“ zugeschrieben wurden, was ein 27B-Modell offensichtlich erscheinen lässt.
Der Fix führt eine echte Obergrenze ein: Unter Windows wird der dedizierte plus geteilte Videospeicher des Adapters über DXGI ausgelesen (dieselbe Zahl, die der Task-Manager als „GPU memory“ anzeigt) — 18 GB von diesen 31,5 auf dem B390. Sie wird mit ctypes in etwa 0,3 ms geholt und als Host-Fakt in hermes_platform gecacht, für den Adapter, den die Engine benannt hat, oder andernfalls den einzigen Nicht-NVIDIA-Adapter, wenn eine Vulkan- oder HIP-Engine das Modell ausführen wird.
Zwei Details zeigen, wie sorgfältig das abgegrenzt wurde:
- Die Obergrenze senkt den Pool nur, hebt ihn nie. Sie kann eine Maschine nicht leistungsfähiger erscheinen lassen, als sie ist.
- Die CPU-Engine behält das RAM-Budget (etwa ein Snapdragon), ob der Nutzer sie gewählt hat oder ob sie der einzige verfügbare Build ist.
- Und warum nicht die eigene Zahl der Vulkan-Engine vertrauen? Weil ggml-vulkan jeden Heap einer integrierten GPU summiert und deshalb überschießt.
3. Der Resolver empfahl Modelle unterhalb seiner eigenen Geschwindigkeitsuntergrenze
Der dritte Bug ist der interessanteste: Der Resolver brach seine eigene Regel.
Hermes empfiehlt das qualitativ hochwertigste Modell, das vollständig im GPU- oder Unified Memory mit einer vorhergesagten Geschwindigkeit von 20 Tokens pro Sekunde oder mehr läuft. Wenn aber kein residentes Modell diese Untergrenze erreichte, fiel der alte Code darauf zurück, das schnellste von ihnen zu empfehlen (fastest-resident). Stell dir eine „32-GB“-Maschine ohne diskrete GPU vor, deren Budget falsch berechnet wurde, sodass nichts resident läuft — sie bekommt eine „schnellste“-Empfehlung, die in Wahrheit nur die am wenigsten langsame Option ist.
Wenn jetzt nichts die Untergrenze erreicht, gibt der Resolver keine Empfehlung zurück. Langsame und gespillte Modelle bleiben sichtbar und auswählbar — sie tragen nur nicht das Empfehlungs-Badge, sodass der Einstieg in eine verschlechterte Erfahrung eine Wahl ist, die du sehen kannst. Die Begründungs-Keys wurden auch erklärbar: product-default (die Wahl des Herstellers, und sie läuft resident), best-quality-resident (Qualität gewann unter residenten Modellen oberhalb der Untergrenze) und speed-gated-quality (die Wahl erreicht die Untergrenze, aber die Untergrenze eliminierte einen höherwertigen Kandidaten).
Was die Empfehlung jetzt bedeutet
Fasst man die drei Fixes zusammen, ist das heutige Verhalten:
- nur ein Modell, das vollständig im GPU- oder Unified Memory mit einer vorhergesagten ≥ 20 Tokens pro Sekunde läuft, bekommt eine Empfehlung;
- unter diesen gewinnt die höchste Qualitätsnote;
- wenn nichts qualifiziert, wird nichts empfohlen — aber jedes Modell, das passt, bleibt sichtbar;
- eine Maschine hat höchstens eine Default-Wahl, und der Hersteller kann eine andere setzen; Hermes respektiert sie, wann immer sie passt.
Ein paar Regeln gelten weiterhin und erklären, warum du nie ultra-kleine Builds angeboten siehst: Hermes geht nie unter 4-Bit, weil der Qualitätsverlust zu schwerwiegend ist; ein Modell, dessen 4-Bit-Build in den System-RAM spillen muss, kann auf dieser Maschine schlicht nicht laufen; und Modelle, die nicht passen, bleiben sichtbar mit dem Grund, sodass du weißt, was ein Hardware-Upgrade freischalten würde.
Selbst nachprüfen
hermes model # wähle dann "Local models"Vom Terminal aus wird der Katalog gegen deine Maschine bepreist: Ein ★ markiert die Empfehlung, und jede Zeile zeigt die Speicher-Passung (grün = läuft vollständig im GPU-Speicher, gelb = funktioniert, aber langsamer über den System-RAM, rot = zu groß), das Context-Window, mit dem sie startet, und sein Maximum sowie die Download-Größe des für deine Hardware ausgewählten Builds. Find more models durchsucht ganz Hugging Face und gibt jeder Datei eine dateiweise Passungsprüfung, zugeschnitten auf deine Maschine, sodass du schon vor dem Download weißt, ob sie vollständig im VRAM läuft.
Für den vollständigen Local-Models-Durchgang — Engine-Installation, Katalog, Quantisierungsentscheidungen — siehe unseren Local-Models-Guide; Provider- und Modellwechsel werden in der hermes-model-Referenz behandelt. Wenn deine eigentliche Einschränkung Context statt VRAM ist, passt dieser Context-Optimierungs-Artikel besser.
Zwei Mechanismen sind wissenswert, weil sie beeinflussen, was „es läuft“ in der Praxis bedeutet: Jedes empfohlene Modell bekommt mindestens ein 64K-Context-Window, und das Window wächst mit dem Bedarf der Konversation (im Status-Feed „Context window grown“ zu sehen ist normal). Wenn ein Modell größer ist als dein GPU-Speicher, wird der Überlauf in der Reihenfolge in den System-RAM gelegt, die am wenigsten schadet — zuerst Expert-Weights, niemals der Attention-Cache. Idle Modelle entladen nach 15 Minuten, um VRAM freizugeben, und laden bei der nächsten Nachricht neu.
Release-Status
PR #135438 wurde am 2026-10-09 gemergt, nachdem v0.21.6 am 8. Oktober ausgeliefert wurde, also ist er im Moment nur auf origin/main — führe hermes update aus, um ihn heute zu bekommen.
Das Fazit
„Ein Modell empfohlen, das nicht laufen kann“ sieht nach einem kleinen Bug aus. Der echte Preis ist die Zeit des Nutzers, Bandbreite und ein ruinierter erster Eindruck. Was diesen PR denkwürdig macht, ist, dass er die Empfehlungsschwelle überhaupt nicht berührt hat — er hat drei falsche Eingaben korrigiert: eine Karte mit einem zu großzügigen Passungstest, ein Speicherbudget, das eine integrierte GPU als ganze Maschine behandelte, und einen Resolver, der sich auf „das schnellste“ zurückzog, wenn nichts qualifizierte. Mit korrigierten Eingaben stellte sich heraus, dass nichts zu empfehlen das ehrliche Verhalten ist. Bei lokalen Modellen schlägt ein wahrhaftiges Schweigen eine begeisterte Lüge.