Hermes a conseillé à une machine de 16 GB de faire tourner un modèle 27B : maintenant, il dit non
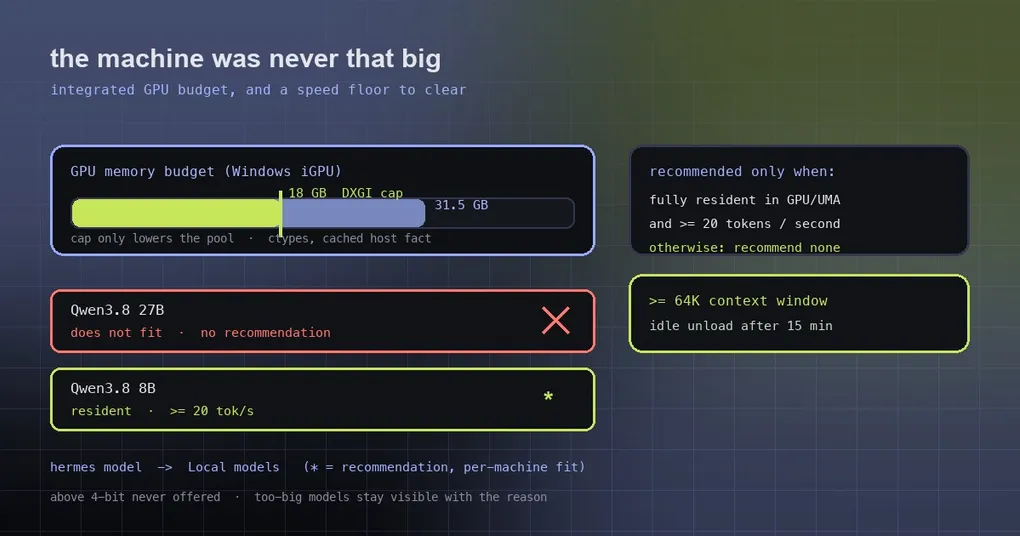
Vous ouvrez le panneau des modèles locaux sur une machine dotée d’une GTX 1080 et de 16 GB de RAM. La carte d’installation vous annonce : Qwen3.8 27B tient sur cette machine. Vous passez une demi-heure à tirer une vingtaine de gigaoctets de poids, le lancez, et obtenez deux ou trois tokens par seconde — une demi-minute pour une seule réponse. Deux messages plus tard, vous abandonnez. Vous commencez à douter de votre matériel. Ce dont vous auriez dû douter, c’était la recommandation.
La PR #135438 l’a corrigé le 9 octobre, et il ne s’agit pas d’ajuster un seul seuil : trois bugs distincts se sont empilés pour produire une recommandation de 27B sur une machine de 16 GB. Voici les trois, et le standard qu’Hermes utilise désormais pour recommander un modèle local.
Comment les trois bugs se sont empilés
1. La carte d’installation proposait des modèles que le resolver lui-même refuse
Le premier bug vivait dans la carte d’installation du desktop. Sa règle de sélection était : prendre la ligne recommandée du catalogue ; à défaut, prendre la première ligne marquée comme tenant. Et « tenant » était généreux — tout build qui tourne tant bien que mal, même spillé dans la RAM système, comptait.
Ainsi, la carte pouvait recommander un modèle qui fonctionne mais rampe, alors que le resolver qui prend réellement la décision ne l’aurait jamais suggéré. La règle est désormais la même aux deux endroits : la carte nomme le modèle recommandé par le resolver, et une machine sans recommandation n’obtient aucune carte du tout. Ne rien recommander vaut mieux que recommander faux.
2. Un GPU intégré s’est vu budgéter toute la RAM système
Le deuxième bug est le plus sournois, et il vit dans la sonde de budget mémoire.
Sans réponse de nvidia-smi ni dispositif de calcul discret, probe_budget traitait toute la RAM système comme de la mémoire unifiée. Sur une vraie machine à mémoire unifiée comme un portable Apple Silicon, c’est correct. Sur un portable Windows avec un GPU intégré, c’est gravement faux — l’exemple de la PR est un portable Intel Arc B390 annoncé comme ayant 31.5 GB de « GPU memory », ce qui fait paraître un modèle 27B évident.
Le correctif introduit un vrai plafond : sous Windows, la mémoire vidéo dédiée plus partagée de l’adaptateur est lue via DXGI (la même valeur que le Gestionnaire des tâches affiche comme « GPU memory ») — 18 GB sur les 31.5 du B390. Elle est récupérée avec ctypes en environ 0.3 ms et mise en cache comme fait d’hôte dans hermes_platform, pour l’adaptateur nommé par le moteur, ou sinon le seul adaptateur non-NVIDIA quand un moteur Vulkan ou HIP fera tourner le modèle.
Deux détails montrent avec quel soin cela a été délimité :
- Le plafond ne fait que baisser le pool, jamais l’augmenter. Il ne peut pas faire paraître une machine plus capable qu’elle ne l’est.
- Le moteur CPU conserve le budget RAM (un Snapdragon, par exemple), que l’utilisateur l’ait choisi ou qu’il soit le seul build disponible.
- Et pourquoi ne pas faire confiance au chiffre du moteur Vulkan lui-même ? Parce que ggml-vulkan additionne chaque heap d’un GPU intégré, donc il dépasse la réalité.
3. Le resolver recommandait des modèles sous son propre plancher de vitesse
Le troisième bug est le plus intéressant : le resolver enfreignait sa propre règle.
Hermes recommande le modèle de la plus haute qualité qui tourne entièrement en GPU ou en mémoire unifiée à une vitesse prévue de 20 tokens par seconde ou plus. Mais quand aucun modèle résident ne franchissait ce plancher, l’ancien code retombait sur la recommandation du plus rapide d’entre eux (fastest-resident). Imaginez une machine « 32 GB » sans GPU discret dont le budget a été mal calculé, de sorte que rien ne tourne en résident — elle obtient une recommandation « fastest », qui n’est en réalité que l’option la moins lente.
Désormais, quand rien ne franchit le plancher, le resolver ne renvoie aucune recommandation. Les modèles lents et spillés restent visibles et sélectionnables — ils ne portent simplement pas le badge de recommandation, si bien qu’opter pour une expérience dégradée est un choix que vous pouvez voir. Les clés de raison sont devenues explicables elles aussi : product-default (le choix du fabricant, et il tourne en résident), best-quality-resident (la qualité l’a emporté parmi les modèles résidents au-dessus du plancher), et speed-gated-quality (le choix franchit le plancher, mais le plancher a éliminé un candidat de meilleure qualité).
Ce que signifie la recommandation désormais
En combinant les trois correctifs, le comportement actuel est le suivant :
- seul un modèle qui tourne entièrement en GPU ou en mémoire unifiée à une vitesse prévue de ≥ 20 tokens par seconde est recommandé ;
- parmi ceux-ci, c’est la note de qualité la plus élevée qui l’emporte ;
- si rien ne se qualifie, rien n’est recommandé — mais tout modèle qui tient reste visible ;
- une machine a au plus un choix par défaut, et le fabricant peut en définir un autre ; Hermes le respecte chaque fois qu’il tient.
Quelques règles qui tiennent toujours, et qui expliquent pourquoi vous ne voyez jamais de builds ultra-petits proposés : Hermes ne descend jamais en dessous de 4 bits, car la perte de qualité est trop sévère ; un modèle dont le build 4 bits doit se spiller dans la RAM système ne peut tout simplement pas tourner sur cette machine ; et les modèles qui ne tiennent pas restent visibles avec la raison, afin que vous sachiez ce qu’une mise à niveau matérielle débloquerait.
Vérifier par vous-même
hermes model # puis choisissez « Local models »Depuis un terminal, le catalogue est évalué en fonction de votre machine : un ★ marque la recommandation, et chaque ligne affiche l’adéquation mémoire (vert = tourne entièrement en mémoire GPU, ambre = fonctionne mais plus lentement via la RAM système, rouge = trop gros), le context window avec lequel il démarre et son maximum, et la taille de téléchargement du build sélectionné pour votre matériel. Find more models parcourt tout Hugging Face et donne à chaque fichier une vérification d’adéquation dimensionnée pour votre machine, afin que vous sachiez avant de télécharger s’il tourne entièrement en VRAM.
Pour le parcours complet des modèles locaux — installation du moteur, catalogue, choix de quantization — voir notre guide des modèles locaux ; le changement de provider et de modèle est couvert dans la référence hermes model. Si votre vraie contrainte est le contexte plutôt que la VRAM, cet article sur l’optimisation du contexte convient mieux.
Deux mécanismes valent la peine d’être connus car ils affectent ce que « il tourne » signifie en pratique : tout modèle recommandé obtient au moins un context window de 64K, et la fenêtre grandit à mesure que la conversation en a besoin (voir « Context window grown » dans le flux de statut est normal). Quand un modèle est plus grand que votre mémoire GPU, le débordement est placé dans la RAM système dans l’ordre qui fait le moins mal — les poids d’experts d’abord, jamais le cache d’attention. Les modèles inactifs se déchargent après 15 minutes pour libérer la VRAM et se rechargent au message suivant.
Statut des releases
La PR #135438 a été fusionnée le 2026-10-09, après la sortie de la v0.21.6 le 8 octobre, donc elle est uniquement sur origin/main pour l’instant — exécutez hermes update pour l’obtenir aujourd’hui.
À retenir
« A recommandé un modèle qui ne peut pas tourner » ressemble à un petit bug. Le vrai coût, c’est le temps de l’utilisateur, sa bande passante et une première impression gâchée. Ce qui rend cette PR mémorable, c’est qu’elle n’a pas du tout touché au seuil de recommandation — elle a corrigé trois entrées erronées : une carte utilisant un test d’adéquation trop généreux, un budget mémoire qui traitait un GPU intégré comme une machine entière, et un resolver qui se repliait sur « le plus rapide » quand rien ne se qualifiait. Les entrées corrigées, recommander rien s’est révélé être le comportement honnête. Pour les modèles locaux, un silence véridique vaut mieux qu’un mensonge enthousiaste.