Hermes le dijo a una máquina de 16 GB que ejecutara un modelo de 27B: ahora dice que no
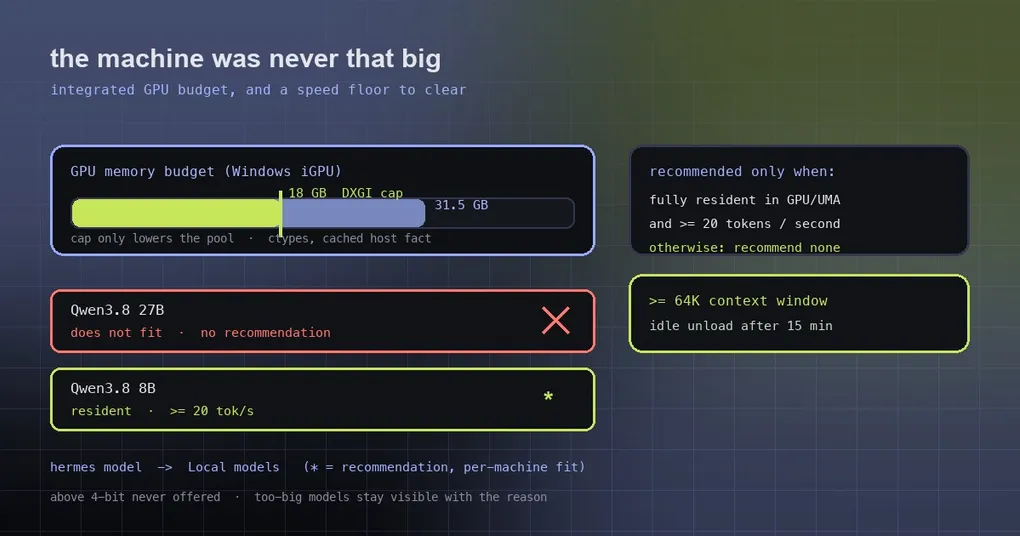
Abres el panel de modelos locales en una máquina con una GTX 1080 y 16 GB de RAM. La tarjeta de configuración te dice: Qwen3.8 27B cabe en esta máquina. Te pasas media hora descargando veinte y pico gigabytes de pesos, lo ejecutas y obtienes dos o tres tokens por segundo: medio minuto por respuesta. Al segundo mensaje, lo dejas. Empiezas a dudar de tu hardware. Lo que deberías haber dudado era la recomendación.
El PR #135438 lo corrigió el 9 de octubre, y no se trata de retocar un umbral: tres bugs distintos se apilaron para producir una recomendación de 27B en una máquina de 16 GB. Aquí están los tres, y el estándar que Hermes usa ahora para recomendar un modelo local.
Cómo se apilaron los tres bugs
1. La tarjeta de configuración ofrecía modelos que el propio resolver rechaza
El primer bug vivía en la tarjeta de configuración de escritorio. Su regla de selección era: toma la fila recomendada del catalog; si no, toma la primera fila marcada como compatible. Y «compatible» era generoso: cualquier build que arrancara, aunque se derramara en la RAM del sistema, contaba.
Así, la tarjeta podía recomendar un modelo que funciona pero va lentísimo, mientras el resolver que en realidad toma la decisión nunca lo habría sugerido. La regla ahora es la misma en ambos sitios: la tarjeta nombra el modelo recomendado por el resolver, y una máquina sin recomendación se queda con ninguna tarjeta. Recomendar nada es mejor que recomendar mal.
2. A una GPU integrada se le presupuestó toda la RAM del sistema
El segundo bug es el más traicionero, y vive en la sonda del presupuesto de memoria.
Sin respuesta de nvidia-smi y sin un dispositivo de cómputo discreto, probe_budget trataba toda la RAM del sistema como memoria unificada. En una máquina real de memoria unificada como un portátil Apple Silicon eso es correcto. En un portátil Windows con una GPU integrada es un error grave: el ejemplo del PR es un portátil Intel Arc B390 reportado como con 31,5 GB de «GPU memory», lo que hace que un modelo de 27B parezca obvio.
El arreglo introduce un techo real: en Windows, la memoria de vídeo dedicada más compartida del adaptador se lee a través de DXGI (la misma cifra que el Administrador de tareas muestra como «GPU memory»): 18 GB de esos 31,5 en el B390. Se obtiene con ctypes en unos 0,3 ms y se cachea como un hecho del host en hermes_platform, para el adaptador que nombró el engine, o, si no, el único adaptador no NVIDIA cuando un engine Vulkan o HIP vaya a ejecutar el modelo.
Dos detalles muestran con cuánto cuidado se acotó esto:
- El tope solo baja el pool, nunca lo sube. No puede hacer que una máquina parezca más capaz de lo que es.
- El engine de CPU conserva el presupuesto de RAM (un Snapdragon, por ejemplo), ya sea porque el usuario lo eligió o porque es el único build disponible.
- ¿Y por qué no fiarse del propio número del engine Vulkan? Porque ggml-vulkan suma todos los heap de una GPU integrada, así que se pasa de largo.
3. El resolver recomendaba modelos por debajo de su propio suelo de velocidad
El tercer bug es el más interesante: el resolver incumplía su propia regla.
Hermes recomienda el modelo de mayor calidad que se ejecute por completo en GPU o memoria unificada a una velocidad prevista de 20 tokens por segundo o más. Pero cuando ningún modelo residente superaba ese suelo, el código antiguo recaía en recomendar el más rápido de ellos (fastest-resident). Imagina una máquina «de 32 GB» sin GPU discreta cuyo presupuesto se calculó mal, de modo que nada se ejecuta residente: recibe una recomendación «más rápido», que en realidad es solo la opción menos lenta.
Ahora, cuando nada supera el suelo, el resolver no devuelve ninguna recomendación. Los modelos lentos y derramados siguen visibles y seleccionables: simplemente no llevan la insignia de recomendación, así que optar por una experiencia degradada es una elección que puedes ver. Las claves de motivo también pasaron a ser explicables: product-default (la elección del fabricante, y se ejecuta residente), best-quality-resident (la calidad ganó entre los modelos residentes por encima del suelo) y speed-gated-quality (la elección supera el suelo, pero el suelo eliminó a un candidato de mayor calidad).
Qué significa ahora la recomendación
Juntando los tres arreglos, el comportamiento actual es:
- solo se recomienda un modelo que se ejecute por completo en GPU o memoria unificada a una velocidad prevista de ≥ 20 tokens por segundo;
- entre esos, gana el grado de calidad más alto;
- si nada cumple, no se recomienda nada, pero todo modelo que quepa sigue visible;
- una máquina tiene como mucho una elección por defecto, y el fabricante puede fijar otra distinta; Hermes la respeta siempre que quepa.
Unas cuantas reglas que siguen en pie, y que explican por qué nunca ves ofrecidos builds ultrapequeños: Hermes nunca baja de 4 bits, porque la pérdida de calidad es demasiado severa; un modelo cuyo build de 4 bits tenga que derramarse en la RAM del sistema simplemente no puede ejecutarse en esa máquina; y los modelos que no caben siguen visibles con el motivo, para que sepas qué desbloquearía una mejora de hardware.
Comprobarlo tú mismo
hermes model # después elige "Local models"Desde un terminal, el catalog se valora contra tu máquina: una ★ marca la recomendación, y cada fila muestra el ajuste de memoria (verde = se ejecuta por completo en memoria de GPU, ámbar = funciona pero más lento vía RAM del sistema, rojo = demasiado grande), el context window con el que arranca y su máximo, y el tamaño de descarga del build seleccionado para tu hardware. Find more models busca en todo Hugging Face y da a cada archivo una comprobación de ajuste por archivo dimensionada para tu máquina, así que sabes antes de descargar si se ejecuta del todo en VRAM.
Para el recorrido completo de modelos locales —instalación de engine, catalog, elecciones de cuantización—, consulta nuestra guía de modelos locales; el cambio de proveedor y de modelo se cubre en la referencia de hermes model. Si tu restricción real es el context más que la VRAM, este artículo sobre optimización de context te encaja mejor.
Dos mecanismos merecen conocerse porque afectan a lo que significa «se ejecuta» en la práctica: todo modelo recomendado recibe al menos un context window de 64K, y la ventana crece según lo necesite la conversación (ver «Context window grown» en el feed de estado es normal). Cuando un modelo es más grande que tu memoria de GPU, el desbordamiento se coloca en la RAM del sistema en el orden que menos daño hace: primero los pesos de expertos, nunca la attention cache. Los modelos inactivos se descargan tras 15 minutos para liberar VRAM y se recargan al siguiente mensaje.
Estado de la release
El PR #135438 se fusionó el 2026-10-09, después de que v0.21.6 se publicara el 8 de octubre, así que ahora mismo está solo en origin/main: ejecuta hermes update para tenerlo hoy.
La conclusión
«Recomendó un modelo que no puede ejecutarse» parece un bug pequeño. El coste real es el tiempo del usuario, el ancho de banda y una primera impresión arruinada. Lo que hace que este PR merezca recordarse es que no tocó en absoluto el umbral de recomendación: corrigió tres entradas erróneas: una tarjeta que usaba una prueba de compatibilidad demasiado generosa, un presupuesto de memoria que trataba una GPU integrada como una máquina entera, y un resolver que retrocedía a «el más rápido» cuando nada cualificaba. Con las entradas corregidas, recomendar nada resultó ser el comportamiento honesto. Para los modelos locales, un silencio veraz gana a una mentira entusiasta.