O Hermes mandou uma máquina de 16 GB rodar um modelo 27B: agora ele diz não
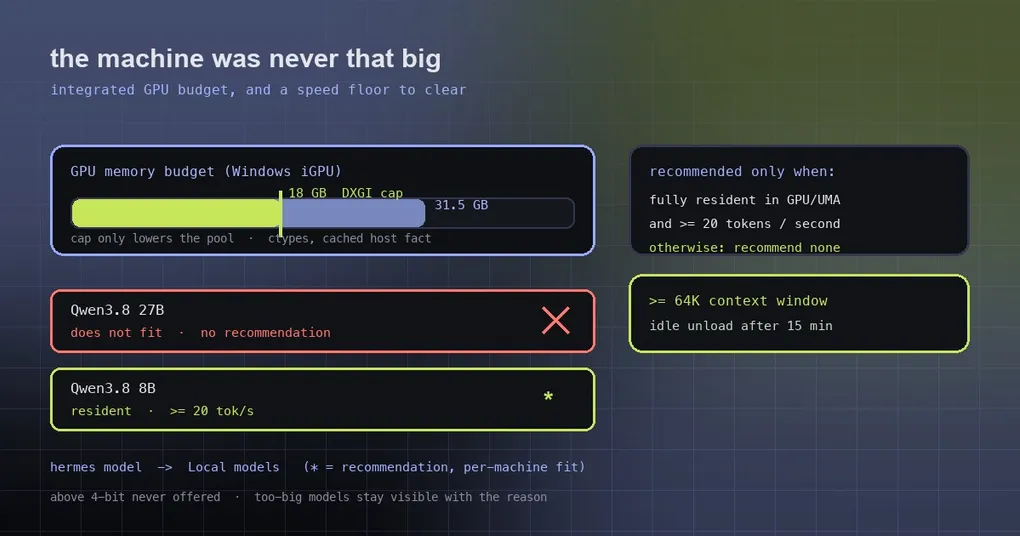
Você abre o painel de modelos locais em uma máquina com uma GTX 1080 e 16 GB de RAM. O cartão de configuração diz: o Qwen3.8 27B cabe nesta máquina. Você passa meia hora baixando uns vinte e poucos gigabytes de pesos, roda o modelo e consegue dois ou três tokens por segundo — meio minuto para uma resposta. Na segunda mensagem, você desiste. Você começa a duvidar do seu hardware. O que você deveria ter duvidado era da recomendação.
O PR #135438 corrigiu isso em 9 de outubro, e não se trata de ajustar um único limite: três bugs separados se empilharam para produzir uma recomendação de 27B em uma máquina de 16 GB. Veja os três, e o critério que o Hermes agora usa para recomendar um modelo local.
Como os três bugs se empilharam
1. O cartão de configuração oferecia modelos que o próprio resolver recusa
O primeiro bug morava no cartão de configuração do desktop. Sua regra de seleção era: pegue a linha recomendada do catálogo; se não houver, pegue a primeira linha marcada como compatível. E “compatível” era generoso — qualquer build que rodasse de algum jeito, mesmo com spill para a RAM do sistema, contava.
Então o cartão podia recomendar um modelo que funciona mas rasteja, enquanto o resolver que de fato toma a decisão nunca o teria sugerido. Agora a regra é a mesma nos dois lugares: o cartão nomeia o modelo recomendado pelo resolver, e uma máquina sem recomendação não recebe cartão nenhum. Não recomendar nada é melhor do que recomendar errado.
2. Uma GPU integrada teve toda a RAM do sistema orçada
O segundo bug é o mais sorrateiro, e mora na sonda de orçamento de memória.
Sem resposta do nvidia-smi e sem dispositivo de computação dedicado, o probe_budget tratava toda a RAM do sistema como memória unificada. Em uma máquina de memória unificada de verdade, como um notebook Apple Silicon, isso está correto. Em um notebook Windows com GPU integrada, está redondamente errado — o exemplo do PR é um notebook Intel Arc B390 reportado como tendo 31,5 GB de “memória de GPU”, o que faz um modelo 27B parecer óbvio.
A correção introduz um teto real: no Windows, a memória de vídeo dedicada mais compartilhada do adaptador é lida via DXGI (o mesmo número que o Gerenciador de Tarefas mostra como “memória de GPU”) — 18 GB dos 31,5 no B390. Ela é buscada com ctypes em cerca de 0,3 ms e armazenada em cache como um fato do host no hermes_platform, para o adaptador que o engine nomeou, ou, caso contrário, o único adaptador não NVIDIA quando um engine Vulkan ou HIP for rodar o modelo.
Dois detalhes mostram quão cuidadosamente isso foi delimitado:
- O teto só reduz o conjunto, nunca o aumenta. Ele não consegue fazer uma máquina parecer mais capaz do que é.
- O engine de CPU mantém o orçamento de RAM (um Snapdragon, digamos), quer o usuário o tenha escolhido, quer seja o único build disponível.
- E por que não confiar no próprio número do engine Vulkan? Porque o ggml-vulkan soma todos os heaps de uma GPU integrada, então ele exagera para cima.
3. O resolver recomendava modelos abaixo do seu próprio piso de velocidade
O terceiro bug é o mais interessante: o resolver quebrava a própria regra.
O Hermes recomenda o modelo de maior qualidade que roda inteiramente em GPU ou memória unificada a uma velocidade prevista de 20 tokens por segundo ou mais. Mas quando nenhum modelo residente superava esse piso, o código antigo recorria a recomendar o mais rápido deles (fastest-resident). Imagine uma máquina de “32 GB” sem GPU dedicada cujo orçamento foi calculado errado, de modo que nada roda residente — ela recebe uma recomendação de “mais rápido”, que na verdade é só a opção menos lenta.
Agora, quando nada supera o piso, o resolver não retorna recomendação alguma. Modelos lentos e com spill continuam visíveis e selecionáveis — eles só não carregam o selo de recomendação, então optar por uma experiência degradada é uma escolha que você enxerga. As chaves de motivo também ficaram explicáveis: product-default (a escolha do fabricante, e roda residente), best-quality-resident (a qualidade venceu entre os modelos residentes acima do piso) e speed-gated-quality (a escolha supera o piso, mas o piso eliminou um candidato de maior qualidade).
O que a recomendação significa agora
Juntando as três correções, o comportamento de hoje é:
- só é recomendado um modelo que roda inteiramente em GPU ou memória unificada a uma velocidade prevista de ≥ 20 tokens por segundo;
- entre esses, vence o de maior grau de qualidade;
- se nada se qualifica, nada é recomendado — mas todo modelo que cabe continua visível;
- uma máquina tem no máximo uma escolha padrão, e o fabricante pode definir uma diferente; o Hermes a respeita sempre que ela cabe.
Algumas regras que continuam valendo, e explicam por que você nunca vê builds ultra pequenos sendo oferecidos: o Hermes nunca desce abaixo de 4-bit, porque a perda de qualidade é severa demais; um modelo cujo build de 4-bit precisa fazer spill para a RAM do sistema simplesmente não roda nessa máquina; e modelos que não cabem continuam visíveis com o motivo, para você saber o que um upgrade de hardware destravaria.
Verificando você mesmo
hermes model # depois escolha "Local models"A partir de um terminal, o catálogo é precificado em relação à sua máquina: um ★ marca a recomendação, e cada linha mostra o ajuste de memória (verde = roda inteiramente na memória da GPU, âmbar = funciona mas mais devagar via RAM do sistema, vermelho = grande demais), o context window com que começa e seu máximo, e o tamanho de download do build selecionado para o seu hardware. Find more models pesquisa toda a Hugging Face e dá a cada arquivo uma checagem de ajuste dimensionada para a sua máquina, então você sabe antes de baixar se ele roda totalmente na VRAM.
Para o passo a passo completo de modelos locais — instalação do engine, catálogo, escolhas de quantização — veja nosso guia de modelos locais; a troca de provider e modelo é tratada na referência de hermes model. Se sua restrição real é contexto, e não VRAM, este texto sobre otimização de contexto encaixa melhor.
Dois mecanismos vale a pena conhecer porque afetam o que “roda” significa na prática: todo modelo recomendado recebe pelo menos um context window de 64K, e a janela cresce conforme a conversa precisa (ver “Context window grown” no feed de status é normal). Quando um modelo é maior que a memória da sua GPU, o excedente é colocado na RAM do sistema na ordem que machuca menos — pesos de especialistas primeiro, nunca o cache de atenção. Modelos ociosos são descarregados após 15 minutos para liberar VRAM e recarregados na mensagem seguinte.
Status da release
O PR #135438 foi integrado em 2026-10-09, depois de a v0.21.6 ser lançada em 8 de outubro, então ele está apenas em origin/main agora — rode hermes update para obtê-lo hoje.
A conclusão
“Recomendou um modelo que não roda” parece um bug pequeno. O custo real é o tempo do usuário, a largura de banda e uma primeira impressão arruinada. O que faz este PR valer a pena ser lembrado é que ele não tocou no limite de recomendação em nada — ele corrigiu três entradas erradas: um cartão usando um teste de ajuste generoso demais, um orçamento de memória que tratava uma GPU integrada como a máquina inteira e um resolver que recuava para “o mais rápido” quando nada se qualificava. Com as entradas corrigidas, recomendar nada acabou se revelando o comportamento honesto. Para modelos locais, um silêncio sincero vence uma mentira entusiasmada.