Hermes 用上 GPT-6 Astra:为什么 /model 里找不到它?
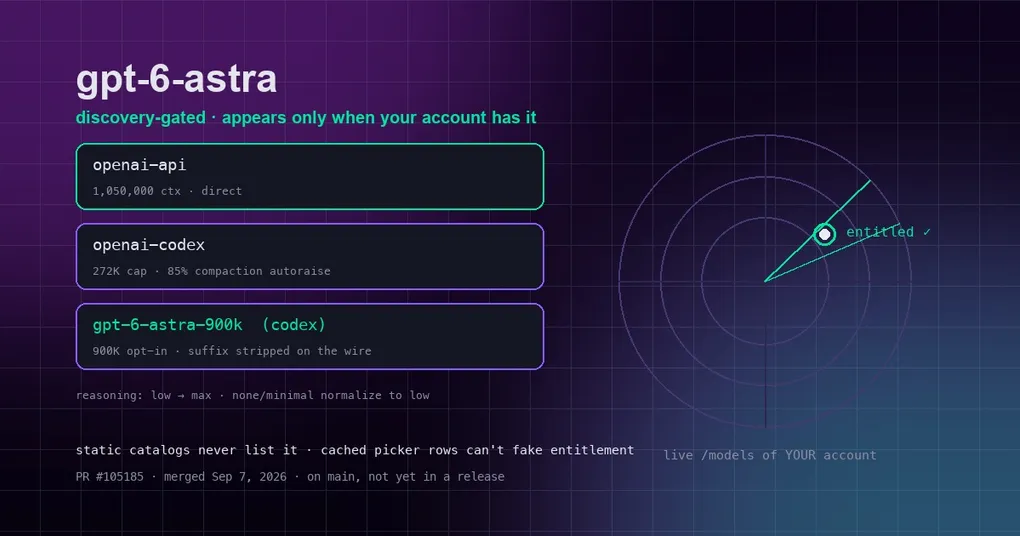
OpenAI 在 9 月 3 日发布了 GPT-6 Astra——第一代 GPT-6 旗舰模型,官方口径里“有史以来最强、对齐最好的模型”,一时间 X 和 HN 上全是它的 benchmark 截图。你兴冲冲打开 Hermes 的 /model 想切过去试试,结果把列表翻了三遍:gpt-5.6-sol 在、gpt-5.4 在,就是没有 gpt-6-astra。先别怀疑自己装了个假 Hermes——这是 Hermes 有意为之的“发现门禁”在起作用,而且这个机制恰恰是它比静态模型列表更可靠的地方。这篇文章讲清楚 Astra 怎么用、为什么找不到、以及 272K / 900K / 1.05M 这些窗口数字背后到底是什么。
先花一分钟认识 Astra
GPT-6 Astra 是 OpenAI 首款跨入 GPT-6 代际的模型,参数是单个稠密模型,没有 mini / nano 拆分。官方规格:1,050,000 token 上下文窗口、最大输出 128,000 token、知识截止 2026 年 4 月 30 日;推理强度从 low 到 max 共五档。它的重心明显偏向 agent 场景——computer-use、长程 coding、多步工具调用,OpenAI 自报在 OSWorld 2.0(让模型真实操作系统完成任务的基准)拿到 72.6%,对比 GPT-5.6 Sol 的 65.7%,大致摸到人类测试者的水平线。需要说明的是这些分数都是 OpenAI 自报,第三方复测还没跟上。
价格同样“旗舰”:每百万 token 输入 $10、输出 $50、缓存命中输入 $1、缓存写入 $12.50,另有约两倍价格的 fast 优先档。而且 OpenAI 是分阶段放量的:先给 Trusted Access 企业计划,ChatGPT Plus / Pro / Business / Enterprise 和 API 在随后几天陆续开放——“你的账号还没被放量”是找不到 Astra 的最常见原因。
为什么 /model 里找不到它:发现门禁
Hermes 对 Astra 的处理和以往任何新模型都不同:静态目录里根本没有它。过去一个新模型上线,Hermes 会在离线模型清单里直接加一行,你随时能在 /model 里看到。Astra 走了另一条路——“发现门禁”(discovery gating):
- 每次打开
/model选择器,Hermes 会调用你账号对应 provider 的/models接口做实时发现;只有 OpenAI 的响应里真的返回了gpt-6-astra,它才会出现在你的列表里。 - 缓存的选择器行、你保存的“当前模型”、甚至未登录时的目录骨架,都无法伪造出这个资格。刷新失败的兜底逻辑也是宁可把 Astra 从列表里拿掉,也不留一个点了就会报错的条目。
也就是说,你在列表里看不到它,恰恰证明 Hermes 没有拿一份“全人类通用”的目录来糊弄你——它反映的是你这个账号此刻的真实权限。等 OpenAI 给你的账号放量之后,什么都不用改,重新打开选择器它就出现了。这条设计在 PR #105185(9 月 7 日合并)里落地,顺带修掉了 Astra 直连 API 请求会抛 TypeError 的缓存参数问题。
三条路,三种窗口
同一颗 Astra,从不同通道接入,能用的上下文窗口完全不一样:
| 通道 | 模型名 | 窗口 | 说明 |
|---|---|---|---|
| OpenAI 直连 API | gpt-6-astra |
1.05M | 按 token 计费,窗口最大 |
| ChatGPT 订阅(Codex OAuth) | gpt-6-astra |
272K | Codex 后端硬性上限 |
| Codex OAuth 显式扩容 | gpt-6-astra-900k |
900K | 选择器别名,见下文 |
| OpenRouter 聚合 | openai/gpt-6-astra |
1.05M | 另有 -fast / -flex / -pro 分层 |
最常见的困惑是第二条路:为什么官方规格写 1.05M,走 Codex 订阅却只有 272K?因为 Codex 这条通道(chatgpt.com/backend-api/codex)对上下文有独立的硬性上限,Hermes 的本地元数据就按 272K 解析——这是通道限制,不是模型限制。我们的 Codex 上下文窗口文章 已经详细拆解过这个机制:Hermes 曾把 Codex slug 默认抬高到验证过的 900K,结果订阅额度肉眼可见地烧,后来改回“基础 slug 用官方 272K、900K 必须是显式 opt-in”。
第三条路的 -900k 就是那个 opt-in 机制在 Astra 身上的体现:它是 Hermes 侧的选择器别名,发往 OpenAI 时会剥掉后缀,对方看到的还是 gpt-6-astra,但 Hermes 自己按 900K 窗口来管理上下文。这个窗口是实测过的——项目源码里记录着 9 月 4 日的实测:920,043 token 的输入能通过,1,000,043 被拒。
动手切换:命令与选择器
把 Astra 设为默认模型,或者临时跑一次,命令都很直接:
# 直连 OpenAI API(需要账号对 API 也有 Astra 权限)
hermes chat --model gpt-6-astra --provider openai-api

# ChatGPT 订阅走 Codex OAuth:基础 272K 窗口
hermes chat --model gpt-6-astra --provider openai-codex

# 同一个订阅,显式打开 900K 窗口
hermes chat --model gpt-6-astra-900k --provider openai-codex
会话内按 /model 打开模糊搜索选择器(就是我们介绍过的 Ctrl+P 命令面板 里的那个),键入 astra 即可过滤;用 hermes model 可以把它设为默认。推理强度方面 Astra 支持 low/medium/high/xhigh/max 五档,none 和 minimal 在官方路由上会被自动归一成 low——OpenAI 的接口不接受“关闭思考”这类请求。日常跑任务用 low 或 medium 就好,省 token 也够快。
272K 不只是上限,还是一道账单悬崖
为什么 Hermes 不默认给订阅用户上 900K?因为对 OpenAI 来说,272K 是一道整请求计费门槛:一旦单次请求超过 272K token,整个请求(不是超出部分)都按更高档重新计价——输入从 $10/M 跳到 $20/M,输出从 $50/M 跳到 $75/M,缓存命中也从 $1/M 涨到 $2/M。也就是说超过 272K 的那一瞬间,这次调用的账单直接翻倍。再加上 Codex 订阅模式下每次工具调用都会把大上下文重新读一遍,缓存读取成本随窗口线性膨胀。
所以“基础 slug 默认 272K”不是功能缩水,恰恰是 Hermes 替你踩过坑之后的工程决定:默认值应该让大多数人省钱,而不是让少数长任务舒服。真遇到需要把整个代码库或一整天会话都塞进去的任务,再显式切 -900k,为这个窗口付更高的单价是值得的。
什么时候触发压缩:85% 自动抬升
窗口越大不代表能装得越满——Hermes 在上下文用到一定比例时会自动压缩(把中间历史归纳成摘要),默认触发点是窗口的 50%。问题来了:Astra 走 Codex 通道只有 272K,50% 触发意味着会话到 ~136K 就开始压缩,对一颗 1.05M 窗口的旗舰模型来说实在太早,浪费了它真正的长程能力。
所以 Hermes 给 Codex 通道上的 Astra(以及同路的 gpt-5.4 / 5.5 / 5.6)开了压缩阈值自动抬升:触发点从 50% 提到 85%,也就是 ~231K 才开始压缩,几乎用满整个 272K 窗口。-900k 别名和 OpenRouter 等其他通道不受影响,仍按全局 50%。如果你不喜欢这个行为,配置里的 codex_gpt55_autoraise(历史键名,默认 true)可以关掉;codex_gpt55_autoraise_notice 控制那条一次性提示横幅。
现在的状态:在 main 上,等下一个版本
最后说清楚“现在能不能用”:Astra 的接入在 9 月 7 日合并进主分支(PR #105185,加上配套的 #104762 压缩阈值修复),还没有进入任何正式发布版——8 月 31 日的 v0.21.0 Pantheon 发布时这个支持还不存在。等下一个版本发布后,一条 hermes update 就能拿到;急着尝鲜可以跑 dev 构建或从源码构建。同时记住前置条件:你的 OpenAI 账号得先被 Astra 放量。如果你现在看不到它,最可能的解释不是 Hermes 坏了,而是 OpenAI 还没轮到你——耐心等几天,重新打开 /model 再看看。
一句话总结:Astra 是 Hermes 第一个“发现门禁”式模型,列表里看不到 = 账号没权限,这是诚实的表现;而 272K 默认窗口 + 85% 压缩阈值这套组合,本质是 Hermes 在“省你的钱”和“用满模型能力”之间帮你守住了平衡点。