Como correr o GPT-6 Astra no Hermes — e porque é que ele falta na tua lista /model
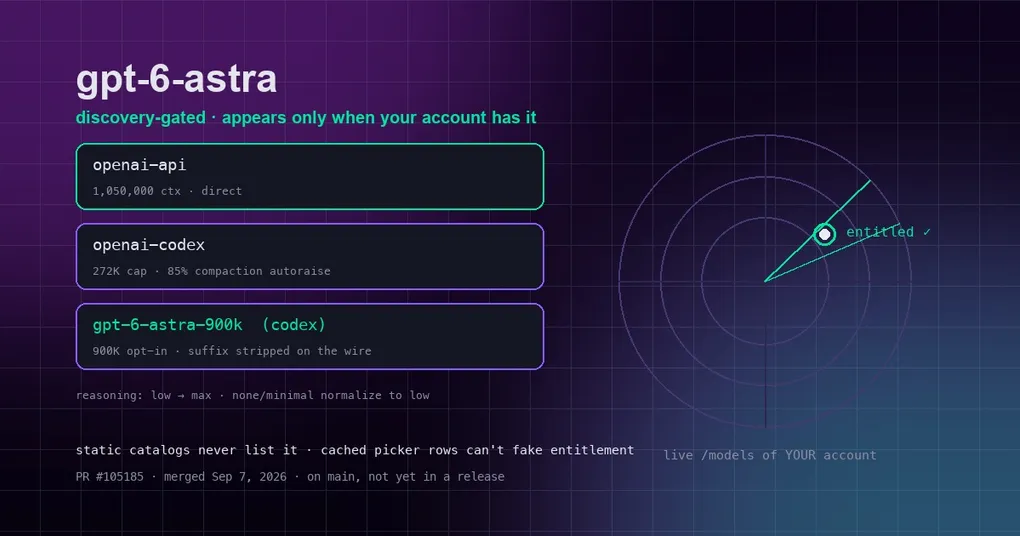
A OpenAI lançou o GPT-6 Astra a 3 de setembro — o seu primeiro flagship da geração GPT-6, apresentado como o modelo mais capaz e alinhado até à data — e em poucas horas o X e o Hacker News estavam cheios de capturas de ecrã de benchmarks. Abres o picker /model do Hermes para mudar de modelo, percorres a lista duas vezes: gpt-5.6-sol está lá, gpt-5.4 está lá, mas de gpt-6-astra não há rasto em lado nenhum. Antes de suspeitares de uma instalação avariada, sabe disto: é de propósito. O Hermes trata o Astra como um modelo discovery-gated, e é exatamente esse mecanismo que torna o picker mais honesto do que um catálogo estático. Eis o que é o Astra, porque é que está «em falta» e o que significam realmente os números das janelas 272K / 900K / 1,05M.
O Astra em sessenta segundos
O GPT-6 Astra é o primeiro modelo da OpenAI na geração GPT-6 — um único modelo denso, sem separação mini/nano. Especificações oficiais: uma context window de 1.050.000 tokens, máximo de 128.000 tokens de output, um knowledge cutoff de 30 de abril de 2026 e cinco definições de reasoning effort, de low a max. O seu foco é claramente o agente: computer use, coding de longo horizonte, workflows multi-step com tools. A OpenAI reporta 72,6% no OSWorld 2.0 — um benchmark em que o modelo conduz um sistema operativo real para concluir tarefas — contra 65,7% do GPT-5.6 Sol, mais ou menos na linha da média humana. Nota: estes números são da própria OpenAI; a replicação independente ainda está para chegar.
Os preços também são de nível flagship: $10 por milhão de tokens de input, $50 de output, $1 por input em cache, $12,50 por cache writes, além de um nível prioritário «fast» de aproximadamente 2×. E a OpenAI está a distribuí-lo em vagas — primeiro as empresas com Trusted Access, com o ChatGPT Plus/Pro/Business/Enterprise e o acesso por API a chegar nos dias seguintes. Se a tua conta ainda não foi ativada, essa é a razão mais comum para o Astra não aparecer em lado nenhum.
Porque é que falta em /model: o discovery gating
O Hermes trata o Astra de forma diferente de todos os modelos anteriores: ele não existe no catálogo estático. No passado, um modelo novo significava uma linha nova na lista de modelos offline do Hermes, visível em /model de imediato. O Astra segue outro caminho — o discovery gating:
- Cada vez que abres o picker
/model, o Hermes faz uma chamada de discovery em tempo real ao endpoint/modelsdo provider para a tua conta;gpt-6-astrasó aparece se a resposta da OpenAI o contiver mesmo. - As linhas em cache do picker, o teu «modelo atual» guardado, até o esqueleto do catálogo sem autenticação — nenhum deles consegue inventar essa permissão. Se um refresh falhar, o fallback remove o Astra da lista em vez de deixar uma linha que rebenta no momento em que clicas nela.
Portanto, uma entrada em falta não é o Hermes a mentir-te com um catálogo mundial genérico — é um espelho fiel daquilo que a tua conta consegue realmente fazer agora mesmo. No dia em que a OpenAI te ativar, não há nada para configurar: reabre o picker e ele está lá. O design chegou no PR #105185, com merge a 7 de setembro, que também corrigiu um bug em que qualquer pedido Astra via API direta rebentava com um TypeError por causa de um parâmetro de cache não suportado.
Três rotas, três janelas
O mesmo modelo Astra expõe context windows utilizáveis muito diferentes consoante a rota por onde te ligas:
| Rota | Model id | Janela | Notas |
|---|---|---|---|
| API direta da OpenAI | gpt-6-astra |
1,05M | pago por token, a maior janela |
| Subscrição do ChatGPT (Codex OAuth) | gpt-6-astra |
272K | limite rígido no backend do Codex |
| Codex OAuth, opt-in explícito | gpt-6-astra-900k |
900K | alias do picker, ver abaixo |
| OpenRouter | openai/gpt-6-astra |
1,05M | mais os níveis -fast / -flex / -pro |
A confusão recorrente é a segunda linha: se a especificação oficial diz 1,05M, porque é que a rota de subscrição do Codex limita nos 272K? Porque o Codex (a rota chatgpt.com/backend-api/codex) impõe o seu próprio limite de contexto rígido, e os metadados locais do Hermes resolvem o Astra aí para 272K — um limite da rota, não do modelo. A nossa análise a fundo da context window do Codex já dissecou este mecanismo: o Hermes chegou a elevar automaticamente os slugs do Codex para a janela verificada de 900K, viu o plafond de utilização da subscrição derreter, e reverteu para «slug base = 272K anunciado; 900K é um opt-in explícito».
A variante -900k da terceira linha é esse opt-in aplicado ao Astra: um alias do picker do lado do Hermes cujo sufixo é removido antes de o pedido sair para a rede — a OpenAI vê apenas gpt-6-astra — enquanto o Hermes gere a sessão contra uma janela de 900K. A janela é real e foi medida: o código-fonte do projeto regista um teste em direto de 4 de setembro em que um input de 920.043 tokens passou e um de 1.000.043 tokens foi rejeitado.
Mudar: comandos e picker
Tornar o Astra o teu modelo por defeito, ou experimentá-lo uma única vez, é trabalho de CLI puro:
# Direct OpenAI API (your account needs Astra enabled for the API too)
hermes chat --model gpt-6-astra --provider openai-api

# ChatGPT subscription via Codex OAuth: base 272K window
hermes chat --model gpt-6-astra --provider openai-codex

# Same subscription, explicit 900K window
hermes chat --model gpt-6-astra-900k --provider openai-codex
Dentro de uma sessão, carrega em /model para abrir o fuzzy picker (o que vive na paleta de comandos Ctrl+P) e escreve astra para filtrar; hermes model define o teu modelo por defeito. Quanto ao reasoning effort, o Astra aceita low / medium / high / xhigh / max; none e minimal são normalizados para low nas rotas oficiais, porque a API da OpenAI rejeita pedidos de «disable thinking» para ele. Para o trabalho do dia a dia, low ou medium mantêm a fatura de tokens baixa sem parecerem lentos.
272K não é só um limite — é um precipício na faturação
Porque é que o Hermes não mete os utilizadores de subscrição em 900K por defeito? Porque, para a OpenAI, 272K é um limiar de preço por pedido inteiro: assim que um único pedido ultrapassa os 272K tokens, o pedido inteiro — não apenas o excedente — é recalculado no nível de preço superior. O input salta de $10/M para $20/M, o output de $50/M para $75/M e o input em cache de $1/M para $2/M. Passas dos 272K e a fatura dessa única chamada duplica, instantaneamente. Na rota de subscrição do Codex é pior: cada tool call volta a ler o contexto acumulado, por isso o custo de leitura de cache cresce de forma linear com a janela.
«Slug base com 272K por defeito» não é, portanto, uma funcionalidade capada — é a decisão de engenharia que o Hermes tomou depois de se queimar: os padrões devem poupar dinheiro para a maioria, não maximizar o conforto de poucos. Quando uma tarefa precisa mesmo de um repositório inteiro ou de um dia completo de histórico de sessão à vista, muda explicitamente para -900k e paga o preço unitário mais alto dessa janela. É uma troca — e agora já sabes de que lado dela estás.
Quando a compaction entra em ação: o autoraise de 85%
Uma janela maior não quer dizer que a possas encher até ao limite — o Hermes faz auto-compaction (destila o meio do histórico num resumo) quando se atinge um ponto de acionamento, por defeito os 50% da janela. O problema: o Astra na rota do Codex só tem 272K, por isso um acionamento aos 50% compactaria aos ~136K — cedo demais para um flagship que aguenta 1,05M, e um desperdício da sua força de longo horizonte.
O Hermes eleva então o ponto de acionamento da compaction para o Astra na rota do Codex (e para os seus irmãos gpt-5.4/5.5/5.6) para 85% — cerca de 231K — para a sessão correr até quase ao limite da janela de 272K antes de resumir. O alias -900k e as outras rotas (API direta, OpenRouter) não são afetados e mantêm os 50% globais. Se preferires o comportamento antigo, a chave de configuração codex_gpt55_autoraise (um nome histórico; por defeito true) desativa-o, e a codex_gpt55_autoraise_notice controla o banner que aparece uma única vez.
Estado atual: no main, à espera da próxima release
Uma ressalva honesta sobre «posso usá-lo hoje?»: a integração do Astra teve merge no main branch a 7 de setembro (o PR #105185 e o fix de compaction #104762 que o acompanha) e ainda não está incluída em nenhuma release — a release v0.21.0 Pantheon de 31 de agosto é anterior a isso. Quando sair a próxima release, um simples hermes update resolve; os early adopters podem correr uma dev build ou compilar a partir do source. E lembra-te da pré-condição: a tua conta OpenAI tem de estar ativada para o Astra primeiro. Se não o consegues ver agora, a explicação mais provável não é um Hermes avariado — a OpenAI simplesmente ainda não chegou à tua conta. Dá-lhe uns dias e reabre /model.
Numa frase: o Astra é o primeiro modelo discovery-gated do Hermes — não o veres na lista significa que a tua conta não tem acesso, que é o picker a ser honesto contigo — e o par «272K por defeito + autoraise de 85%» é o Hermes a equilibrar poupar-te dinheiro com usar toda a capacidade do modelo.