Comment exécuter GPT-6 Astra dans Hermes — et pourquoi il n'apparaît pas dans votre liste /model
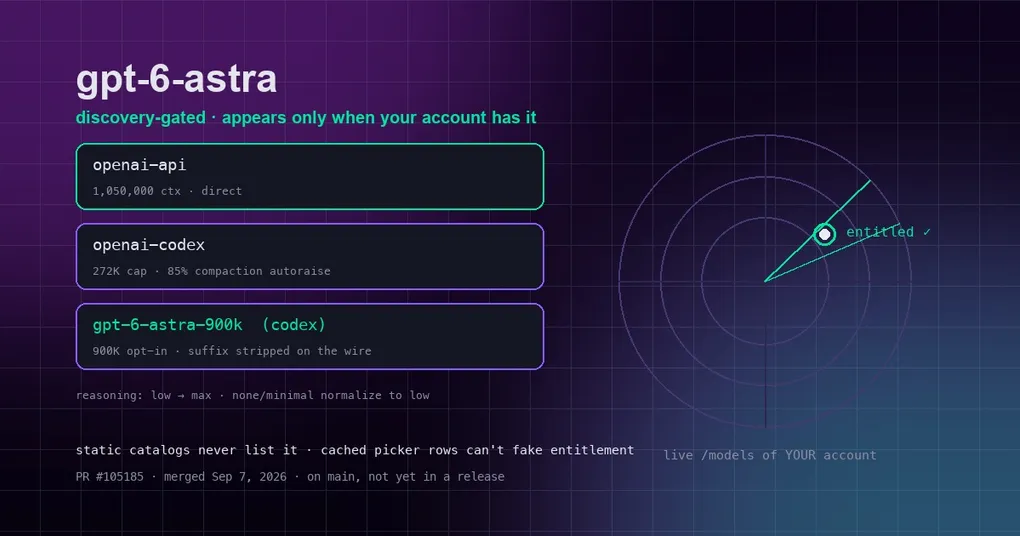
OpenAI a mis en ligne GPT-6 Astra le 3 septembre — son premier flagship de la génération GPT-6, présenté comme son modèle le plus capable et le plus aligné à ce jour — et en quelques heures, X et Hacker News regorgeaient de captures de benchmarks. Vous ouvrez le picker /model de Hermes pour basculer, vous parcourez la liste deux fois : gpt-5.6-sol y est, gpt-5.4 y est, mais gpt-6-astra reste introuvable. Avant de suspecter une installation cassée, sachez ceci : c’est voulu. Hermes traite Astra comme un modèle à discovery gating, et c’est précisément pour cela que son picker est plus honnête qu’un catalogue statique. Voici ce qu’est Astra, pourquoi il est « introuvable », et ce que signifient vraiment les fenêtres 272K / 900K / 1.05M.
Soixante secondes avec Astra
GPT-6 Astra est le premier modèle d’OpenAI de la génération GPT-6 : un modèle dense unique, sans déclinaison mini/nano. Spécifications officielles : une fenêtre de contexte de 1 050 000 tokens, 128 000 tokens de sortie au maximum, une date de coupe des connaissances au 30 avril 2026 et cinq réglages de reasoning-effort, de low à max. Son positionnement est résolument agentique : computer use, codage sur de longs horizons, workflows d’outils multi-étapes. OpenAI annonce 72,6 % sur OSWorld 2.0 — un benchmark où le modèle pilote un véritable système d’exploitation pour accomplir des tâches — contre 65,7 % pour GPT-5.6 Sol, à peu près au niveau de la référence humaine. À noter : ces scores sont ceux d’OpenAI lui-même ; les réplications indépendantes n’ont pas encore suivi.
Le tarif est lui aussi digne d’un flagship : 10 $ par million de tokens en entrée, 50 $ en sortie, 1 $ pour l’entrée servie en cache, 12,50 $ pour les écritures en cache, plus un palier prioritaire « fast » d’environ 2×. Et OpenAI le déploie par vagues — d’abord les entreprises Trusted Access, puis l’accès ChatGPT Plus/Pro/Business/Enterprise et l’API dans les jours qui suivent. Si votre compte n’est pas encore activé, c’est la raison la plus courante pour laquelle Astra reste invisible.
Pourquoi il est absent de /model : le discovery gating
Hermes traite Astra différemment de tous les modèles précédents : il n’existe pas dans le catalogue statique. Par le passé, un nouveau modèle se traduisait par une nouvelle ligne dans la liste hors ligne des modèles de Hermes, visible immédiatement dans /model. Astra emprunte une autre voie — le discovery gating :
- Chaque fois que vous ouvrez le picker
/model, Hermes effectue un appel de découverte en direct vers l’endpoint/modelsdu fournisseur, pour votre compte ;gpt-6-astran’apparaît que si la réponse d’OpenAI le contient réellement. - Les lignes en cache du picker, votre « modèle actuel » enregistré, jusqu’au squelette du catalogue non authentifié — aucune de ces sources ne peut inventer ce droit d’accès. Si un rafraîchissement échoue, le repli retire Astra de la liste plutôt que de laisser une ligne qui part en erreur dès que vous cliquez dessus.
Une entrée manquante n’est donc pas Hermes qui vous ment à coups de catalogue mondial générique : c’est le reflet fidèle de ce que votre compte peut réellement faire à l’instant présent. Le jour où OpenAI vous active, rien à configurer : rouvrez le picker et le modèle y est. Ce design est arrivé dans la PR #105185, fusionnée le 7 septembre, qui corrigeait au passage un bug où chaque requête Astra en API directe levait une TypeError à cause d’un paramètre de cache non pris en charge.
Trois routes, trois fenêtres
Le même modèle Astra expose des fenêtres de contexte très différentes selon la route par laquelle vous vous connectez :
| Route | Model id | Fenêtre | Remarques |
|---|---|---|---|
| API directe OpenAI | gpt-6-astra |
1.05M | paiement au token, fenêtre la plus large |
| Abonnement ChatGPT (Codex OAuth) | gpt-6-astra |
272K | plafond dur du backend Codex |
| Codex OAuth, opt-in explicite | gpt-6-astra-900k |
900K | alias du picker, voir plus bas |
| OpenRouter | openai/gpt-6-astra |
1.05M | plus les paliers -fast / -flex / -pro |
La confusion récurrente vient de la deuxième ligne : si la fiche technique annonce 1.05M, pourquoi la route d’abonnement Codex plafonne-t-elle à 272K ? Parce que Codex (la route chatgpt.com/backend-api/codex) impose sa propre limite dure de contexte, et les métadonnées locales de Hermes y résolvent Astra à 272K — une limite de route, pas une limite de modèle. Notre plongée dans les fenêtres de contexte Codex dissèque déjà ce mécanisme : Hermes a un temps relevé automatiquement les slugs Codex vers la fenêtre vérifiée de 900K, a vu les abonnements brûler des tokens, puis est revenu à « slug de base = 272K annoncés, 900K en opt-in explicite ».
La variante -900k de la troisième ligne est précisément cet opt-in appliqué à Astra : c’est un alias côté picker de Hermes dont le suffixe est retiré avant que la requête parte sur le fil — OpenAI voit un simple gpt-6-astra — tandis que Hermes gère la session sur une fenêtre de 900K. La fenêtre est réelle et mesurée : le code source du projet consigne un test en direct du 4 septembre où une entrée de 920 043 tokens a réussi et où une de 1 000 043 tokens a été rejetée.
Basculer : commandes et picker
Faire d’Astra votre modèle par défaut, ou simplement l’essayer une fois, se fait en quelques commandes CLI :
# Direct OpenAI API (your account needs Astra enabled for the API too)
hermes chat --model gpt-6-astra --provider openai-api

# ChatGPT subscription via Codex OAuth: base 272K window
hermes chat --model gpt-6-astra --provider openai-codex

# Same subscription, explicit 900K window
hermes chat --model gpt-6-astra-900k --provider openai-codex
En pleine session, tapez /model pour ouvrir le picker à filtrage flou (celui qui loge dans la palette de commandes Ctrl+P) et saisissez astra pour filtrer ; hermes model définit votre modèle par défaut. Côté reasoning-effort, Astra accepte low / medium / high / xhigh / max ; none et minimal sont normalisés en low sur les routes officielles, car l’API d’OpenAI rejette les demandes de « désactivation de la réflexion » pour ce modèle. Pour le travail courant, low ou medium maintient la facture de tokens à un niveau raisonnable sans donner l’impression d’une lenteur.
272K n’est pas qu’un plafond : c’est un seuil de facturation
Pourquoi Hermes ne met-il pas les abonnés sur 900K par défaut ? Parce que, pour OpenAI, 272K est un seuil de tarification qui porte sur la requête entière : dès qu’une seule requête dépasse 272K tokens, toute la requête — pas seulement le dépassement — est refacturée au palier supérieur. L’entrée passe de 10 $/M à 20 $/M, la sortie de 50 $/M à 75 $/M, l’entrée en cache de 1 $/M à 2 $/M. Franchissez 272K et la facture de cet appel double, instantanément. Sur la route d’abonnement Codex, c’est pire : chaque appel d’outil relit l’intégralité du contexte accumulé, si bien que le coût de lecture du cache croît linéairement avec la fenêtre.
« Slug de base = 272K par défaut » n’est donc pas une fonctionnalité bridée : c’est la décision d’ingénierie que Hermes a prise après s’être brûlé les ailes — les valeurs par défaut doivent faire économiser de l’argent au plus grand nombre, pas maximiser le confort d’une minorité. Quand une tâche exige réellement de garder en vue tout un dépôt ou une journée entière d’historique de session, basculez explicitement sur -900k et payez le prix unitaire plus élevé de cette fenêtre. C’est un arbitrage — et maintenant vous savez de quel côté de la balance vous vous trouvez.
Quand la compaction entre en jeu : l’élévation automatique à 85 %
Une fenêtre plus grande ne veut pas dire que vous pouvez la remplir à ras bord — Hermes compacte automatiquement (il distille le milieu de l’historique en un résumé) à un seuil de déclenchement fixé par défaut à 50 % de la fenêtre. Le problème : Astra sur la route Codex ne dispose que de 272K, si bien qu’un déclenchement à 50 % compacterait vers ~136K — beaucoup trop tôt pour un flagship capable d’en contenir 1.05M, et un gâchis de sa force sur les longs horizons.
Hermes relève donc le seuil de compaction pour Astra sur route Codex (et pour ses voisins gpt-5.4/5.5/5.6) à 85 % — environ 231K — afin que la session aille presque jusqu’au bord de la fenêtre de 272K avant de résumer. L’alias -900k et les autres routes (API directe, OpenRouter) ne sont pas concernés et conservent les 50 % globaux. Si vous préférez l’ancien comportement, la clé de configuration codex_gpt55_autoraise (un nom historique ; défaut true) le désactive, et codex_gpt55_autoraise_notice contrôle le bandeau affiché une seule fois.
Statut actuel : sur main, en attente de la prochaine version
Une réserve honnête à propos de « puis-je l’utiliser dès aujourd’hui ? » : l’intégration d’Astra a été fusionnée sur la branche main le 7 septembre (PR #105185, plus le correctif de compaction #104762 qui l’accompagne) et ne figure encore dans aucune version publiée — la version v0.21.0 Pantheon du 31 août lui est antérieure. Quand la prochaine version sortira, un simple hermes update suffira ; les premiers adoptants peuvent lancer une build de développement ou compiler depuis les sources. Et souvenez-vous de la condition préalable : votre compte OpenAI doit d’abord être activé pour Astra. Si vous ne le voyez pas maintenant, l’explication la plus probable n’est pas un Hermes cassé — OpenAI n’a simplement pas encore atteint votre compte. Laissez passer quelques jours et rouvrez /model.
En une phrase : Astra est le premier modèle à discovery gating de Hermes — ne pas le voir dans la liste signifie que votre compte n’y a pas accès, ce qui est le picker qui vous dit la vérité — et le duo « 272K par défaut + élévation automatique à 85 % » est la façon dont Hermes arbitre entre vous faire économiser de l’argent et exploiter toute la capacité du modèle.