Cómo usar GPT-6 Astra en Hermes — y por qué falta en tu lista de /model
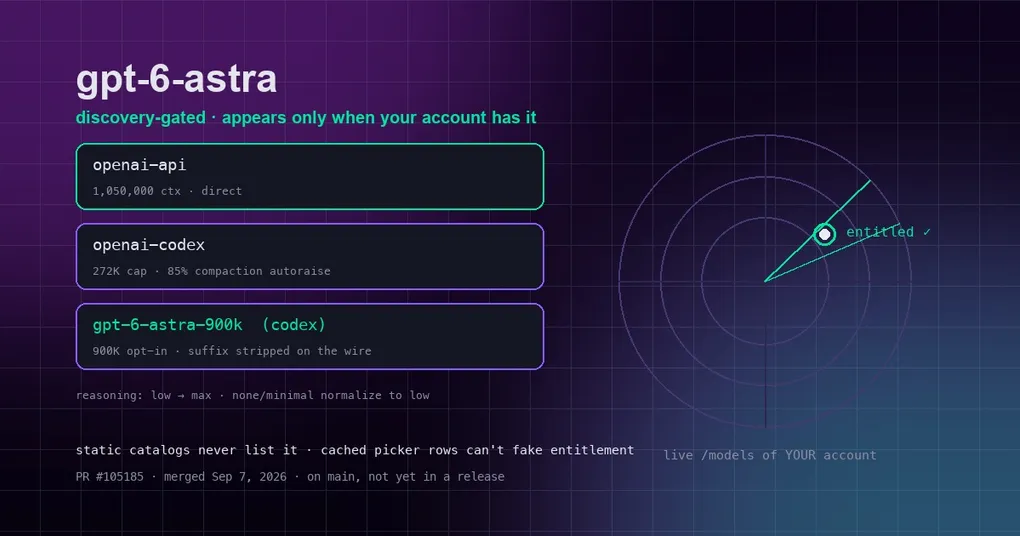
OpenAI lanzó GPT-6 Astra el 3 de septiembre — su primer flagship de la generación GPT-6, presentado como su modelo más capaz y alineado hasta la fecha — y en cuestión de horas X y Hacker News se llenaron de capturas de benchmarks. Abres el picker /model de Hermes para cambiar de modelo y recorres la lista dos veces: gpt-5.6-sol está ahí, gpt-5.4 está ahí, pero de gpt-6-astra no hay rastro. Antes de sospechar de una instalación rota, tenlo claro: es deliberado. Hermes trata a Astra como un modelo discovery-gated, y ese mecanismo es precisamente lo que hace que su picker sea más honesto que un catálogo estático. Esto es lo que es Astra, por qué “falta” y qué significan realmente las cifras de ventana de 272K / 900K / 1.05M.
Sesenta segundos sobre Astra
GPT-6 Astra es el primer modelo de OpenAI en la generación GPT-6: un único modelo denso, sin división mini/nano. Especificaciones oficiales: una context window de 1,050,000 tokens, 128,000 tokens máximos de salida, un knowledge cutoff del 30 de abril de 2026 y cinco niveles de reasoning-effort, de low a max. Su enfoque es claramente agéntico: computer use, codificación de largo horizonte y flujos de trabajo multi-paso con herramientas. OpenAI reporta un 72.6% en OSWorld 2.0 — un benchmark donde el modelo maneja un sistema operativo real para completar tareas — frente al 65.7% de GPT-5.6 Sol, aproximadamente en la línea base humana. Ojo: esas puntuaciones son de la propia OpenAI; la replicación independiente aún está al caer.
El precio también es de nivel flagship: $10 por millón de tokens de input, $50 por los de output, $1 por input en cache, $12.50 por escrituras en cache, más un nivel prioritario “fast” de aproximadamente 2×. Y OpenAI lo está desplegando por oleadas — primero las empresas con Trusted Access, con ChatGPT Plus/Pro/Business/Enterprise y el acceso por API llegando en los próximos días. Si tu cuenta aún no ha sido activada, esa es la razón más común por la que Astra no aparece por ningún lado.
Por qué falta en /model: el discovery gating
Hermes gestiona Astra de forma distinta a todos los modelos anteriores: no existe en el catálogo estático. Antes, un modelo nuevo significaba una línea nueva en la lista de modelos offline de Hermes, visible en /model de inmediato. Astra sigue otro camino — el discovery gating:
- Cada vez que abres el picker
/model, Hermes realiza una llamada de discovery en vivo al endpoint/modelsdel proveedor para tu cuenta;gpt-6-astrasolo aparece si la respuesta de OpenAI lo incluye de verdad. - Las filas cacheadas del picker, tu “modelo actual” guardado, incluso el esqueleto del catálogo sin autenticar — ninguno de ellos puede fabricar ese permiso. Si una actualización falla, el fallback retira a Astra de la lista en lugar de dejar una fila que dé error en cuanto haces clic en ella.
Que la entrada no aparezca no significa que Hermes te esté mintiendo con un catálogo mundial genérico — es un espejo fiel de lo que tu cuenta puede hacer ahora mismo. El día que OpenAI te active el acceso no hay nada que configurar: vuelve a abrir el picker y ahí estará. El diseño llegó en el PR #105185, fusionado el 7 de septiembre, que también arregló un bug por el que cualquier petición Astra por API directa lanzaba un TypeError por un parámetro de cache no soportado.
Tres rutas, tres ventanas
El mismo modelo Astra expone context windows utilizables muy distintas según la ruta por la que te conectes:
| Ruta | Model id | Ventana | Notas |
|---|---|---|---|
| API directa de OpenAI | gpt-6-astra |
1.05M | pago por token, la ventana más grande |
| Suscripción a ChatGPT (Codex OAuth) | gpt-6-astra |
272K | tope duro en el backend de Codex |
| Codex OAuth, opt-in explícito | gpt-6-astra-900k |
900K | alias del picker, ver abajo |
| OpenRouter | openai/gpt-6-astra |
1.05M | más niveles -fast / -flex / -pro |
La confusión recurrente es la segunda fila: si la especificación oficial dice 1.05M, ¿por qué la ruta de suscripción a Codex se limita a 272K? Porque Codex (la ruta chatgpt.com/backend-api/codex) impone su propio límite de contexto estricto, y los metadatos locales de Hermes resuelven Astra ahí a 272K — un límite de la ruta, no del modelo. Nuestro análisis en profundidad de la context window de Codex ya disecciona este mecanismo: Hermes subió automáticamente los slugs de Codex a la ventana verificada de 900K, vio cómo se quemaba el uso de suscripción y revirtió a “slug base = 272K anunciado; 900K es un opt-in explícito”.
La variante -900k de la tercera fila es ese opt-in aplicado a Astra: un alias del picker del lado de Hermes cuyo sufijo se elimina antes de que la petición salga a la red — OpenAI ve el gpt-6-astra a secas — mientras Hermes gestiona la sesión contra una ventana de 900K. La ventana es real y está medida: el código fuente del proyecto registra una prueba en vivo del 4 de septiembre en la que una entrada de 920,043 tokens tuvo éxito y una de 1,000,043 tokens fue rechazada.
Cambiar: comandos y picker
Convertir a Astra en tu modelo por defecto, o probarlo una sola vez, es puro trabajo de CLI:
# Direct OpenAI API (your account needs Astra enabled for the API too)
hermes chat --model gpt-6-astra --provider openai-api

# ChatGPT subscription via Codex OAuth: base 272K window
hermes chat --model gpt-6-astra --provider openai-codex

# Same subscription, explicit 900K window
hermes chat --model gpt-6-astra-900k --provider openai-codex
Dentro de una sesión, pulsa /model para abrir el picker difuso — el que vive en la paleta de comandos Ctrl+P — y escribe astra para filtrar; hermes model define tu modelo por defecto. En cuanto al reasoning-effort, Astra acepta low / medium / high / xhigh / max; none y minimal se normalizan a low en las rutas oficiales, porque la API de OpenAI rechaza las peticiones de “desactivar el pensamiento” para este modelo. Para el trabajo cotidiano, low o medium mantienen la factura de tokens a raya sin que se sienta lento.
272K no es solo un tope — es un precipicio de facturación
¿Por qué Hermes no asigna 900K por defecto a los usuarios de suscripción? Porque para OpenAI, 272K es un umbral de precio por petición completa: cuando una sola petición supera los 272K tokens, la petición entera — no solo el exceso — se repreciifica al nivel superior. El input salta de $10/M a $20/M, el output de $50/M a $75/M y el input en cache de $1/M a $2/M. Cruza los 272K y la factura de esa única llamada se duplica, al instante. En la ruta de suscripción a Codex es peor: cada tool call relee el contexto acumulado, así que el coste de lectura de cache crece de forma lineal con la ventana.
“El slug base por defecto es 272K” no es, por tanto, una función capada — es la decisión de ingeniería que Hermes tomó después de quemarse: los valores por defecto deben ahorrar dinero a la mayoría, no maximizar la comodidad de unos pocos. Cuando una tarea necesita de verdad tener a la vista un repositorio entero o un día completo de historial de sesión, cambia a -900k explícitamente y paga el precio unitario más alto por esa ventana. Es un intercambio, y ahora sabes en qué lado estás.
Cuándo entra en juego la compaction: el autoraise del 85%
Una ventana más grande no significa que puedas llenarla hasta el borde — Hermes compacta automáticamente (destila la parte central del historial en un resumen) al alcanzar un punto de activación, por defecto el 50% de la ventana. El problema: Astra en la ruta de Codex solo tiene 272K, así que un disparador al 50% compactaría en ~136K — demasiado pronto para un flagship que puede albergar 1.05M, y un desperdicio de su fortaleza de largo horizonte.
Hermes eleva por tanto el disparador de compaction para el Astra de la ruta Codex (y sus hermanos gpt-5.4/5.5/5.6) hasta el 85% — unos 231K —, de modo que la sesión corre casi hasta el borde de la ventana de 272K antes de resumir. El alias -900k y las demás rutas (API directa, OpenRouter) no se ven afectados y mantienen el 50% global. Si prefieres el comportamiento anterior, la clave de configuración codex_gpt55_autoraise (un nombre histórico; por defecto true) lo desactiva, y codex_gpt55_autoraise_notice controla el aviso único.
Estado actual: en main, a la espera de la próxima release
Una advertencia honesta sobre “¿puedo usarlo hoy?”: la integración de Astra se fusionó en la main branch el 7 de septiembre (PR #105185 más el fix de compaction #104762 que lo acompaña) y aún no está en ninguna versión publicada — la release v0.21.0 Pantheon del 31 de agosto es anterior. Cuando salga la próxima release, un único hermes update la traerá; los early adopters pueden ejecutar un dev build o compilar desde el código fuente. Y recuerda la condición previa: tu cuenta de OpenAI debe estar activada para Astra primero. Si no puedes verlo ahora mismo, la explicación más probable no es un Hermes roto — OpenAI simplemente aún no ha llegado a tu cuenta. Dale unos días y vuelve a abrir /model.
En una frase: Astra es el primer modelo discovery-gated de Hermes — no verlo en la lista significa que tu cuenta carece de acceso, que es el picker siendo honesto contigo — y la combinación “272K por defecto + autoraise del 85%” es Hermes equilibrando ahorrar tu dinero contra usar toda la capacidad del modelo.