GPT-6 Astra in Hermes ausführen – und warum es in Ihrer /model-Liste fehlt
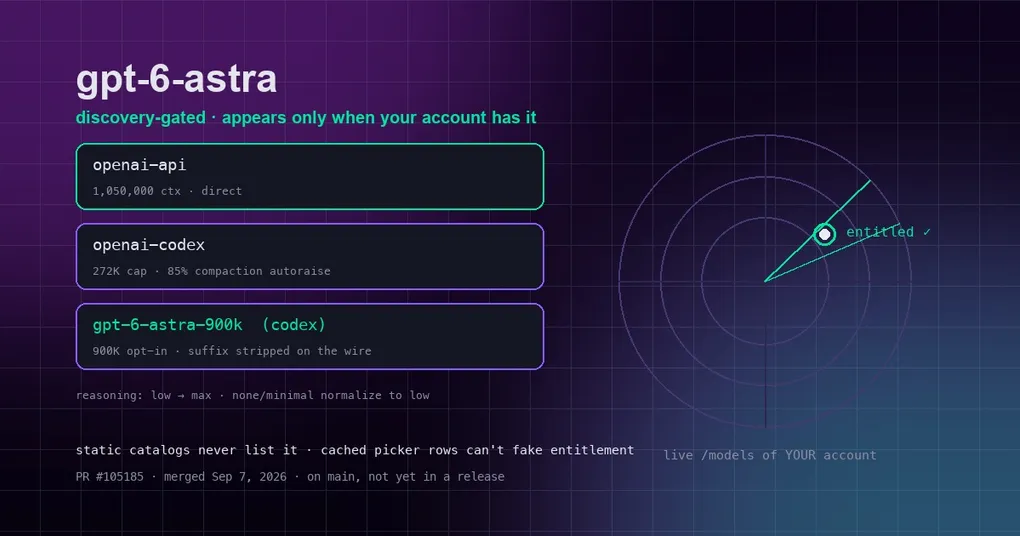
OpenAI hat GPT-6 Astra am 3. September ausgeliefert – als erstes Flagship der GPT-6-Generation, angepriesen als sein bislang fähigstes und am besten ausgerichtetes Modell – und binnen Stunden waren X und Hacker News voller Benchmark-Screenshots. Sie öffnen den /model-Picker von Hermes, um umzusteigen, scrollen die Liste zweimal durch: gpt-5.6-sol ist da, gpt-5.4 ist da, aber von gpt-6-astra fehlt jede Spur. Bevor Sie eine kaputte Installation vermuten: Das ist Absicht. Hermes behandelt Astra als Discovery-gated-Modell, und genau dieser Mechanismus ist der Grund, warum sein Picker ehrlicher ist als ein statischer Katalog. Hier erfahren Sie, was Astra ist, warum es „fehlt“ und was die Fensterzahlen 272K / 900K / 1.05M wirklich bedeuten.
Astra in 60 Sekunden
GPT-6 Astra ist OpenAIs erstes Modell der GPT-6-Generation – ein einzelnes dichtes Modell ohne Mini-/Nano-Aufteilung. Die offiziellen Spezifikationen: ein Kontextfenster von 1.050.000 Token, 128.000 Token maximale Ausgabe, ein Wissensstand (Knowledge Cutoff) vom 30. April 2026 und fünf Reasoning-Effort-Stufen von low bis max. Sein Fokus liegt klar auf agentischen Szenarien: Computer Use, langfristig angelegtes Coding über lange Zeithorizonte und mehrstufige Tool-Workflows. OpenAI nennt selbst 72,6 % auf OSWorld 2.0 – einem Benchmark, bei dem das Modell ein echtes Betriebssystem bedienen muss, um Aufgaben abzuschließen – gegenüber 65,7 % für GPT-5.6 Sol, also etwa auf dem Niveau menschlicher Basiswerte. Wobei diese Zahlen von OpenAI selbst stammen; die unabhängige Replikation hinkt noch hinterher.
Auch die Preise haben Flagship-Niveau: $10 pro Million Input-Tokens, $50 für Output, $1 für gecachten Input, $12,50 für Cache-Writes, dazu eine „fast“-Prioritätsstufe mit rund doppeltem Aufpreis. Und OpenAI rollt das Modell in Wellen aus – zuerst für Trusted-Access-Unternehmen, gefolgt von ChatGPT Plus/Pro/Business/Enterprise und API-Zugang in den nächsten Tagen. Wenn Ihr Konto noch nicht freigeschaltet wurde, ist das der häufigste Grund dafür, dass Astra nirgends zu sehen ist.
Warum es in /model fehlt: Discovery Gating
Hermes behandelt Astra anders als jedes bisherige Modell: Es existiert nicht im statischen Katalog. Bisher bedeutete ein neues Modell eine neue Zeile in der Offline-Modellliste von Hermes, sofort sichtbar in /model. Astra geht einen anderen Weg – Discovery Gating:
- Jedes Mal, wenn Sie den /model-Picker öffnen, führt Hermes einen Live-Discovery-Call an den /models-Endpoint des Providers für Ihr Konto aus;
gpt-6-astraerscheint nur, wenn die Antwort von OpenAI es tatsächlich enthält. - Gecachte Picker-Zeilen, Ihr gespeichertes „aktuelles Modell“, selbst das Gerüst des unauthentifizierten Katalogs – nichts davon kann diese Berechtigung vortäuschen. Schlägt ein Refresh fehl, entfernt der Fallback Astra aus der Liste, statt eine Zeile stehen zu lassen, die im Moment des Klicks einen Fehler wirft.
Ein fehlender Eintrag ist also keine Notlüge von Hermes mit einem generischen Weltkatalog – er ist ein getreues Spiegelbild dessen, was Ihr Konto gerade jetzt tatsächlich kann. An dem Tag, an dem OpenAI Sie freischaltet, muss nichts konfiguriert werden: Picker öffnen, und es ist da. Das Design kam mit PR #105185, gemergt am 7. September, und behob nebenbei einen Bug, bei dem jede direkte Astra-API-Anfrage einen TypeError wegen eines nicht unterstützten Cache-Parameters auslöste.
Drei Routen, drei Fenster
Dasselbe Astra-Modell bietet je nach Route, über die Sie sich verbinden, sehr unterschiedlich große nutzbare Kontextfenster:
| Route | Modell-ID | Fenster | Anmerkungen |
|---|---|---|---|
| OpenAI Direct API | gpt-6-astra |
1.05M | Pay-per-Token, größtes Fenster |
| ChatGPT-Abo (Codex OAuth) | gpt-6-astra |
272K | hartes Limit im Codex-Backend |
| Codex OAuth, explizites Opt-in | gpt-6-astra-900k |
900K | Picker-Alias, siehe unten |
| OpenRouter | openai/gpt-6-astra |
1.05M | plus Stufen -fast / -flex / -pro |
Die Verwirrung entsteht regelmäßig bei der zweiten Zeile: Wenn die offizielle Spezifikation 1.05M angibt, warum limitiert die Codex-Abo-Route dann bei 272K? Weil Codex (die Route chatgpt.com/backend-api/codex) sein eigenes hartes Kontextlimit durchsetzt und die lokalen Metadaten von Hermes Astra dort auf 272K auflösen – ein Routenlimit, kein Modelllimit. Unser Codex-Deep-Dive zum Kontextfenster seziert diesen Mechanismus bereits: Hermes hob Codex-Slugs einst automatisch auf das verifizierte 900K-Fenster an, sah zu, wie das Abo-Kontingent verbrannte, und kehrte zurück zu „Basis-Slug = beworbene 272K, 900K nur per explizitem Opt-in“.
Die -900k-Variante in Zeile drei ist genau dieses Opt-in, angewendet auf Astra: ein Picker-Alias auf Hermes-Seite, dessen Suffix vor dem Absenden der Anfrage entfernt wird – OpenAI sieht schlicht gpt-6-astra – während Hermes die Session gegen ein 900K-Fenster verwaltet. Das Fenster ist real und gemessen: Im Projektquellcode ist ein Live-Test vom 4. September dokumentiert, bei dem ein Input mit 920.043 Token durchging und einer mit 1.000.043 Token abgelehnt wurde.
Umsteigen: Befehle und Picker
Astra zu Ihrem Standardmodell zu machen oder es nur einmal auszuprobieren, ist schlichte CLI-Arbeit:
# Direct OpenAI API (your account needs Astra enabled for the API too)
hermes chat --model gpt-6-astra --provider openai-api

# ChatGPT subscription via Codex OAuth: base 272K window
hermes chat --model gpt-6-astra --provider openai-codex

# Same subscription, explicit 900K window
hermes chat --model gpt-6-astra-900k --provider openai-codex
Innerhalb einer Session öffnen Sie mit /model den Fuzzy-Picker (derselbe, der in der Ctrl+P-Befehlspalette lebt) und tippen astra, um zu filtern; hermes model setzt Ihr Standardmodell. Beim Reasoning Effort akzeptiert Astra low / medium / high / xhigh / max; none und minimal werden auf den offiziellen Routen zu low normalisiert, weil die API von OpenAI für dieses Modell Anfragen zum „Abschalten des Denkens“ ablehnt. Für die tägliche Arbeit hält low oder medium die Token-Rechnung niedrig, ohne dass es sich langsam anfühlt.
272K ist nicht nur ein Limit – es ist eine Preisklippe
Warum stellt Hermes Abo-Nutzer nicht standardmäßig auf 900K? Weil 272K bei OpenAI eine Preisschwelle für die gesamte Anfrage ist: Sobald eine einzelne Anfrage 272K Token überschreitet, wird die komplette Anfrage – nicht nur der Überschuss – zur höheren Stufe abgerechnet. Input springt von $10/M auf $20/M, Output von $50/M auf $75/M, gecachter Input von $1/M auf $2/M. Über 272K hinweg verdoppelt sich die Rechnung für genau diesen einen Call – sofort. Auf der Codex-Abo-Route wird es noch schlimmer: Jeder Tool-Call liest den akkumulierten Kontext erneut ein, die Kosten für Cache-Reads wachsen also linear mit dem Fenster.
„Basis-Slug standardmäßig 272K“ ist daher kein verstümmeltes Feature – es ist die Engineering-Entscheidung, die Hermes nach der schmerzhaften Erfahrung getroffen hat: Standards sollen der Mehrheit Geld sparen, nicht der Minderheit Komfort maximieren. Wenn eine Aufgabe wirklich ein komplettes Repository oder einen ganzen Tag Session-Verlauf im Blick braucht, wechseln Sie explizit auf -900k und zahlen den höheren Stückpreis für dieses Fenster. Es ist ein Trade-off – und jetzt wissen Sie, auf welcher Seite Sie stehen.
Wann Compaction einsetzt: das Autoraise auf 85 %
Ein größeres Fenster heißt nicht, dass Sie es randvoll füllen können – Hermes kompaktiert automatisch (destilliert die Mitte des Verlaufs in eine Zusammenfassung), sobald ein Auslösepunkt erreicht ist, standardmäßig bei 50 % des Fensters. Das Problem: Astra hat auf der Codex-Route nur 272K, ein 50-%-Auslöser würde also schon bei rund 136K kompaktieren – viel zu früh für ein Flagship, das 1.05M fassen kann, und eine Verschwendung seiner Long-Horizon-Stärke.
Hermes hebt den Compaction-Trigger für Astra auf der Codex-Route (und seine Geschwister gpt-5.4/5.5/5.6) daher auf 85 % – rund 231K – an, sodass die Session fast bis an die Kante des 272K-Fensters läuft, bevor zusammengefasst wird. Der -900k-Alias und die anderen Routen (Direct API, OpenRouter) sind nicht betroffen und behalten die globalen 50 %. Wenn Sie das alte Verhalten bevorzugen, schaltet der Konfigurationsschlüssel codex_gpt55_autoraise (ein historischer Name; Standard true) es ab, und codex_gpt55_autoraise_notice steuert den einmalig erscheinenden Banner.
Aktueller Stand: auf main, das Release steht noch aus
Ein ehrlicher Vorbehalt zur Frage „Kann ich es heute nutzen?“: Die Astra-Integration wurde am 7. September in den main branch gemergt (PR #105185 plus der begleitende Compaction-Fix #104762) und ist noch in keiner veröffentlichten Version enthalten – das v0.21.0-Pantheon-Release vom 31. August stammt aus der Zeit davor. Wenn das nächste Release erscheint, holt ein einziges hermes update es aufs System; Early Adopters können einen Dev-Build ausführen oder selbst aus dem Quellcode bauen. Und denken Sie an die Voraussetzung: Ihr OpenAI-Konto muss zuerst für Astra freigeschaltet sein. Wenn Sie es gerade nicht sehen können, ist die wahrscheinlichste Erklärung kein defektes Hermes – OpenAI hat Ihr Konto schlicht noch nicht erreicht. Geben Sie ihm ein paar Tage und öffnen Sie /model erneut.
In einem Satz: Astra ist das erste Discovery-gated Modell von Hermes – es nicht in der Liste zu sehen heißt, dass Ihrem Konto der Zugriff fehlt, und genau darin ist der Picker ehrlich zu Ihnen – und die Kombination aus „272K-Standard“ und „Autoraise auf 85 %“ ist der Balanceakt von Hermes zwischen Geld sparen und die volle Leistungsfähigkeit des Modells ausschöpfen.