网关能自愈的平台,为什么偏偏有一个再也回不来
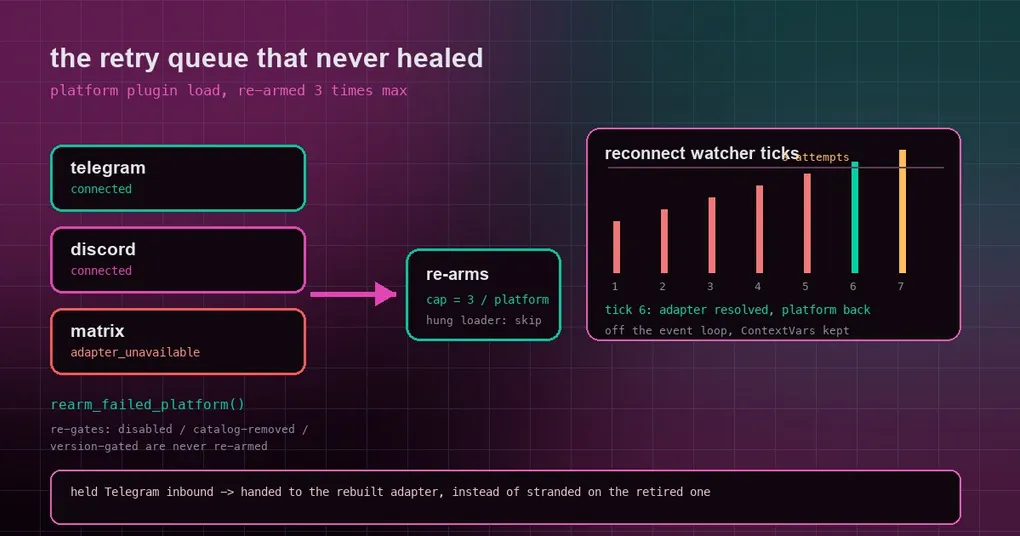
半夜网络抖了一下,你机器上的 Hermes 网关和 Telegram 断了线。第二天早上你看网关状态:进程活着,其他平台都正常,只有 Telegram 一直显示重连中。你重启一次网关,它才回来。这类“差一点点就能自愈”的状态最难排查——不是崩溃,是一个永远不会退出的重试队列。
2026 年 10 月 5 日合并的三个修复(#133289、#133228、#133230)正好覆盖了三种这样的情形。它们的共同点是:网关的重连机制本身是好的,但有三个出口没有被覆盖到,于是“会自愈”在特定条件下变成了“永远卡住”。下面一个一个讲。
一:插件加载失败的平台,之前永远不会重试导入
网关的机制是:如果某个已启用的平台,它的插件在启动时加载失败,网关会把这个平台标记为需要关注,并放进重连观察队列,状态是 retrying / adapter_unavailable。这一步是好的——队列会一直重试。
问题出在“重试什么”。平台插件的加载是**延迟加载(deferred)**的:注册表只持有一个加载租约,真正 import 发生在第一次查找时。如果那次延迟加载抛异常、或者超过了它的加载截止时间,租约就被释放,注册表干脆把这个平台忘了。之后重连观察者每次 tick 去看“有没有适配器”,答案永远是“没有”,但它没有任何东西可以重新触发 import——只有强制重新发现(reload-plugins、面板、或者插件工具)才会重新授予租约。于是这个平台就无限期地留在队列里,日志每隔一段时间打印一次 Reconnect <platform>: no adapter yet, next retry in Ns。
修复加了一个 rearm_failed_platform():它找到那个被记录为加载失败的平台清单,重新走一遍延迟平台注册,这样下一次注册表查找就会重试 import。关键是它有三个安全阀:
- 重新过闸:一个被禁用、未启用、或已从目录移除的占位条目,以及版本不满足
requires_hermes的插件,错误形态和“加载失败”长得一样,但它们永远不会被重新加载; - 不叠加线程:如果那个插件还有一个卡住的
plugin-load:工作线程活着,就跳过这次重新加载,避免再泄漏一个线程; - 有次数上限:观察者每个排队平台最多重新加载 3 次(
_MAX_PLUGIN_LOAD_REARMS = 3)——临时的加载失败能自愈,真正坏掉的插件不会无限重复 import。
重新加载和随后真正实例化插件的那次注册表查找都在执行器里跑(不占用事件循环),并且保留 profile 的上下文变量。日志里出现 Re-arming failed platform plugin load: <name> 就是它在工作。
二:断线期间被暂存的 Telegram 消息,之前会随着旧适配器一起消失
Telegram 有一条特殊规则:被 PTB(python-telegram-bot)确认过的更新,如果丢了,是拉不回来的。所以 Hermes 会把已经确认、但还没处理完的事件先“暂存”在适配器实例的一个队列里,等连接恢复后由这个实例自己排空。
这个队列属于适配器实例。而一次可重试的致命错误(网络问题、轮询停滞,以及后来新增的入站停滞)会让运行器新建一个适配器。旧的重连路径把去重缓存交接给了新适配器,却没有交接这个暂存队列——结果断线前暂存的事件、以及拆除过程中被抢救到旧适配器上的事件,全都留在了被退休的实例上,再也不会被排空。
这个缺口从 8 月 11 日引入“按实例的暂存队列”时就存在了;9 月 23 日只把去重状态交接过去,队列还是漏的。新版的做法是:重连队列条目把被替换掉的适配器整个留作 predecessor,在发布时(新适配器真正注册成功的那一刻)调用 hand_over_held_inbound() 把暂存事件移交给新适配器。几个细节值得知道:
- 连接失败的候选适配器不会取得队列的所有权,投递会等替换者注册完成;
- 移交时只重绑传输层的引用,profile 与角色鉴权仍按原来解析的结果走;
- 旧适配器在移交之后如果还收到被抢救进来的事件,会转发给活着的后继者,并且先接受它自己的在处理声明,保证回执被记录;
- 这个函数对没有暂存队列的适配器是空操作——只有 Telegram 有这个机制。
三:停止网关时,正在跑的 /v1 请求不再被 0 秒掐断
第三个和前面两个不同,它不是“卡住”,而是“被过早杀掉”。网关停止或重启时会有一个排水(drain)阶段,让进行中的工作跑完。问题是排水把 api_server 的 /v1 请求和普通聊天回合放在了同一个预算上,而这个预算 restart_drain_timeout 默认是 0——因为聊天回合被打断是可以接受的,它会被公告并从断点继续。
/v1 请求不行。它背后有一个 HTTP 调用方正阻塞着等结果,它不能“续跑”。所以在默认配置下,排水循环实际上一轮都没跑,关闭路径会掐掉每一个在飞的 /v1 请求,调用方拿到的是失败。
修复让 api_server 的运行和 cron 任务共用同一个截止时间(agent.cron_drain_timeout 这个下限,并受看门狗钳制)。这里没有引入新的计数器或配置键。停止时那行日志现在也会在“只有 api_server 在飞”的情境下打印,并带上数量,形如 waiting up to Ns。如果你的 cron_drain_timeout: 0,那就等于把 /v1 也一起选择退出排水——文档里已经写明了这一点,以及“被打断的 /v1 运行会让等待中的调用方失败”这个后果。
对照一下症状和现在的行为
| 你会看到的症状 | 现在会发生什么 |
|---|---|
某个平台插件启动加载失败,平台一直 adapter_unavailable,只有重启或 reload-plugins 才回来 |
重连观察者每个 tick 尝试重新加载,最多 3 次;原因消失后平台自动恢复 |
| 一个真正坏掉(版本不匹配 / 已移除)的插件在日志里反复报错 | 不会被重新加载,也不会刷屏重试 |
| Telegram 断线重连后,断线期间发的消息像是凭空消失 | 暂存事件移交给新适配器后投递 |
重启网关时,正在执行的 /v1 调用全部返回失败 |
在排水截止时间内跑完;只有超时或显式关闭排水才会中断 |
调整网关整体行为的旋钮(重连间隔、上限、看门狗)在网关命令参考里;如果你遇到过“进程活着但平台静默失联”的情况,那篇静默断线与心跳讲的是相邻的另一面,网关卡死看门狗则解释了排水和看门狗的配合方式。
上线状态
这三个修复目前都只在 main 上,没有进入已发布 tag(最新是 v0.21.5 / v2026.9.24)。git 安装的用户拉最新 main 即可;Docker 镜像和托管部署等下一个 tag。如果你有多个网关实例,注意一台机器只跑一个网关这个前提仍然成立。
小结
这三个修复背后是同一种设计判断:“重试”必须重试正确的那一层。队列活着但没人重新触发 import,就等于没有重试;去重状态交接了但负载没交接,就等于丢消息;排水循环存在但预算是 0,就等于直接杀进程。检查任何自愈机制时,别只看“有没有重试逻辑”,要看每一次重试是否真的把状态往前进了一步——以及它有没有上限,免得把可恢复的故障和永久性故障一视同仁。