El gateway cura todas las plataformas menos una — he aquí por qué
La red parpadeó durante la noche y tu gateway de Hermes perdió su conexión con Telegram. Por la mañana el gateway está en pie, todas las demás plataformas van bien, y Telegram lleva desde entonces en “reconectando”. Reinicias el gateway y vuelve. Esta clase de bug es la peor de diagnosticar — nada se cayó, solo hay una cola de reintentos que nunca va a avanzar.
Tres correcciones fusionadas el 5 de octubre de 2026 (#133289, #133228, #133230) cubren exactamente tres casos así. Comparten una forma: la maquinaria de reconexión estaba bien, pero tres salidas no estaban cubiertas, así que “se cura solo” se convertía en “se queda caído” bajo condiciones concretas.
Uno: una plataforma cuyo plugin no cargó nunca reintentaba la importación
El gateway ya maneja la primera mitad: una plataforma habilitada cuyo plugin falla al cargar durante el arranque se marca y se encola en el watcher de reconexión como retrying / adapter_unavailable. Esa cola sigue reintentando.
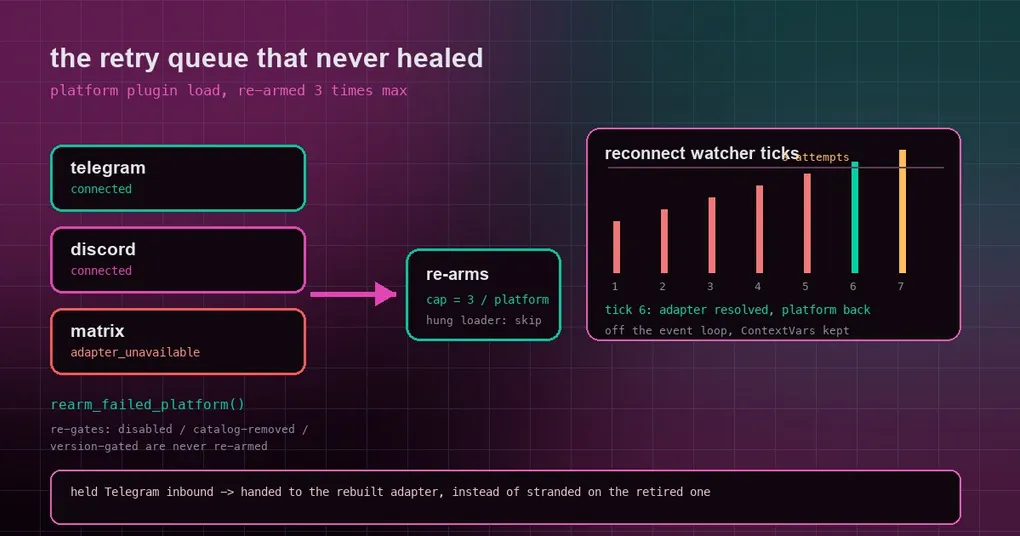
El problema era qué reintentaba. La carga de plugins de plataforma es diferida: el registro mantiene un lease de carga, y la importación real ocurre en la primera búsqueda. Si esa carga diferida lanza una excepción, o se pasa de su plazo, el lease se libera y el registro simplemente olvida la plataforma. El watcher seguía buscando un adaptador, seguía sin encontrar ninguno, y no tenía nada que pudiera volver a ejecutar la importación — solo un redescubrimiento forzado (reload-plugins, el dashboard o la herramienta de plugins) vuelve a conceder el lease al cargador. La plataforma se quedaba en cola indefinidamente mientras el log imprimía Reconnect <platform>: no adapter yet, next retry in Ns.
La corrección añade rearm_failed_platform(): encuentra el manifiesto de la plataforma registrado como carga fallida y vuelve a registrar la plataforma diferida, de modo que la siguiente búsqueda en el registro reintenta la importación. Tres válvulas de seguridad importan:
- Vuelve a aplicar el filtro antes de re-armar. Un placeholder (deshabilitado, no habilitado, eliminado del catálogo) y un plugin que falla
requires_hermestienen la misma forma de conjunto de errores que una carga fallida, y nunca se re-arman. - Nunca apila hilos. Si un worker
plugin-load:colgado de ese plugin sigue vivo, se omite el re-armado en lugar de filtrar un segundo hilo abandonado. - Está acotado. El watcher re-arma como máximo 3 veces por plataforma en cola (
_MAX_PLUGIN_LOAD_REARMS = 3): un fallo de carga transitorio se cura, un plugin realmente roto no se re-importa para siempre.
Tanto el re-armado como la búsqueda en el registro que materializa el plugin se ejecutan en un executor, fuera del event loop, conservando las variables de contexto del perfil. La línea que hay que buscar en tu log es Re-arming failed platform plugin load: <name>.
Dos: los mensajes de Telegram retenidos durante una desconexión quedaban varados en el adaptador retirado
Telegram tiene una propiedad incómoda: una actualización que python-telegram-bot ya ha confirmado no se puede volver a recuperar. Así que Hermes guarda los eventos confirmados pero no procesados en una cola en la instancia del adaptador, y esa instancia drena la cola ella misma al reconectarse.
La cola pertenece a la instancia del adaptador — y un error fatal reintentable (un error de red, un estancamiento del polling, y desde un cambio posterior un estancamiento del ingress) hace que el runner construya un adaptador nuevo. La antigua ruta de reconexión trasladaba las cachés de deduplicación al reemplazo, pero no la cola de retención, así que los eventos retenidos antes de la reconstrucción — más lo que el teardown rescatara después en el adaptador retirado — quedaban varados allí para siempre.
La brecha se remonta al 11 de agosto, cuando se introdujo la cola de retención por instancia; un cambio del 23 de septiembre trasladó el estado de deduplicación, pero no la cola. La corrección mantiene el adaptador reemplazado en la entrada de la cola de reconexión como predecessor y, en el momento de la publicación — cuando el reemplazo se registra de verdad —, llama a hand_over_held_inbound() para trasladar los eventos retenidos. Conviene saber:
- un adaptador candidato que no logra conectarse nunca toma posesión de la cola, y la entrega espera a que el reemplazo esté registrado;
- el traspaso solo reasigna la referencia de la capa de transporte; la autorización de perfil y de rol se mantiene tal como se resolvió;
- si el adaptador retirado sigue recibiendo eventos rescatados tras el traspaso, los reenvía al sucesor activo, aceptando primero su propia reclamación de actualización en curso para que el recibo quede registrado igualmente;
- el helper es un no-op para los adaptadores que no tienen cola de retención — solo Telegram tiene una.
Tres: las ejecuciones /v1 en curso morían a los 0,00 s al detener el gateway
La tercera no es “atascado”, es “matado demasiado pronto”. Detener o reiniciar el gateway ejecuta una fase de drenaje para que el trabajo en curso pueda terminar. Ese drenaje ponía las ejecuciones de api_server (/v1) en el mismo presupuesto que los turnos de chat, y ese presupuesto — restart_drain_timeout — por defecto es 0, porque un turno de chat interrumpido es aceptable: se anuncia y puede reanudarse.
Una ejecución /v1 no puede reanudarse. Tiene un llamador HTTP bloqueado esperando el resultado. Con el 0 por defecto, el bucle de drenaje nunca llegaba a ejecutarse, así que la ruta de apagado interrumpía todas las ejecuciones /v1 en curso y hacía fallar al llamador que esperaba.
La corrección pone las ejecuciones de api_server en el mismo plazo que los trabajos de cron (el suelo de agent.cron_drain_timeout, acotado por el watchdog). Ni nuevo contador ni nueva clave de configuración. La línea de log de la ruta de parada “waiting up to Ns” ahora también se dispara cuando solo hay ejecuciones de api_server en curso, e incluye su número. Ojo con la salida opcional: cron_drain_timeout: 0 excluye también del drenaje a las ejecuciones /v1, y una ejecución /v1 interrumpida hace fallar a su llamador que esperaba.
De síntoma a comportamiento
| Síntoma que quizá hayas visto | Qué pasa ahora |
|---|---|
Un plugin de plataforma falla al cargar en el arranque, la plataforma se queda en adapter_unavailable, y solo un reinicio o reload-plugins la recupera |
El watcher de reconexión re-arma la carga en cada tick, hasta 3 veces, y la plataforma se cura una vez desaparecida la causa |
| Un plugin realmente roto (desajuste de versión, eliminado del catálogo) llenando el log | No se re-arma, y los reintentos no se acumulan |
| Telegram se reconecta y los mensajes enviados durante la desconexión parecen desvanecerse | Los eventos retenidos se traspasan al nuevo adaptador y se entregan |
Reiniciar el gateway hace fallar todas las llamadas /v1 en curso |
Terminan dentro del plazo de drenaje; solo un timeout o una exclusión explícita las interrumpe |
Las palancas del comportamiento del gateway en general (intervalos de reconexión, topes, el watchdog) están en la referencia del comando gateway. Si has perseguido un fallo de “proceso vivo, plataforma desaparecida en silencio”, el post sobre el latido de desconexión silenciosa cubre la mitad adyacente, y la guía del loop watchdog explica cómo el drenaje y el watchdog trabajan juntos.
Estado de la versión
Las tres correcciones están en main y en ninguna etiqueta publicada (la versión más reciente es v0.21.5, tag v2026.9.24). Las instalaciones vía Git las obtienen al hacer pull de la última main; las imágenes Docker y los despliegues alojados las reciben con la próxima etiqueta. Si ejecutas varios gateways, sigue aplicándose la regla de un gateway por host.
La lección de diseño
Las tres se reducen al mismo juicio: un reintento tiene que reintentar la capa correcta. Una cola viva sin nada que vuelva a ejecutar la importación no es un reintento; trasladar el estado de deduplicación pero no la carga útil no es un traspaso; un bucle de drenaje con presupuesto cero es un interruptor de apagado. Cuando audites tus propias rutas de autocuración, no te quedes en “¿hay lógica de reintento?” — comprueba que cada intento realmente hace avanzar el estado, y que tiene un techo, para que un fallo recuperable y uno permanente no reciban el mismo trato.