Le gateway répare toutes les plateformes sauf une — voici pourquoi
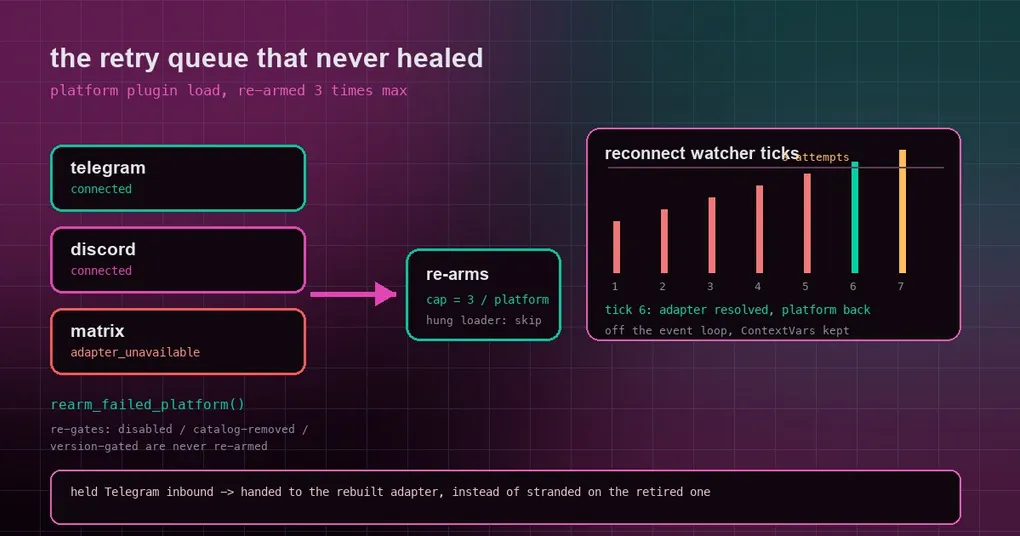
Le réseau a eu un hoquet pendant la nuit et votre gateway Hermes a perdu sa connexion Telegram. Le matin, le gateway est debout, toutes les autres plateformes vont bien, et Telegram est resté sur « reconnecting » depuis. Vous redémarrez le gateway et tout revient. Cette classe de bug est la pire à diagnostiquer — rien n’a planté, il y a juste une file de nouvelles tentatives qui ne progressera jamais.
Trois correctifs fusionnés le 5 octobre 2026 (#133289, #133228, #133230) couvrent exactement trois cas de ce genre. Ils partagent une forme : la mécanique de reconnexion était correcte, mais trois sorties n’étaient pas couvertes, donc « il se répare tout seul » est devenu « il reste à terre » dans des conditions précises.
Un : une plateforme dont le plugin a échoué au chargement ne retentait jamais l’import
Le gateway gère déjà la première moitié : une plateforme activée dont le plugin ne se charge pas au démarrage est signalée et mise en file sur le guetteur de reconnexion comme retrying / adapter_unavailable. Cette file continue de réessayer.
Le problème était ce qu’elle réessayait. Le chargement d’un plugin de plateforme est différé : le registre détient un bail de chargement, et l’import réel a lieu à la première recherche. Si ce chargement différé lève une exception, ou dépasse son délai, le bail est abandonné et le registre oublie simplement la plateforme. Le guetteur continuait de chercher un adaptateur, n’en trouvait aucun, et n’avait rien qui puisse relancer l’import — seule une redécouverte forcée (reload-plugins, le tableau de bord, ou l’outil plugin) redonne un bail au chargeur. La plateforme restait en file indéfiniment pendant que le journal affichait Reconnect <platform>: no adapter yet, next retry in Ns.
Le correctif ajoute rearm_failed_platform() : il trouve le manifeste de plateforme enregistré comme un échec de chargement et réenregistre la plateforme différée, de sorte que la prochaine recherche dans le registre retente l’import. Trois soupapes de sécurité comptent :
- Il refranchit les gardes avant de réarmer. Un espace réservé (désactivé, non activé, retiré du catalogue) et un plugin qui échoue à
requires_hermesont la même forme d’ensemble d’erreurs qu’un échec de chargement, et ils ne sont jamais réarmés. - Il n’empile jamais les threads. Si un worker
plugin-load:bloqué pour ce plugin est encore vivant, le réarmement est ignoré plutôt que de fuir un second thread abandonné. - Il est plafonné. Le guetteur réarme au plus 3 fois par plateforme mise en file (
_MAX_PLUGIN_LOAD_REARMS = 3) : un échec de chargement transitoire se répare, un plugin réellement cassé ne se réimporte pas indéfiniment.
Le réarmement et la recherche du registre qui matérialise le plugin s’exécutent tous deux dans un executor, hors de la boucle d’événements, en conservant les variables de contexte du profil. La ligne à repérer dans votre journal est Re-arming failed platform plugin load: <name>.
Deux : les messages Telegram retenus pendant une déconnexion restaient bloqués sur l’adaptateur retiré
Telegram a une propriété délicate : une mise à jour que python-telegram-bot a déjà acquittée ne peut plus être récupérée. Hermes garde donc les événements acquittés mais non traités dans une file sur l’instance d’adaptateur, et cette instance vide la file elle-même à la reconnexion.
La file appartient à l’instance d’adaptateur — et une erreur fatale mais réessayable (une erreur réseau, un blocage du polling, et depuis un changement ultérieur un blocage de l’ingress) fait construire au runner un nouvel adaptateur. L’ancien chemin de reconnexion transférait les caches de déduplication vers le remplaçant, mais pas la file de rétention, donc les événements retenus avant la reconstruction — plus tout ce que le démontage a récupéré sur l’adaptateur retiré ensuite — restaient bloqués là pour toujours.
La lacune remonte au 11 août, lorsque la file de rétention par instance a été introduite ; un changement du 23 septembre a transféré l’état de déduplication mais pas la file. Le correctif conserve l’adaptateur remplacé sur l’entrée de file de reconnexion comme predecessor et, au moment de la publication — quand le remplaçant est réellement enregistré — appelle hand_over_held_inbound() pour transférer les événements retenus. À savoir :
- un adaptateur candidat qui échoue à se connecter ne prend jamais possession de la file, et la livraison attend que le remplaçant soit enregistré ;
- le transfert relie uniquement la référence de la couche de transport ; l’autorisation de profil et de rôle reste telle qu’elle a été résolue ;
- si l’adaptateur retiré reçoit encore des événements récupérés après le transfert, il les transmet au successeur vivant, en acceptant d’abord sa propre revendication de mise à jour en cours pour que l’accusé de réception soit toujours enregistré ;
- l’utilitaire est sans effet pour les adaptateurs qui n’ont pas de file de rétention — seul Telegram en a une.
Trois : les exécutions /v1 en cours étaient tuées après 0,00 s à l’arrêt du gateway
Le troisième n’est pas « bloqué », c’est « tué trop tôt ». Arrêter ou redémarrer le gateway exécute une phase de drainage pour que le travail en cours puisse se terminer. Ce drainage plaçait les exécutions api_server (/v1) sur le même budget que les tours de chat, et ce budget — restart_drain_timeout — vaut 0 par défaut, car un tour de chat interrompu est acceptable : il est annoncé et peut reprendre.
Une exécution /v1 ne peut pas reprendre. Elle a un appelant HTTP bloqué sur le résultat. Avec la valeur 0 par défaut, la boucle de drainage ne s’exécutait jamais réellement, donc le chemin d’arrêt interrompait chaque exécution /v1 en cours et faisait échouer l’appelant en attente.
Le correctif place les exécutions api_server sur la même échéance que les tâches cron (le plancher agent.cron_drain_timeout, borné par le watchdog). Aucun nouveau compteur et aucune nouvelle clé de configuration. La ligne de journal « waiting up to Ns » du chemin d’arrêt se déclenche désormais aussi lorsque seules des exécutions api_server sont en cours, et inclut leur nombre. Notez la dérogation : cron_drain_timeout: 0 exclut aussi les exécutions /v1 du drainage, et une exécution /v1 interrompue fait échouer son appelant en attente.
Du symptôme au comportement
| Symptôme que vous avez peut-être vu | Ce qui se passe désormais |
|---|---|
Un plugin de plateforme ne se charge pas au démarrage, la plateforme reste à adapter_unavailable, et seul un redémarrage ou reload-plugins la ramène |
Le guetteur de reconnexion réarme le chargement à chaque tick, jusqu’à 3 fois, et la plateforme se répare une fois la cause disparue |
| Un plugin réellement cassé (incompatibilité de version, retiré du catalogue) qui inonde le journal | Il n’est pas réarmé, et les tentatives ne s’accumulent pas |
| Telegram se reconnecte et les messages envoyés pendant la déconnexion semblent disparaître | Les événements retenus sont transférés au nouvel adaptateur et livrés |
Redémarrer le gateway fait échouer chaque appel /v1 en cours |
Ils se terminent dans le délai de drainage ; seul un délai d’expiration ou une dérogation explicite les interrompt |
Les réglages du comportement du gateway en général (intervalles de reconnexion, plafonds, le watchdog) se trouvent dans la référence de commande gateway. Si vous avez traqué une défaillance « processus vivant, plateforme silencieusement disparue », l’article sur le battement de cœur de déconnexion silencieuse couvre la moitié voisine, et le guide du watchdog de boucle explique comment le drainage et le watchdog fonctionnent ensemble.
Statut de release
Les trois correctifs sont sur main et dans aucune étiquette publiée (la release la plus récente est v0.21.5, tag v2026.9.24). Les installations Git les obtiennent en tirant le dernier main ; les images Docker et les déploiements hébergés les obtiennent avec le prochain tag. Si vous faites tourner plusieurs gateways, la règle un seul gateway par hôte s’applique toujours.
La leçon de conception
Les trois se résument au même jugement : une nouvelle tentative doit retenter la bonne couche. Une file vivante sans rien qui relance l’import n’est pas une nouvelle tentative ; transférer l’état de déduplication mais pas la charge utile n’est pas un transfert ; une boucle de drainage avec un budget nul est un coupe-circuit. Quand vous auditez vos propres chemins d’auto-réparation, ne vous arrêtez pas à « y a-t-il une logique de nouvelle tentative » — vérifiez que chaque tentative fait réellement avancer l’état, et qu’elle a un plafond, pour qu’une faute récupérable et une faute permanente ne soient pas traitées de la même façon.