O gateway cura todas as plataformas, menos uma — eis o porquê
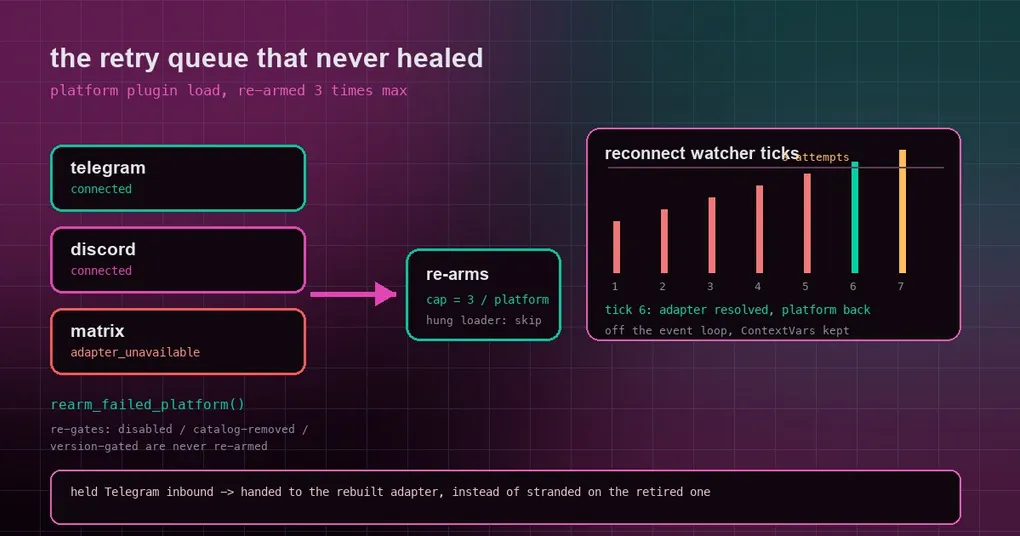
A rede deu uma oscilada durante a noite e o seu gateway do Hermes perdeu a conexão com o Telegram. De manhã, o gateway está de pé, todas as outras plataformas vão bem, e o Telegram continua parado em “reconnecting” desde então. Você reinicia o gateway e ele volta. Essa classe de bug é a pior de diagnosticar — nada quebrou, existe apenas uma fila de retry que nunca vai avançar.
Três correções mescladas em 5 de outubro de 2026 (#133289, #133228, #133230) cobrem exatamente três desses casos. Elas compartilham um formato: a máquina de reconexão estava boa, mas três saídas não estavam cobertas, então “ele se cura sozinho” virava “ele fica fora do ar” sob condições específicas.
Um: uma plataforma cujo plugin falhou ao carregar nunca tentava o import de novo
O gateway já dá conta da primeira metade: uma plataforma habilitada cujo plugin falha ao carregar na inicialização é marcada e enfileirada no watcher de reconexão como retrying / adapter_unavailable. Essa fila segue tentando.
O problema era o que ela tentava de novo. O carregamento de plugin de plataforma é adiado: o registry guarda um lease de carregamento, e o import de fato acontece na primeira consulta. Se esse carregamento adiado lança exceção, ou estoura o prazo, o lease é descartado e o registry simplesmente esquece a plataforma. O watcher continuava procurando um adapter, continuava não encontrando nenhum, e não tinha nada capaz de rodar o import de novo — só uma redescoberta forçada (reload-plugins, o dashboard ou a ferramenta de plugin) renova o lease do loader. A plataforma ficava enfileirada indefinidamente enquanto o log imprimia Reconnect <platform>: no adapter yet, next retry in Ns.
A correção adiciona rearm_failed_platform(): ela encontra o manifest da plataforma registrado como falha de carregamento e registra de novo a plataforma adiada, para que a próxima consulta ao registry tente o import outra vez. Três válvulas de segurança importam:
- Ela revalida os portões antes de rearmar. Um placeholder (desabilitado, não habilitado, removido do catálogo) e um plugin que falha em
requires_hermestêm o mesmo formato de conjunto de erros de uma falha de carregamento, e nunca são rearmados. - Ela nunca empilha threads. Se um worker
plugin-load:travado daquele plugin ainda estiver vivo, o rearm é ignorado em vez de vazar uma segunda thread abandonada. - Ela tem teto. O watcher rearma no máximo 3 vezes por plataforma enfileirada (
_MAX_PLUGIN_LOAD_REARMS = 3): uma falha de carregamento transitória se cura, um plugin de fato quebrado não se reimporta para sempre.
Tanto o rearm quanto a consulta ao registry que materializa o plugin rodam num executor, fora do event loop, com as variáveis de contexto de profile preservadas. A linha a procurar no seu log é Re-arming failed platform plugin load: <name>.
Dois: mensagens do Telegram retidas durante uma desconexão ficavam presas no adapter aposentado
O Telegram tem uma propriedade incômoda: um update que o python-telegram-bot já confirmou não pode ser buscado de novo. Por isso o Hermes guarda os eventos confirmados mas ainda não processados numa fila dentro da instância do adapter, e essa instância drena a fila sozinha quando se reconecta.
A fila pertence à instância do adapter — e um erro fatal que permite retry (um erro de rede, um travamento de polling e, desde uma mudança posterior, um travamento de ingress) faz o runner construir um adapter novo. O caminho antigo de reconexão levava os caches de dedup para o substituto, mas não a fila de retenção, então os eventos retidos antes da reconstrução — mais tudo que o teardown resgatou no adapter aposentado depois disso — ficavam presos ali para sempre.
A lacuna vem de 11 de agosto, quando a fila de retenção por instância foi introduzida; uma mudança de 23 de setembro levou o estado de dedup, mas não a fila. A correção mantém o adapter substituído na entrada da fila de reconexão como predecessor e, no momento da publicação — quando o substituto é de fato registrado — chama hand_over_held_inbound() para transportar os eventos retidos. Vale saber:
- um adapter candidato que falha ao conectar nunca assume a posse da fila, e a entrega espera até o substituto ser registrado;
- a passagem religa apenas a referência da camada de transporte; a autorização de profile e de papel fica como foi resolvida;
- se o adapter aposentado ainda recebe eventos resgatados depois da passagem, ele os repassa para o sucessor vivo, aceitando antes a sua própria reivindicação de update em andamento para que o recibo ainda seja registrado;
- o helper é um no-op para adapters que não têm fila de retenção — só o Telegram tem uma.
Três: execuções /v1 em andamento eram mortas após 0,00s na parada do gateway
A terceira não é “travada”, é “morta cedo demais”. Parar ou reiniciar o gateway roda uma fase de drain para que o trabalho em andamento consiga terminar. Esse drain colocava as execuções do api_server (/v1) no mesmo orçamento dos turnos de chat, e esse orçamento — restart_drain_timeout — é 0 por padrão, porque um turno de chat interrompido é aceitável: ele é anunciado e pode retomar.
Uma execução /v1 não pode retomar. Ela tem um chamador HTTP bloqueado esperando o resultado. Com o 0 padrão, o loop de drain nunca rodava de fato, então o caminho de shutdown interrompia toda execução /v1 em andamento e fazia o chamador à espera falhar.
A correção coloca as execuções do api_server no mesmo prazo dos cron jobs (o piso de agent.cron_drain_timeout, com clamp do watchdog). Nenhum contador novo e nenhuma chave de config nova. A linha de log do caminho de parada, “waiting up to Ns”, agora também dispara quando só há execuções do api_server em andamento, e inclui a contagem delas. Note o opt-out: cron_drain_timeout: 0 também tira as execuções /v1 do drain, e uma execução /v1 interrompida faz o chamador à espera falhar.
Do sintoma ao comportamento
| Sintoma que você pode ter visto | O que acontece agora |
|---|---|
Um plugin de plataforma falha ao carregar na inicialização, a plataforma fica em adapter_unavailable e só um restart ou reload-plugins a traz de volta |
O watcher de reconexão rearma o carregamento a cada tick, até 3 vezes, e a plataforma se cura quando a causa desaparece |
| Um plugin de fato quebrado (versão incompatível, removido do catálogo) inundando o log | Ele não é rearmado, e os retries não se acumulam |
| O Telegram se reconecta e mensagens enviadas durante a desconexão parecem sumir | Os eventos retidos são passados ao novo adapter e entregues |
Reiniciar o gateway faz toda chamada /v1 em andamento falhar |
Elas terminam dentro do prazo de drain; só um timeout ou um opt-out explícito as interrompe |
Os ajustes do comportamento do gateway em geral (intervalos de reconexão, tetos, o watchdog) estão na referência do comando gateway. Se você já correu atrás de uma falha do tipo “processo vivo, plataforma sumiu em silêncio”, o post heartbeat de desconexão silenciosa cobre a metade adjacente, e o guia do loop watchdog explica como o drain e o watchdog trabalham juntos.
Status da release
As três correções estão na main e em nenhuma tag publicada (a release mais recente é a v0.21.5, tag v2026.9.24). Instalações via Git as recebem ao puxar a main mais recente; imagens Docker e implantações hospedadas as recebem com a próxima tag. Se você roda vários gateways, a regra de um gateway por host continua valendo.
A lição de design
As três se resumem ao mesmo julgamento: um retry tem que retentar a camada certa. Uma fila viva sem nada que rode o import de novo não é um retry; levar o estado de dedup mas não o payload não é uma passagem; um loop de drain com orçamento zero é um interruptor de morte. Quando você auditar os seus próprios caminhos de autocura, não pare em “existe lógica de retry” — confira se cada tentativa de fato faz o estado avançar, e se ela tem teto, para que uma falha recuperável e uma permanente não sejam tratadas igual.