Das Gateway heilt jede Plattform außer einer — hier ist warum
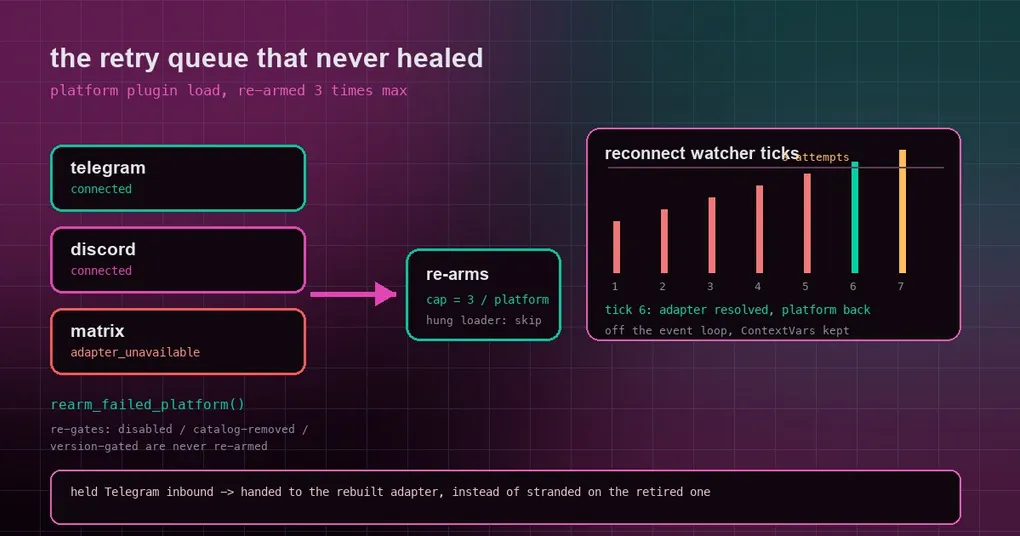
Das Netzwerk hatte nachts einen Aussetzer und dein Hermes-Gateway verlor seine Telegram-Verbindung. Am Morgen läuft das Gateway, jede andere Plattform ist in Ordnung, und Telegram hängt seitdem auf „reconnecting“. Du startest das Gateway neu und es kommt zurück. Diese Fehlerklasse ist am schlimmsten zu diagnostizieren — nichts ist abgestürzt, es gibt nur eine Retry-Queue, die nie vorankommt.
Drei Fixes, am 5. Oktober 2026 zusammengeführt (#133289, #133228, #133230), decken genau drei solche Fälle ab. Sie haben eine gemeinsame Form: die Reconnect-Maschinerie war in Ordnung, aber drei Ausgänge waren nicht abgedeckt, sodass „es heilt sich selbst“ unter bestimmten Bedingungen zu „es bleibt unten“ wurde.
Eins: Eine Plattform, deren Plugin nicht geladen werden konnte, versuchte den Import nie erneut
Das Gateway behandelt bereits die erste Hälfte: Eine aktivierte Plattform, deren Plugin beim Start nicht geladen werden kann, wird markiert und im Reconnect-Watcher als retrying / adapter_unavailable eingereiht. Diese Queue versucht es weiter.
Das Problem war, was sie zu wiederholen versuchte. Das Laden von Plattform-Plugins ist aufgeschoben: Die Registry hält ein Load-Lease, und der eigentliche Import erfolgt beim ersten Lookup. Wenn dieser aufgeschobene Load eine Exception wirft oder seine Deadline überschreitet, wird das Lease verworfen und die Registry vergisst die Plattform einfach. Der Watcher suchte weiter nach einem Adapter, fand keinen und hatte nichts, was den Import erneut ausführen konnte — nur eine erzwungene Neu-Erkennung (reload-plugins, das Dashboard oder das Plugin-Tool) leased den Loader neu. Die Plattform blieb unbegrenzt in der Queue, während das Log Reconnect <platform>: no adapter yet, next retry in Ns ausgab.
Der Fix ergänzt rearm_failed_platform(): Es findet das als fehlgeschlagenen Load festgehaltene Plattform-Manifest und registriert die aufgeschobene Plattform erneut, sodass der nächste Registry-Lookup den Import erneut versucht. Drei Sicherheitsventile sind wichtig:
- Es re-gated, bevor es re-armt. Ein Platzhalter (deaktiviert, nicht aktiviert, aus dem Katalog entfernt) und ein Plugin, das
requires_hermesnicht erfüllt, haben dieselbe Fehlermenge wie ein fehlgeschlagener Load, und sie werden nie re-armt. - Es stapelt nie Threads. Wenn ein hängender
plugin-load:-Worker für dieses Plugin noch lebt, wird das Re-Arm übersprungen, statt einen zweiten verwaisten Thread zu leaken. - Es ist gedeckelt. Der Watcher re-armt höchstens 3-mal pro eingereihter Plattform (
_MAX_PLUGIN_LOAD_REARMS = 3): Ein vorübergehender Load-Fehler heilt, ein wirklich kaputtes Plugin importiert nicht ewig neu.
Sowohl das Re-Arm als auch der Registry-Lookup, der das Plugin materialisiert, laufen in einem Executor, abseits des Event-Loops, wobei Profil-Kontextvariablen erhalten bleiben. Die Zeile, nach der du in deinem Log suchen solltest, ist Re-arming failed platform plugin load: <name>.
Zwei: Während eines Disconnects gehaltene Telegram-Nachrichten strandeten auf dem ausrangierten Adapter
Telegram hat eine unangenehme Eigenschaft: Ein Update, das python-telegram-bot bereits bestätigt hat, kann nicht erneut abgerufen werden. Deshalb hält Hermes bestätigte, aber noch nicht verarbeitete Events in einer Queue auf der Adapter-Instanz, und diese Instanz leert die Queue selbst, wenn sie sich wieder verbindet.
Die Queue gehört zur Adapter-Instanz — und ein wiederholbarer fataler Fehler (ein Netzwerkfehler, ein Polling-Stall und seit einer späteren Änderung ein Ingress-Stall) lässt den Runner einen neuen Adapter bauen. Der alte Reconnect-Pfad übertrug die Dedup-Caches auf den Ersatz, aber nicht die Hold-Queue, sodass vor dem Neuaufbau gehaltene Events — plus alles, was der Teardown danach noch auf den ausrangierten Adapter rettete — dort für immer strandeten.
Die Lücke reicht bis zum 11. August zurück, als die Hold-Queue pro Instanz eingeführt wurde; eine Änderung vom 23. September übertrug den Dedup-Zustand, aber nicht die Queue. Der Fix behält den ersetzten Adapter als predecessor im Reconnect-Queue-Eintrag und ruft zur Publish-Zeit — wenn der Ersatz tatsächlich registriert wird — hand_over_held_inbound() auf, um die gehaltenen Events herüberzubewegen. Wissenswert:
- ein Kandidaten-Adapter, dessen Verbindung fehlschlägt, übernimmt die Queue nie, und die Zustellung wartet, bis der Ersatz registriert ist;
- die Übergabe bindet nur die Transport-Layer-Referenz neu; Profil- und Rollen-Autorisierung bleiben wie aufgelöst;
- wenn der ausrangierte Adapter nach der Übergabe noch gerettete Events empfängt, leitet er sie an den lebenden Nachfolger weiter und akzeptiert zuerst seinen eigenen In-Flight-Update-Anspruch, damit der Empfang weiterhin festgehalten wird;
- der Helper ist ein No-Op für Adapter ohne Hold-Queue — nur Telegram hat eine.
Drei: Laufende /v1-Runs wurden beim Gateway-Stop nach 0,00 s abgewürgt
Der dritte ist nicht „festgefahren“, sondern „zu früh abgewürgt“. Das Stoppen oder Neustarten des Gateways führt eine Drain-Phase aus, damit laufende Arbeit fertig werden kann. Dieser Drain stellte api_server-Runs (/v1) auf dasselbe Budget wie Chat-Turns, und dieses Budget — restart_drain_timeout — ist standardmäßig 0, weil ein unterbrochener Chat-Turn akzeptabel ist: Er wird angekündigt und kann fortgesetzt werden.
Ein /v1-Run kann nicht fortgesetzt werden. Er hat einen HTTP-Aufrufer, der auf das Ergebnis blockiert. Mit dem Standardwert 0 lief die Drain-Schleife nie wirklich, sodass der Shutdown-Pfad jeden laufenden /v1-Run unterbrach und den wartenden Aufrufer scheitern ließ.
Der Fix stellt api_server-Runs auf dieselbe Deadline wie Cron-Jobs (der agent.cron_drain_timeout-Floor, vom Watchdog begrenzt). Kein neuer Zähler und kein neuer Config-Key. Die Log-Zeile „warte bis zu Ns“ im Stop-Pfad erscheint jetzt auch, wenn nur api_server-Runs laufen, und nennt deren Anzahl. Beachte den Opt-out: cron_drain_timeout: 0 nimmt /v1-Runs ebenfalls vom Drain aus, und ein unterbrochener /v1-Run lässt seinen wartenden Aufrufer scheitern.
Vom Symptom zum Verhalten
| Symptom, das du gesehen haben könntest | Was jetzt passiert |
|---|---|
Das Plugin einer Plattform lädt beim Start nicht, die Plattform hängt auf adapter_unavailable, und nur ein Neustart oder reload-plugins bringt sie zurück |
Der Reconnect-Watcher re-armt den Load bei jedem Tick, bis zu 3-mal, und die Plattform heilt, sobald die Ursache weg ist |
| Ein wirklich kaputtes Plugin (Versionskonflikt, aus dem Katalog entfernt) spammt das Log | Es wird nicht re-armt, und Retries stapeln sich nicht |
| Telegram verbindet sich neu und während des Disconnects gesendete Nachrichten scheinen zu verschwinden | Gehaltene Events werden an den neuen Adapter übergeben und zugestellt |
Ein Neustart des Gateways lässt jeden laufenden /v1-Aufruf scheitern |
Sie werden innerhalb der Drain-Deadline fertig; nur ein Timeout oder ein expliziter Opt-out unterbricht sie |
Die Knöpfe für das Gateway-Verhalten im Allgemeinen (Reconnect-Intervalle, Caps, der Watchdog) stehen in der Gateway-Befehlsreferenz. Wenn du einem Fehler der Art „Prozess lebt, Plattform still verschwunden“ nachgejagt bist, deckt der Beitrag zum stillen Disconnect-Heartbeat die angrenzende Hälfte ab, und die Loop-Watchdog-Anleitung erklärt, wie Drain und Watchdog zusammenwirken.
Release-Status
Alle drei Fixes sind auf main und in keinem veröffentlichten Tag (die neueste Version ist v0.21.5, Tag v2026.9.24). Git-Installationen bekommen sie, indem sie das neueste main ziehen; Docker-Images und gehostete Deployments erhalten sie mit dem nächsten Tag. Wenn du mehrere Gateways betreibst, gilt weiterhin die Regel ein Gateway pro Host.
Die Design-Lektion
Alle drei laufen auf dieselbe Einschätzung hinaus: ein Retry muss die richtige Ebene erneut versuchen. Eine lebende Queue ohne etwas, das den Import erneut ausführt, ist kein Retry; Dedup-Zustand zu übertragen, aber nicht die Payload, ist keine Übergabe; eine Drain-Schleife mit Null-Budget ist ein Kill-Switch. Wenn du deine eigenen Selbstheilungspfade prüfst, hör nicht bei „gibt es Retry-Logik“ auf — prüfe, dass jeder Versuch den Zustand wirklich voranbringt, und dass er eine Obergrenze hat, damit ein behebbarer Fehler und ein permanenter nicht gleich behandelt werden.