合上笔记本,/loop 就停了:Hermes 让无人值守的循环真正跑下去
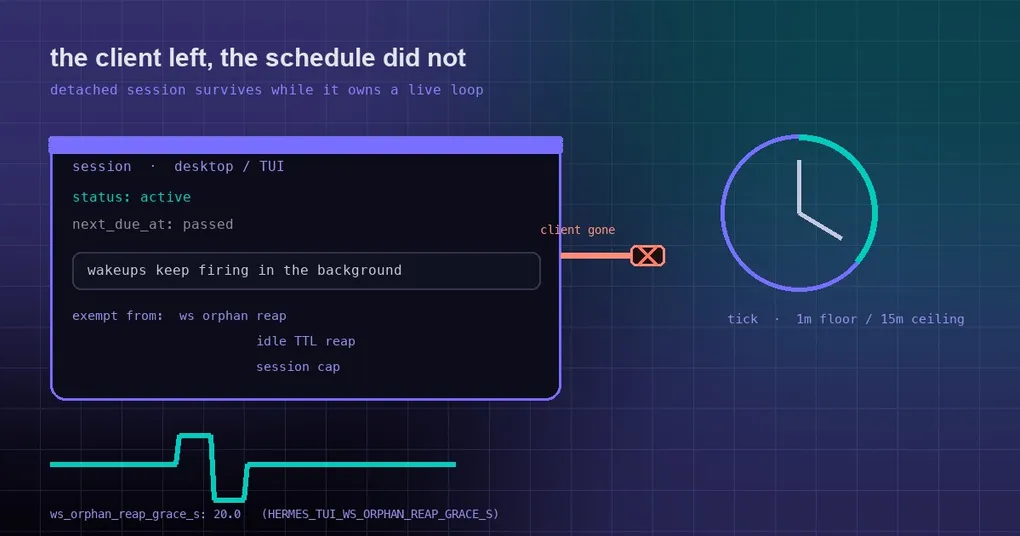
晚上十一点,你在桌面应用里敲下 /loop 10m 盯着 CI,绿了就告诉我,然后合上笔记本去睡。第二天早上打开电脑,聊天记录里一条唤醒都没有。你查状态,循环还写着 active,下一次该触发的时间早就过去了——它只是从某一刻起再也没被谁叫醒。
这是 /loop 和 /heartbeat 在桌面应用、dashboard 与 TUI 里的一个真实缺陷:客户端一断开,会话就被回收线程收走,循环随之冻结。10 月 9 日的 PR #135393 修掉了它,方式很直白——让“手上还握着一个活跃日程”的会话免于回收。这篇讲清楚为什么它会冻住、修复怎么做的、以及哪些情况它依然救不了。
先搞懂:谁负责给循环“点名”
/loop 是会话内的定时器:每隔一段时间,它把你的 prompt 当成一次真实对话重新跑一遍(看 CI、看队列、看文件现在长什么样),而不是把第一次的结果重复播一遍。它的唤醒需要有人“点名”。
Hermes 里点名的人有两种:
- 带路由的循环:在 Telegram、Discord、Slack 这类消息平台上设的
/loop,状态里带着route(平台 + chat_id)。它们由消息网关自己的唤醒扫描器负责触发,具体在gateway/run_goals.py::_loop_wakeup_fire_one。这类循环从来不依赖有没有客户端连着。 - 不带路由的循环:在桌面应用、dashboard 聊天或 TUI 里设的循环没有 route,唯一的驱动者是该会话所属后端进程里的每会话通知轮询线程(
tui_gateway/session_notifications.py里的_maybe_fire_tui_loop_tick/_maybe_fire_tui_heartbeat_tick)。
第二条就是问题所在:这个轮询线程随会话记录一起生、一起死。客户端断开时的流程是这样:
_schedule_ws_orphan_reap起一个计时器,宽限期由ws_orphan_reap_grace_s决定,默认 20 秒;- 计时器触发时,一个空闲(
running=False)的分离会话被弹出并拆除——只有活跃的委派任务和正好在跑的一轮对话能豁免; - 拆除会设置轮询线程的 stop 事件,之后再也没有 tick 被认领;
- 循环的持久化状态仍然是
active,next_due_at只是空转过去。重新连上时,过期的那一次会补触发一次(不会爆发式补齐)。
TTL 回收器(_reap_idle_sessions)和会话数量上限(_enforce_session_cap)后来也会以同样的理由收走同一个会话。
修复:持有活跃日程的会话,回收器放过它
补丁加了一个判断函数 _session_owns_live_wakeup_schedule(session),语义是:如果本进程是某个 active 的 /loop 或 /heartbeat 的唯一驱动者,就必须留住这个分离会话(以及跟着它的轮询线程),否则日程会冻结到客户端重新连上为止。 带路由的日程由网关负责触发,所以它们不会在这里把会话钉住。
三个回收点现在都会先问这个函数:WebSocket 孤儿回收、空闲 TTL 回收、会话上限裁剪。
边界是刻意设计的,不是“永远留着”:
- 循环跑到自己的 tick 预算会自然暂停(
/loop的自我节流与预算上限本来就是有界的); - 循环被停止或暂停,会话立刻回到可回收状态;
- 判断失败时向 False 回退——读不到状态存储,绝不能把会话变成永远回收不掉的僵尸。
同一天还有第二处修复:已经结算的中断
这个豁免本身也踩过一个坑。一个被中断的分离回合会同时置上 client-gone 和 turn-cancel 两个闩锁;如果活跃的 /loop 在那轮对话已经结算之后又重新武装了孤儿计时器,那两个闩锁就永远清不掉了——没有 tick 能认领这一轮,每次重连还会被 4009 拒绝,循环永远走不到自己的预算。
同一天合并的 0670ba4524 处理了这条死锁路径:已结算的 client-gone 中断优先于唤醒日程豁免。这也是“一个修复带来的新状态机”必须跟一轮补丁的典型例子,两个提交在同一个窗口里落地。
哪些情况它救不了
- 后端进程必须活着。 桌面应用自带的本地后端会随应用一起退出。想跑无人值守的循环,得让会话活在长期运行的后端上——比如远程
hermes serve,或者 dashboard。 - 真的要跨重启、跨终端,
/loop本身就不是那个工具:它活在会话里,cron 活在所有会话之外。什么时候该用 cron,可以看这份 cron 自动化完整指南与 hermes cron 命令参考。 /loop的使用方法(固定间隔与自适应节奏、/proactive别名)在这篇导读里有完整例子。
相关旋钮与命令
ws_orphan_reap_grace_s 默认 20.0 秒,可以用环境变量 HERMES_TUI_WS_ORPHAN_REAP_GRACE_S 覆盖;官方配置文档的建议是:如果你这边的客户端重连比较慢,把宽限期和 keepalive 相关值一起调大。文档同时说明,周期性的会话维护也会替已关闭的 socket 完成清理、并重新武装丢失的孤儿计时器,所以一个分离会话不会因为“初始清理或计时器丢了”就永久占着归属租约。
日常用法速查:
/loop 5m check the deploy status and tell me if it's live yet
/loop 10m /recap
/loop            # 不给间隔:由 Hermes 自适应节奏(1 分钟起步,最高 15 分钟)
/heartbeat       # 让会话自己定期汇报,而不是反复跑一段提示
发布状态
PR #135393 与后续的 0670ba4524 都合并于 2026-10-09,晚于 v0.21.6(10 月 8 日发布),因此目前只在 origin/main 上。跑 hermes update 可以跟进主线,或者等下一个版本。这一版的整体修复情况可以看我们的 v0.21.6 发布页。
小结
循环冻结这件事的根因不是“定时器不准”,而是会话回收策略不知道这个会话还有活要干。修好它的关键,是让回收器能问出一个明确的问题:这个进程是不是某个活跃日程的唯一驱动者? 是,就留着;日程结束、暂停或读不到状态,就照旧回收。想让循环真正无人值守,除了升级,你还得保证后端进程本身活得比你的笔记本久——这一条是配置问题,不是 bug。