Klapp den Laptop zu und dein /loop stirbt: Warum abgekoppelte Schedules jetzt überleben
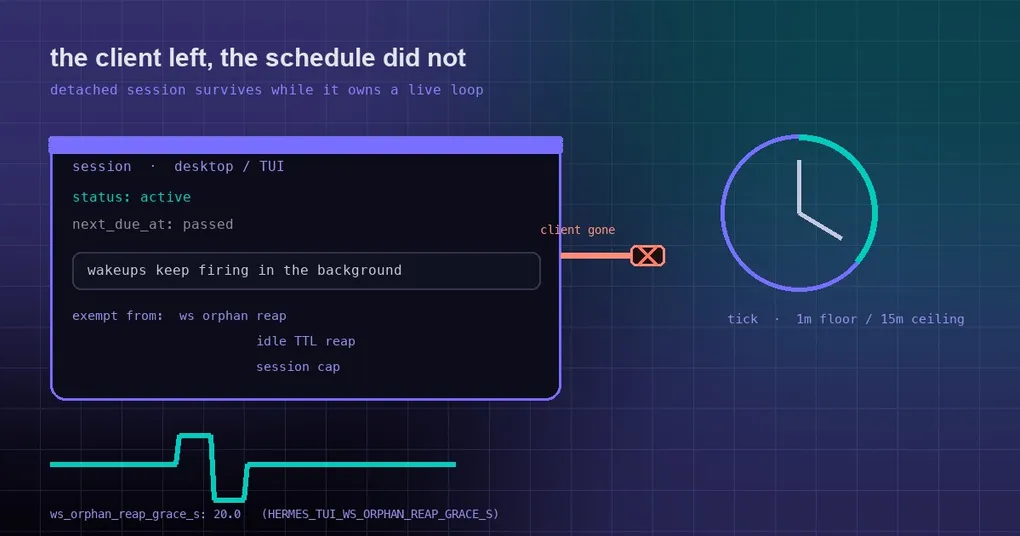
Es ist 23 Uhr. Du tippst /loop 10m watch the CI build and tell me when it's green in die Desktop-App, klappst den Laptop zu und gehst ins Bett. Am Morgen ist der Thread leer — überhaupt keine Wakeups. Der Status des Loops sagt immer noch active, und sein nächster Fälligkeitszeitpunkt liegt Stunden zurück. Nichts hat den Timer eingefroren; es war einfach niemand mehr da, der ihn hätte auslösen können.
Das war ein echter Defekt für /loop und /heartbeat in der Desktop-App, im Dashboard-Chat und in der TUI: In dem Moment, in dem der Client die Verbindung trennte, wurde die Session zurückgeholt und der Schedule ging mit ihr. PR #135393 behob das am 9. Oktober mit einer direkten Idee — eine Session, die noch einen lebenden Schedule besitzt, ist von den Reapers ausgenommen. Hier ist, warum es einfror, was der Fix tut und wo er dir immer noch nicht helfen kann.
Zuerst: Wer löst einen Loop-Tick aus?
/loop ist ein In-Session-Timer. Jeder Tick führt deinen Prompt als echten Turn gegen den aktuellen Zustand erneut aus — prüfe den CI-Lauf, prüfe die Queue, lies die Datei so, wie sie jetzt ist — statt die erste Antwort erneut abzuspielen. Ticks brauchen jemanden, der sie auslöst.
Es gibt zwei Arten von Treibern in Hermes:
- Geroutete Loops. Ein von einer Messaging-Plattform (Telegram, Discord, Slack, …) gesetztes
/loopträgt eineroute(Plattform + chat_id) in seinem Zustand. Der eigene Wakeup-Scanner des Messaging-Gateways löst diese aus —gateway/run_goals.py::_loop_wakeup_fire_one. Sie waren nie darauf angewiesen, dass ein Client angehängt ist. - Routelose Loops. Ein in der Desktop-App, im Dashboard-Chat oder in der TUI gesetztes Loop hat keine Route. Sein einziger Treiber ist der Notification-Poller-Thread pro Session innerhalb des servierenden Backends —
_maybe_fire_tui_loop_tick/_maybe_fire_tui_heartbeat_tickintui_gateway/session_notifications.py.
Die zweite Art ist das Problem, weil dieser Thread mit dem Session-Datensatz geboren wird und stirbt. Beim Trennen:
_schedule_ws_orphan_reapstellt einen Timer scharf, dessen Schonfrist ausws_orphan_reap_grace_skommt — standardmäßig 20 Sekunden;- wenn er auslöst, wird eine idle (
running=False) abgekoppelte Session herausgenommen und abgeräumt. Nur laufende delegierte Arbeit und ein Turn, der tatsächlich läuft, sind ausgenommen; - der Teardown setzt das Stop-Event des Pollers, sodass nie wieder ein Tick beansprucht wird;
- der persistierte Loop-Zustand liest weiterhin
active, undnext_due_atvergeht einfach. Beim Wiederanhängen feuert der überfällige Tick einmal — kein Schwall von Nachhol-Ticks.
Der TTL-Reaper (_reap_idle_sessions) und die Session-Obergrenze (_enforce_session_cap) können dieselbe Session später aus demselben Grund einsammeln.
Der Fix: Gehört der Schedule dir zum Auslösen, bleibt die Session
Der Patch fügt eine Prüfung hinzu, _session_owns_live_wakeup_schedule(session), die genau Folgendes bedeutet: Ist dieser Prozess der einzige Treiber eines aktiven /loop oder /heartbeat für diese Session, müssen die Reaper die abgekoppelte Session — und mit ihr den Poller — am Leben lassen, sonst friert der Schedule ein, bis sich ein Client wieder anhängt. Geroutete Schedules werden vom Gateway ausgelöst, sie pinnen hier also nie eine Session.
Alle drei Reaping-Pfade stellen jetzt zuerst diese Frage: der WebSocket-Orphan-Reaper, der Idle-TTL-Reaper und der Session-Cap-Trim.
Die Grenzen sind bewusst gewählt statt „für immer behalten“:
- ein Loop pausiert nach seinem eigenen Tick-Budget (sowohl Selbst-Taktung als auch die Budget-Obergrenze sind begrenzt);
- ein gestoppter oder pausierter Schedule gibt die Session sofort frei;
- die Prüfung schlägt offen nach
Falsefehl — ein unlesbarer State-Store darf niemals eine Session unreapbar machen.
Ein zweiter Fix landete am selben Tag: abgewickelte Interrupts
Die Ausnahme selbst hatte einen Deadlock. Ein unterbrochener abgekoppelter Turn setzt sowohl das Client-weg- als auch das Turn-Cancel-Latch. Wenn das aktive /loop dann den Orphan-Timer erneut scharf stellte, nachdem dieser Turn bereits abgewickelt war, wurde kein Latch je freigegeben: kein Tick konnte den Turn beanspruchen, und jedes Wiederanhängen wurde mit 4009 abgelehnt, sodass der Loop nie sein Budget erreichte.
Commit 0670ba4524, am selben Tag gemergt, löst das: Ein abgewickelter Client-weg-Interrupt schlägt die Wakeup-Schedule-Ausnahme. Das ist eine gute Illustration dafür, warum ein State-Machine-Fix normalerweise im selben Fenster einen Follow-up braucht — und beide Commits sind im selben Batch.
Wo es weiterhin nicht helfen kann
- Der Backend-Prozess muss am Leben bleiben. Ein von der Desktop-App gestartetes lokales Backend beendet sich mit der App. Für unbeaufsichtigte Loops fahre die Session auf einem langlebigen Backend — einem entfernten
hermes serveoder dem Dashboard. - Für Arbeit, die Neustarts und Terminals überleben muss, ist
/loopvon Design her das falsche Tool: Es lebt innerhalb einer Session, während cron außerhalb aller lebt. Zu dieser Aufteilung siehe unseren vollständigen Cron-Automatisierungs-Guide und die hermes-cron-Referenz. - Für
/loopselbst — feste Intervalle, selbstgetaktete Kadenz, der/proactive-Alias — hat der Loop-Befehl-Guide die durchgearbeiteten Beispiele.
Der Schalter und die Befehle
ws_orphan_reap_grace_s ist standardmäßig 20.0 Sekunden und kann mit der Umgebungsvariable HERMES_TUI_WS_ORPHAN_REAP_GRACE_S überschrieben werden. Die offiziellen Konfigurationsdokumente empfehlen, ihn zusammen mit den Keepalive-Werten zu erhöhen, wenn sich deine Clients langsam wieder verbinden, und merken an, dass die periodische Session-Wartung auch das Aufräumen für geschlossene Sockets abschließt und einen fehlenden Orphan-Timer neu scharf stellt — ein abgekoppelter Chat kann seine Ownership-Lease also nicht für immer halten, nur weil sein ursprüngliches Cleanup oder sein Timer verloren ging.
Im Alltag:
/loop 5m check the deploy status and tell me if it's live yet
/loop 10m /recap
/loop            # kein Intervall: Hermes taktet sich selbst (Untergrenze 1m, Obergrenze 15m)
/heartbeat       # die Session berichtet in einer Kadenz, statt einen Prompt erneut auszuführen
Release-Status
PR #135393 und der Follow-up 0670ba4524 wurden beide am 2026-10-09 gemergt, nachdem v0.21.6 am 8. Oktober ausgeliefert wurde, also sind sie im Moment nur auf origin/main. hermes update holt sie, oder warte auf das nächste Release; das breitere Stabilitätsbild steht auf unserer v0.21.6-Release-Seite.
Das Fazit
Der Bug war kein ungenauer Timer. Es war ein Reaper, der nicht wusste, dass die Session noch ausstehende Arbeit hatte. Der Fix gibt dem Reaper eine einzige explizite Frage zum Stellen — ist dieser Prozess der alleinige Treiber eines lebenden Schedules? — und erst dann verweigert er das Einsammeln. Wenn ein Loop wirklich unbeaufsichtigt laufen soll, ist das Upgrade die eine Hälfte; die andere ist, sicherzustellen, dass das Backend deinen Laptop überlebt, und das ist eine Deployment-Entscheidung, kein Bug.