Cierra el portátil y tu /loop muere: por qué los horarios desacoplados ahora sobreviven
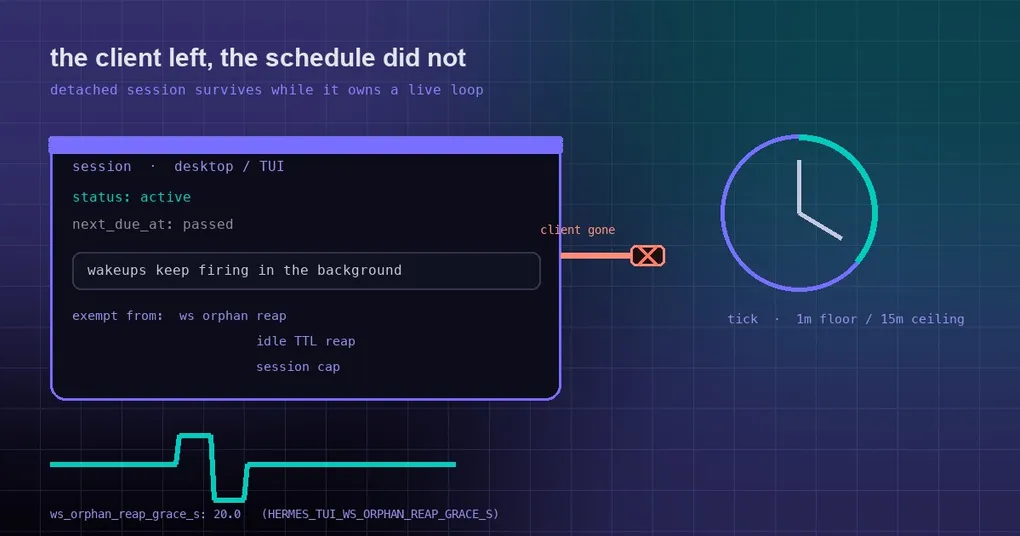
Son las 11 de la noche. Escribes /loop 10m watch the CI build and tell me when it's green en la app de escritorio, cierras el portátil y te vas a la cama. Por la mañana el hilo está vacío: ningún wakeup en absoluto. El estado del loop sigue diciendo active, y su próxima hora prevista pasó hace horas. Nada congeló el temporizador; no quedaba nadie para dispararlo.
Ese fue un defecto real de /loop y /heartbeat en la app de escritorio, el chat del dashboard y la TUI: en el momento en que el cliente se desconectaba, la session se reclamaba y el horario se iba con ella. El PR #135393 lo corrigió el 9 de octubre con una idea directa: una session que todavía tiene un horario activo queda exenta de los reapers. Aquí tienes por qué se congelaba, qué hace el arreglo y dónde todavía no puede ayudarte.
Primero: ¿quién dispara un tick de loop?
/loop es un temporizador dentro de la session. Cada tick vuelve a ejecutar tu prompt como un turn real contra el estado actual —comprueba la ejecución de CI, comprueba la cola, lee el archivo tal como está ahora— en lugar de repetir la primera respuesta. Los ticks necesitan a alguien que los dispare.
Hay dos tipos de motor en Hermes:
- Loops enrutados. Un
/loopdefinido desde una plataforma de mensajería (Telegram, Discord, Slack, …) lleva unaroute(plataforma + chat_id) en su estado. El propio escáner de wakeups del gateway de mensajería los dispara:gateway/run_goals.py::_loop_wakeup_fire_one. Nunca dependieron de que hubiera un cliente conectado. - Loops sin ruta. Un loop definido en la app de escritorio, el chat del dashboard o la TUI no tiene ruta. Su único motor es el hilo poller de notificaciones por session dentro del backend que atiende:
_maybe_fire_tui_loop_tick/_maybe_fire_tui_heartbeat_tickentui_gateway/session_notifications.py.
El segundo tipo es el problema, porque ese hilo nace y muere con el registro de la session. Al desconectarse:
_schedule_ws_orphan_reaparma un temporizador cuyo periodo de gracia viene dews_orphan_reap_grace_s: 20 segundos por defecto;- cuando se dispara, una session desacoplada inactiva (
running=False) se saca y se desmonta. Solo quedan exentos el trabajo delegado vivo y un turn que se esté ejecutando de verdad; - el desmontaje activa el evento de parada del poller, así que no se reclama ningún tick más;
- el estado del loop persistido todavía se lee como
active, ynext_due_atsimplemente pasa. Al reconectar, el tick vencido se dispara una vez: sin una ráfaga de ticks de recuperación.
El reaper de TTL (_reap_idle_sessions) y el tope de sessions (_enforce_session_cap) pueden recoger la misma session más tarde por la misma razón.
El arreglo: si el horario es tuyo para dispararlo, la session se queda
El parche añade una comprobación, _session_owns_live_wakeup_schedule(session), que significa exactamente esto: si este proceso es el único motor de un /loop o /heartbeat activo para esa session, los reapers deben mantener viva la session desacoplada —y con ella el poller— o el horario se congela hasta que un cliente vuelva a conectarse. Los horarios enrutados los dispara el gateway, así que aquí nunca fijan una session.
Las tres rutas de reaping ahora hacen primero esa pregunta: el reaper de huérfanos de WebSocket, el reaper de TTL por inactividad y el recorte por tope de sessions.
Los límites son deliberados, no un «mantenerlo para siempre»:
- un loop se pausa con su propio presupuesto de ticks (tanto el autocompaso como el techo del presupuesto están acotados);
- un horario detenido o pausado libera la session de inmediato;
- la comprobación falla en abierto hacia
False: un almacén de estado ilegible nunca debe hacer que una session no se pueda reapear.
Un segundo arreglo llegó el mismo día: interrupciones resueltas
La propia exención tenía un interbloqueo. Un turn desacoplado interrumpido activa tanto el latch de cliente ausente como el de cancelación del turn. Si el /loop activo entonces volvía a armar el temporizador de huérfanos después de que ese turn ya se hubiera resuelto, ninguno de los dos latches se limpiaba nunca: ningún tick podía reclamar el turn, y toda reconexión se rechazaba con 4009, así que el loop nunca alcanzaba su presupuesto.
El commit 0670ba4524, fusionado el mismo día, lo resuelve: una interrupción por cliente-ausente ya resuelta gana a la exención del horario de wakeups. Es un buen ejemplo de por qué un arreglo de máquina de estados suele necesitar un seguimiento en la misma ventana, y ambos commits están en el mismo lote.
Dónde todavía no puede ayudar
- El proceso del backend tiene que seguir levantado. Un backend local lanzado desde la app de escritorio muere con la app. Para loops sin supervisión, ejecuta la session en un backend de larga vida: un
hermes serveremoto, o el dashboard. - Para trabajo que debe sobrevivir a reinicios y terminales,
/loopes la herramienta equivocada por diseño: vive dentro de una session, mientras que cron vive fuera de todas ellas. Para esa división, consulta nuestra guía completa de automatización con cron y la referencia de hermes cron. - Para
/loopen sí —intervalos fijos, cadencia autocompasada, el alias/proactive—, la guía del comando loop tiene los ejemplos desarrollados.
El ajuste y los comandos
ws_orphan_reap_grace_s vale 20.0 segundos por defecto y se puede sobrescribir con la variable de entorno HERMES_TUI_WS_ORPHAN_REAP_GRACE_S. La documentación oficial de configuración sugiere subirlo junto con los valores de keepalive si tus clientes se reconectan despacio, y señala que el mantenimiento periódico de sessions también completa la limpieza de sockets cerrados y vuelve a armar un temporizador de huérfanos que falte, así que un chat desacoplado no puede retener su arriendo de propiedad para siempre solo porque su limpieza o su temporizador inicial se perdieran.
Uso diario:
/loop 5m check the deploy status and tell me if it's live yet
/loop 10m /recap
/loop            # sin intervalo: Hermes se marca su propio ritmo (suelo de 1m, techo de 15m)
/heartbeat       # haz que la session informe con una cadencia en lugar de volver a ejecutar un prompt
Estado de la release
El PR #135393 y el seguimiento 0670ba4524 se fusionaron el 2026-10-09, después de que v0.21.6 se publicara el 8 de octubre, así que ahora mismo están solo en origin/main. hermes update los recogerá, o espera a la próxima release; el panorama de estabilidad más amplio está en nuestra página de la release v0.21.6.
La conclusión
El bug no era un temporizador inexacto. Era un reaper que no sabía que la session todavía tenía trabajo pendiente. El arreglo le da al reaper una pregunta explícita que hacer —¿es este proceso el único motor de un horario activo?— y solo entonces retiene la recolección. Si quieres que un loop se ejecute de verdad sin supervisión, actualizar es la mitad; la otra mitad es asegurarte de que el backend sobreviva a tu portátil, lo cual es una decisión de despliegue, no un bug.