Feche o notebook e seu /loop morre: por que os agendamentos destacados agora sobrevivem
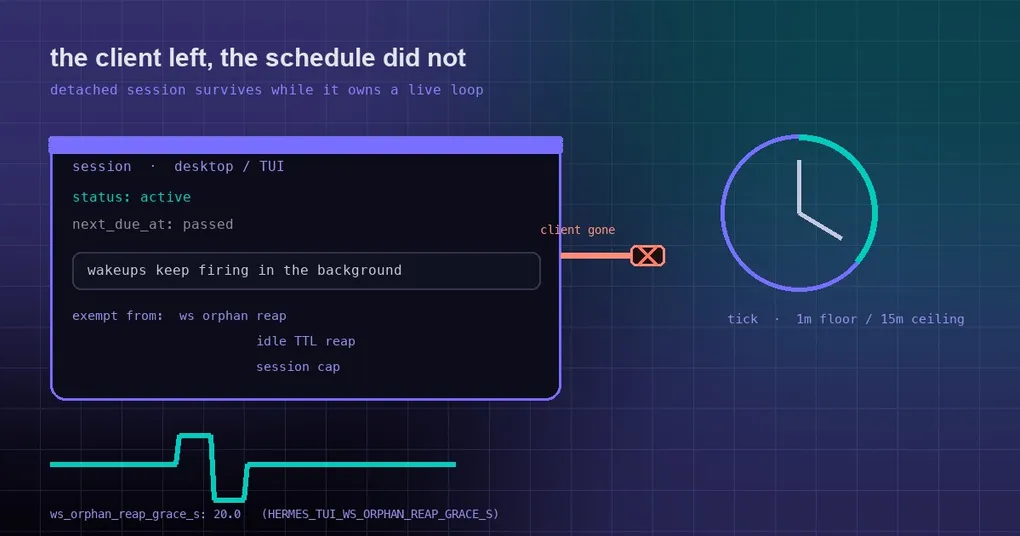
São 23h. Você digita /loop 10m watch the CI build and tell me when it's green no app de desktop, fecha o notebook e vai dormir. De manhã, a conversa está vazia — nenhum wakeup. O status do loop ainda diz active, e seu próximo horário previsto passou há horas. Nada congelou o timer; não sobrou ninguém para disparar.
Esse era um defeito real para /loop e /heartbeat no app de desktop, no chat do dashboard e na TUI: no momento em que o cliente se desconectava, a sessão era recolhida e o agendamento ia junto. O PR #135393 corrigiu isso em 9 de outubro com uma ideia direta — uma sessão que ainda detém um agendamento ativo fica isenta dos reapers. Veja por que congelava, o que a correção faz e onde ela ainda não pode ajudar.
Primeiro: quem dispara um tick de loop?
/loop é um timer dentro da sessão. Cada tick reexecuta seu prompt como um turno de verdade contra o estado atual — checa a execução do CI, checa a fila, lê o arquivo como ele está agora — em vez de repetir a primeira resposta. Os ticks precisam de alguém para disparar.
Existem dois tipos de driver no Hermes:
- Loops roteados. Um
/loopdefinido a partir de uma plataforma de mensagens (Telegram, Discord, Slack, …) carrega umaroute(plataforma + chat_id) em seu estado. O scanner de wakeup do próprio gateway de mensagens dispara esses —gateway/run_goals.py::_loop_wakeup_fire_one. Eles nunca dependeram de um cliente conectado. - Loops sem rota. Um loop definido no app de desktop, no chat do dashboard ou na TUI não tem rota. Seu único driver é a thread de poller de notificações por sessão dentro do backend que a atende —
_maybe_fire_tui_loop_tick/_maybe_fire_tui_heartbeat_tickemtui_gateway/session_notifications.py.
O segundo tipo é o problema, porque essa thread nasce e morre junto com o registro da sessão. Na desconexão:
_schedule_ws_orphan_reaparma um timer cujo período de carência vem dews_orphan_reap_grace_s— 20 segundos por padrão;- quando ele dispara, uma sessão destacada ociosa (
running=False) é removida e desmontada. Só o trabalho delegado vivo e um turno que está de fato em execução ficam isentos; - o teardown dispara o evento de parada do poller, então nenhum tick seguinte volta a ser reivindicado;
- o estado persistido do loop ainda lê
active, enext_due_atsimplesmente passa. Ao reconectar, o tick atrasado dispara uma vez — sem uma rajada de ticks de recuperação.
O reaper de TTL (_reap_idle_sessions) e o limite de sessões (_enforce_session_cap) podem recolher a mesma sessão depois, pelo mesmo motivo.
A correção: se o agendamento é seu para disparar, a sessão fica
O patch adiciona uma checagem, _session_owns_live_wakeup_schedule(session), que significa exatamente isto: se este processo é o único driver de um /loop ou /heartbeat ativo para aquela sessão, os reapers precisam manter viva a sessão destacada — e com ela o poller — ou o agendamento congela até um cliente reconectar. Agendamentos roteados são disparados pelo gateway, então nunca prendem uma sessão aqui.
Os três caminhos de reaping agora fazem essa pergunta primeiro: o reaper de órfãs do WebSocket, o reaper de TTL ocioso e o corte por limite de sessões.
Os limites são deliberados, e não um “mantenha para sempre”:
- um loop faz pausa conforme seu próprio orçamento de ticks (tanto o ritmo automático quanto o teto de orçamento são limitados);
- um agendamento parado ou pausado libera a sessão imediatamente;
- a checagem falha de forma permissiva para
False— um armazenamento de estado ilegível nunca deve tornar uma sessão impossível de ser recolhida.
Uma segunda correção chegou no mesmo dia: interrupções estabilizadas
A própria isenção tinha um deadlock. Um turno destacado interrompido arma tanto o latch de cliente sumido quanto o de cancelamento de turno. Se o /loop ativo então rearmava o timer de órfãs depois de o turno já ter se estabilizado, nenhum latch jamais era limpo: nenhum tick conseguia reivindicar o turno, e toda reconexão era recusada com 4009, de modo que o loop nunca atingia seu orçamento.
O commit 0670ba4524, integrado no mesmo dia, resolve isso: uma interrupção de cliente sumido já estabilizada vence a isenção de agendamento de wakeup. É uma boa ilustração de por que uma correção de máquina de estados geralmente precisa de um follow-up na mesma janela — e os dois commits estão no mesmo lote.
Onde ela ainda não pode ajudar
- O processo de backend precisa continuar de pé. Um backend local iniciado pelo desktop encerra junto com o app. Para loops sem supervisão, rode a sessão em um backend de vida longa — um
hermes serveremoto, ou o dashboard. - Para trabalho que precisa sobreviver a reinícios e terminais, o
/loopé a ferramenta errada por design: ele vive dentro de uma sessão, enquanto o cron vive fora de todas elas. Para essa divisão, veja nosso guia completo de automação com cron e a referência de hermes cron. - Para o próprio
/loop— intervalos fixos, cadência automática, o alias/proactive— o guia do comando loop tem os exemplos resolvidos.
O knob e os comandos
ws_orphan_reap_grace_s tem como padrão 20.0 segundos e pode ser sobrescrito com a variável de ambiente HERMES_TUI_WS_ORPHAN_REAP_GRACE_S. A documentação oficial de configuração sugere aumentá-lo junto com os valores de keepalive se seus clientes reconectam devagar, e observa que a manutenção periódica de sessões também conclui a limpeza de sockets fechados e rearma um timer de órfãs ausente — então um chat destacado não consegue segurar sua concessão de posse para sempre só porque sua limpeza inicial ou seu timer se perdeu.
Uso no dia a dia:
/loop 5m check the deploy status and tell me if it's live yet
/loop 10m /recap
/loop            # sem intervalo: o Hermes regula o próprio ritmo (piso de 1m, teto de 15m)
/heartbeat       # faça a sessão reportar em uma cadência em vez de reexecutar um prompt
Status da release
O PR #135393 e o follow-up 0670ba4524 foram integrados em 2026-10-09, depois de a v0.21.6 ser lançada em 8 de outubro, então eles estão apenas em origin/main agora. O hermes update vai buscá-los, ou espere a próxima release; o panorama mais amplo de estabilidade está na nossa página da release v0.21.6.
A conclusão
O bug não era um timer impreciso. Era um reaper que não sabia que a sessão ainda tinha trabalho pendente. A correção dá ao reaper uma pergunta explícita a fazer — este processo é o único driver de um agendamento ativo? — e só então deixa de recolher a sessão. Se você quer que um loop rode de fato sem supervisão, atualizar é metade do caminho; a outra metade é garantir que o backend sobreviva ao seu notebook, o que é uma escolha de implantação, não um bug.