Fermez le portable et votre /loop meurt : pourquoi les planifications détachées survivent désormais
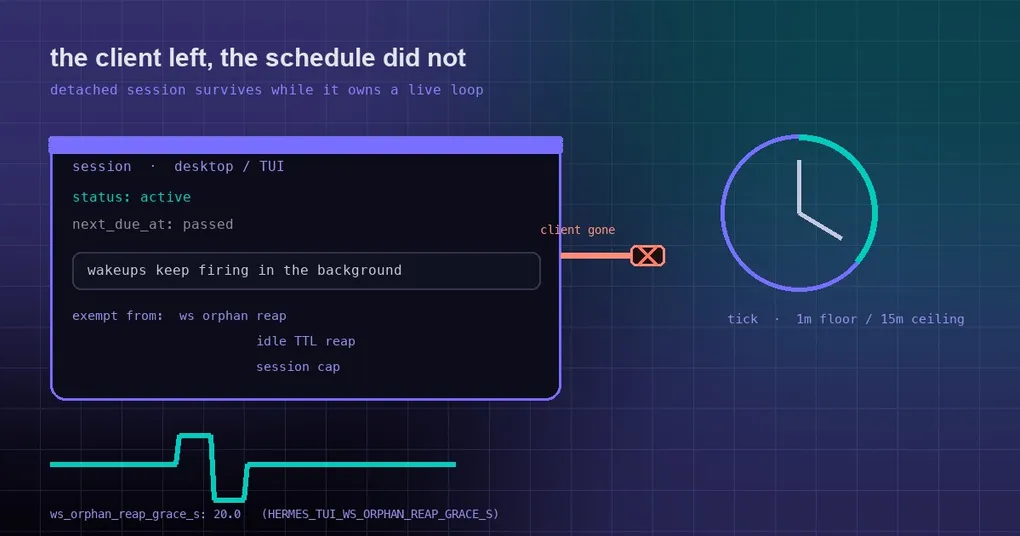
Il est 23 h. Vous tapez /loop 10m watch the CI build and tell me when it's green dans l’application desktop, fermez le portable et allez vous coucher. Au matin, le fil est vide — aucun réveil. Le statut du loop affiche toujours active, et son prochain déclenchement prévu est passé depuis des heures. Rien n’a gelé le minuteur ; il ne restait personne pour le déclencher.
C’était un vrai défaut pour /loop et /heartbeat dans l’application desktop, le chat du dashboard et la TUI : dès que le client se déconnectait, la session était récupérée et la planification partait avec elle. La PR #135393 l’a corrigé le 9 octobre avec une idée directe — une session qui possède encore une planification vivante est exemptée des reapers. Voici pourquoi cela gelait, ce que fait le correctif, et où il ne peut toujours pas vous aider.
D’abord : qui déclenche un tick de loop ?
/loop est un minuteur intra-session. Chaque tick réexécute votre prompt comme un vrai tour face à l’état actuel — vérifier le run CI, vérifier la file, lire le fichier tel qu’il est maintenant — plutôt que de rejouer la première réponse. Les ticks ont besoin de quelqu’un pour les déclencher.
Il existe deux sortes de moteur dans Hermes :
- Loops routés. Un
/loopdéfini depuis une plateforme de messagerie (Telegram, Discord, Slack, …) porte uneroute(plateforme + chat_id) dans son état. C’est le scanner de réveil propre au gateway de messagerie qui les déclenche —gateway/run_goals.py::_loop_wakeup_fire_one. Ils n’ont jamais dépendu d’un client attaché. - Loops sans route. Un loop défini dans l’application desktop, le chat du dashboard ou la TUI n’a pas de route. Son seul moteur est le thread poller de notifications par session à l’intérieur du backend servant —
_maybe_fire_tui_loop_tick/_maybe_fire_tui_heartbeat_tickdanstui_gateway/session_notifications.py.
La seconde sorte est le problème, car ce thread naît et meurt avec l’enregistrement de session. À la déconnexion :
_schedule_ws_orphan_reaparme un minuteur dont le délai de grâce provient dews_orphan_reap_grace_s— 20 secondes par défaut ;- quand il se déclenche, une session détachée inactive (
running=False) est retirée et démontée. Seul le travail délégué en cours et un tour réellement en train de s’exécuter sont exemptés ; - le démontage positionne l’événement d’arrêt du poller, donc plus aucun tick n’est jamais revendiqué ;
- l’état persistant du loop affiche toujours
active, etnext_due_atest simplement dépassé. À la reconnexion, le tick en retard se déclenche une fois — pas de rafale de ticks de rattrapage.
Le reaper TTL (_reap_idle_sessions) et le plafond de sessions (_enforce_session_cap) peuvent récupérer la même session plus tard pour la même raison.
Le correctif : si la planification est à vous de déclencher, la session reste
Le patch ajoute une vérification, _session_owns_live_wakeup_schedule(session), qui signifie exactement ceci : si ce processus est le seul moteur d’un /loop ou /heartbeat actif pour cette session, les reapers doivent garder la session détachée — et avec elle le poller — en vie, sinon la planification gèle jusqu’à la reconnexion d’un client. Les planifications routées sont déclenchées par le gateway, donc elles n’épinglent jamais une session ici.
Les trois chemins de reaping posent désormais cette question en premier : le reaper d’orphelins WebSocket, le reaper TTL d’inactivité et l’élagage du plafond de sessions.
Les limites sont délibérées plutôt qu’un « garder pour toujours » :
- un loop se met en pause selon son propre budget de ticks (l’auto-cadence et le plafond de budget sont tous deux bornés) ;
- une planification arrêtée ou en pause libère la session immédiatement ;
- la vérification échoue ouvertement vers
False— un magasin d’état illisible ne doit jamais empêcher une session d’être récupérée par un reaper.
Un second correctif est arrivé le même jour : les interruptions réglées
L’exemption elle-même comportait un deadlock. Un tour détaché interrompu positionne à la fois les verrous client-gone et turn-cancel. Si le /loop actif réarmait ensuite le minuteur d’orphelin après que ce tour s’était déjà réglé, aucun des deux verrous ne se libérait : aucun tick ne pouvait revendiquer le tour, et toute reconnexion était refusée avec 4009, si bien que le loop n’atteignait jamais son budget.
Le commit 0670ba4524, fusionné le même jour, le résout : une interruption client-gone réglée l’emporte sur l’exemption de planification de réveil. C’est une bonne illustration de la raison pour laquelle un correctif de machine à états nécessite généralement un suivi dans la même fenêtre — et les deux commits sont dans le même lot.
Là où il ne peut toujours pas aider
- Le processus backend doit rester actif. Un backend local lancé par le desktop s’arrête avec l’application. Pour des loops non surveillés, faites tourner la session sur un backend de longue durée — un
hermes servedistant, ou le dashboard. - Pour un travail qui doit survivre aux redémarrages et aux terminaux,
/loopest le mauvais outil par conception : il vit à l’intérieur d’une session, tandis que cron vit en dehors de toutes. Pour ce clivage, voir notre guide complet d’automatisation cron et la référence hermes cron. - Pour
/looplui-même — intervalles fixes, cadence auto-rythmée, l’alias/proactive— le guide de la commande loop contient les exemples concrets.
Le réglage et les commandes
ws_orphan_reap_grace_s vaut 20.0 secondes par défaut et peut être redéfini avec la variable d’environnement HERMES_TUI_WS_ORPHAN_REAP_GRACE_S. La documentation officielle de configuration suggère de l’augmenter en même temps que les valeurs de keepalive si vos clients se reconnectent lentement, et note que la maintenance périodique des sessions achève aussi le nettoyage des sockets fermés et réarme un minuteur d’orphelin manquant — ainsi un chat détaché ne peut pas conserver son bail de propriété indéfiniment juste parce que son nettoyage initial ou son minuteur a été perdu.
Usage au quotidien :
/loop 5m check the deploy status and tell me if it's live yet
/loop 10m /recap
/loop            # pas d'intervalle : Hermes se cadence tout seul (plancher 1m, plafond 15m)
/heartbeat       # demander à la session de rapporter à une cadence au lieu de réexécuter un prompt
Statut des releases
La PR #135393 et le suivi 0670ba4524 ont tous deux été fusionnés le 2026-10-09, après la sortie de la v0.21.6 le 8 octobre, donc ils sont uniquement sur origin/main pour l’instant. hermes update les récupérera, ou attendez la prochaine release ; le tableau de stabilité plus large se trouve sur notre page de release v0.21.6.
À retenir
Le bug n’était pas un minuteur imprécis. C’était un reaper qui ignorait que la session avait encore du travail en attente. Le correctif donne au reaper une question explicite à poser — ce processus est-il le seul moteur d’une planification vivante ? — et ne retient la collecte qu’ensuite. Si vous voulez qu’un loop tourne vraiment sans surveillance, la mise à niveau n’en est que la moitié ; l’autre moitié consiste à s’assurer que le backend survit à votre portable, ce qui est un choix de déploiement, pas un bug.