没有用户 D-Bus 会话的 systemd 网关:Hermes 定时任务从硬失败改为降级运行
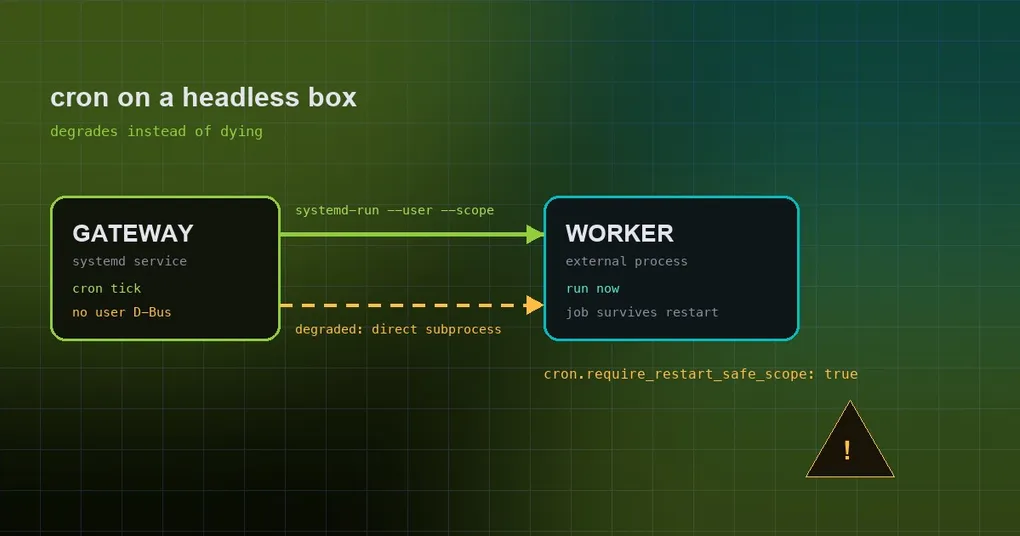
你在 VPS 或 Docker 容器里把 Hermes 装成了 systemd 服务。机器人聊天一切正常,工具也能调,进程一直活着。唯独定时任务从来不出现——每天早上该发的那份日报,一次都没到过。翻日志,在任务本该跑的那一分钟里,只有差不多同一句话:启动 worker 失败。你去搜这个错误,得到的答案总是同一句建议:用 systemd --user。可你的容器里根本没有登录会话,也没有显示管理器之类可以让用户管理器挂靠的东西。PR #109311 补的就是这个缺口:在这类宿主上,cron 任务以前是派发时就硬失败,现在会降级运行、照常跑完。
什么叫“重启安全”的定时任务
一句话:任务到点的时候,它不在网关进程里跑。它被交给一个独立的外部 worker 进程,而这个进程启动在一个 transient user scope 里(systemd-run --user --scope)——一个用完即弃的 cgroup,网关死了它还在。于是你在任务跑一半时重启网关(升级、改配置、systemctl restart),任务继续跑完,而不是跟着父进程一起消失。官方文档里这一节叫 “Restart-safe workers under systemd”。想把整个调度机制先过一遍,可以看定时任务自动化完整指南。
为什么无头宿主以前是硬失败
创建这个 scope 需要一个用户 systemd 会话,而用户会话又需要一个用户 D-Bus 会话。容器里通常没有登录会话;精简的 LXC 镜像没有;以服务账号运行、又没开 linger 的机器同样没有。这些宿主就是提供不了——官方文档点名的也正是这三种情况:容器、精简 LXC、没开 linger 的服务用户。修复之前,后果很干脆:每一个到点的 cron 任务都在派发时就失败,没有任何回退路径。如果你把 Hermes 跑在容器里,共享容器部署那篇还整理了其他会不一样的地方。
修法:降级运行,但把降级了什么说清楚
PR #109311(标题 “Cron jobs run on systemd gateways without a user D-Bus session”)于 2026-09-12 合入 main。它是 @kiwipaulrob 的 #102431 的抢救版,fix commit 保留原作者署名。标签 type/bug、comp/cron、P1;改动 +204 / −65,涉及 7 个文件。
根因是一个哨兵值。在 tools/process_registry.py 里,restart_safe_gateway_child_argv 以前只能表达两种结果:“能放进 scope”或者“托管不了,就留在进程内”。降级派发无处可去,只能塌进第二个桶,于是等于“非托管”。现在它返回 GatewayChildDispatch(mode, argv),mode 取 in_process、scoped、degraded 三者之一——降级派发有了自己的名字,不再落进那个非托管的哨兵值。
行为上,cron/scheduler.py 的 _launch_external_cron_worker 对 scoped 和 degraded 两种模式都会启动外部 worker,沿用已有的所有权交接机制。差别只在隔离级别:
| 模式 | 任务在哪跑 | 进程隔离 | cgroup 隔离 | 任务跑一半时重启网关 |
|---|---|---|---|---|
scoped |
外部 worker(transient user scope) | 保留 | 保留 | 任务继续跑 |
degraded |
外部 worker(直接跑命令) | 保留 | 丢失 | 任务会被杀掉 |
degraded 还会警告——每个网关进程只警告一次,而不是每个任务刷一条,免得把日志淹掉。文档也写得很直白:这类任务运行期间重启网关会把它杀掉,而执行台账(execution ledger)会记录这一点。
想让它继续硬失败?有一个开关
新配置键是 cron.require_restart_safe_scope,默认 false。源码里对默认值的注释说得很清楚:不开启时,降级为直接的外部子进程(警告一次,无 cgroup 隔离)。把它设为 true 就恢复原来的行为——fail-closed,抛错并附带 enable-linger 的补救说明。
cron:
require_restart_safe_scope: true有一个地方故意不看这个键:Kanban。hermes_cli/kanban_db_dispatch.py 传的是 require_restart_safe_scope=True,所以长驻的 Kanban worker 始终保持 fail-closed,不管你怎么配。这个设计说得通——一个本来就打算跑上几个小时的 worker,明确失败也比“跑到一半被日常重启干掉”更好。
根治办法:给网关用户一个会话
开关只是让你选择想怎么失败。要真正拿回 cgroup 隔离,网关用户得有一个用户会话:
sudo loginctl enable-linger <gateway-user>系统级安装(unit 由系统 systemd 管、而不是由用户管理器管)还需要在 unit 里设置 XDG_RUNTIME_DIR 和 DBUS_SESSION_BUS_ADDRESS,让网关进程找得到那个会话总线,然后重启网关。会话一旦存在,新派发的任务就重新具备走 scoped transient scope 的条件。
顺带一提:.tick.lock
排查“这个任务到底跑没跑”的时候,有个背景值得知道:cron 用一个文件锁防止重叠的调动机排重复执行同一批任务,锁在 ~/.hermes/cron/.tick.lock。它和这次的改动无关,但能解释为什么调度器再忙你也不会看到同一批任务被启动两次。
小结与状态说明
压缩成几句:在 systemd 网关没有用户 D-Bus 会话的机器上,cron 以前是硬失败,现在会降级——进程隔离保留、cgroup 隔离丢失,每个网关进程警告一次。cron.require_restart_safe_scope: true 恢复严格行为,而只有 enable-linger(系统级安装还要在 unit 里加上环境变量)才能把 cgroup 隔离真正拿回来。
时间线要说清楚:这次修复于 2026-09-12 合入 main,晚于 v0.21.2(2026-09-11 发布),所以还没有出现在正式发版里,v0.21.2 发版记录是当前的稳定基线。另外,它不属于缓存或重试类的修复——这里没有任何重试。它改的是失败方式的选择:以前硬失败,现在降级运行,并给你一个开关换回硬失败。
如果任务看起来压根就没跑过,先用 hermes cron doctor 做一次只读的全面体检,再回去啃调度器日志。