Les tâches cron de Hermes dégradent désormais au lieu d’échouer sur les gateways systemd sans session D-Bus utilisateur
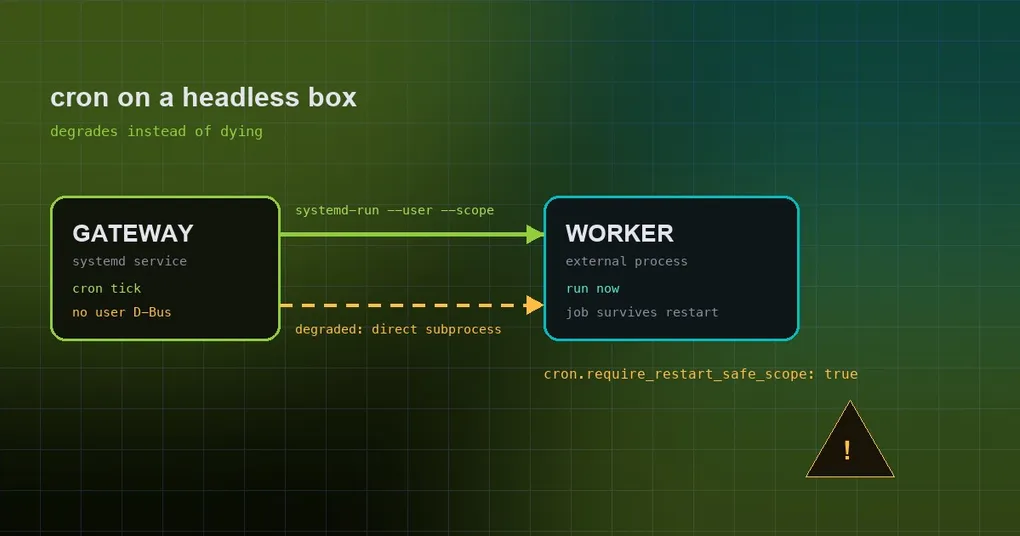
Vous avez installé Hermes comme service systemd sur un VPS ou dans un conteneur Docker. Le chat fonctionne, les outils fonctionnent, le bot reste en ligne. La seule chose qui n’arrive jamais, c’est la tâche planifiée : le récapitulatif quotidien censé tomber chaque matin. Dans le journal, à la minute où il aurait dû se déclencher, il y a toujours la même ligne : le worker n’a pas pu démarrer. Vous cherchez cette erreur et le conseil est invariablement d’utiliser systemd --user, sauf que votre conteneur n’a aucune session de connexion ni rien à quoi un gestionnaire de session utilisateur puisse s’accrocher. Le PR #109311 comble précisément ce trou : sur ces hôtes, les tâches cron échouaient autrefois durement au dispatch, et elles dégradent et s’exécutent maintenant.
Ce que signifie vraiment une tâche « restart-safe »
En clair : quand une tâche arrive à échéance, elle ne s’exécute pas dans le processus du gateway. Elle est confiée à un processus worker externe distinct, lancé dans un transient user scope (systemd-run --user --scope) — un cgroup jetable qui survit au gateway. Redémarrez le gateway en pleine tâche (une mise à jour, un changement de configuration, un systemctl restart) et la tâche continue au lieu de mourir avec son processus parent. La documentation officielle traite de ce point dans une section intitulée « Restart-safe workers under systemd ». Pour le tableau d’ensemble de l’ordonnanceur, voyez le guide complet de l’automatisation cron.
Pourquoi les hôtes sans session échouaient durement
Créer ce scope exige une session systemd utilisateur, et une session utilisateur exige une session D-Bus utilisateur. Les conteneurs n’ont en général pas de session de connexion ; les images LXC allégées non plus ; un compte de service lancé sans linger activé non plus. Ces hôtes ne peuvent tout simplement pas la fournir : la documentation nomme exactement ces trois cas — conteneurs, LXC allégés et comptes de service sans linger. Avant le correctif, le résultat était sans nuance : chaque tâche cron arrivée à échéance échouait au dispatch, sans voie de secours. Si vous faites tourner Hermes dans un conteneur, les notes sur le déploiement en conteneur partagé détaillent ce qui se comporte autrement dans ce cadre.
Le correctif : dégrader, en disant précisément ce qui est dégradé
Le PR #109311 (« Cron jobs run on systemd gateways without a user D-Bus session ») a rejoint main le 2026-09-12. C’est une récupération du #102431 de @kiwipaulrob, et le commit de correction conserve l’auteur d’origine. Étiquettes : type/bug, comp/cron, P1. Diff : +204 / −65 sur 7 fichiers.
La cause racine était une valeur sentinelle. Dans tools/process_registry.py, restart_safe_gateway_child_argv ne pouvait exprimer que deux issues : « tient dans un scope » ou « non gérable, à laisser dans le processus ». Un dispatch dégradé n’avait nulle part où aller sinon dans ce second casier, et retombait donc dans la sentinelle non gérée. La fonction renvoie désormais GatewayChildDispatch(mode, argv), où mode vaut in_process, scoped ou degraded : le dispatch dégradé a son propre nom et ne retombe plus dans la sentinelle.
Côté comportement, _launch_external_cron_worker dans cron/scheduler.py démarre un worker externe aussi bien en scoped qu’en degraded, en réutilisant le mécanisme de transfert de propriété déjà en place. Seul le niveau d’isolation diffère :
| Mode | Où tourne la tâche | Isolation de processus | Isolation cgroup | Redémarrage du gateway en pleine tâche |
|---|---|---|---|---|
scoped |
Worker externe (transient user scope) | Conservée | Conservée | La tâche continue |
degraded |
Worker externe (exécute la commande directement) | Conservée | Perdue | La tâche est tuée |
Une exécution en degraded émet en outre un avertissement — une seule fois par processus de gateway, et non une fois par tâche, pour ne pas noyer le journal. La documentation est explicite : redémarrer le gateway pendant qu’une telle tâche tourne la tue, et le registre d’exécution (execution ledger) l’enregistre.
Vous préférez le mode fail-closed ? Un interrupteur
La nouvelle clé de configuration est cron.require_restart_safe_scope, et sa valeur par défaut est false. Le commentaire du code source à ce sujet est sans détour : sans elle, Hermes dégrade vers un sous-processus externe direct (un avertissement, pas d’isolation cgroup). Passez-la à true et l’ancien comportement revient — fail-closed, avec une erreur accompagnée du remède enable-linger.
cron:
  require_restart_safe_scope: true
Un composant ignore volontairement cette clé. hermes_cli/kanban_db_dispatch.py passe require_restart_safe_scope=True, de sorte que les workers Kanban de longue durée restent en fail-closed quoi que vous configuriez. C’est délibéré : un worker conçu pour tourner des heures vaut mieux en échec bruyant qu’en mode où un redémarrage de routine du gateway le tue à mi-parcours.
La vraie solution : donner une session à l’utilisateur du gateway
L’interrupteur ne fait que choisir la manière d’échouer. Pour récupérer réellement l’isolation cgroup, l’utilisateur du gateway doit disposer d’une session utilisateur :
sudo loginctl enable-linger <gateway-user>Sur les installations au niveau système — où l’unité est gérée par le systemd système et non par un gestionnaire utilisateur — définissez en plus XDG_RUNTIME_DIR et DBUS_SESSION_BUS_ADDRESS dans l’unité pour que le processus du gateway trouve le bus de session, puis redémarrez le gateway. Une fois la session présente, les tâches nouvellement dispatchées disposent de nouveau de ce qu’il faut pour tourner dans un transient scope scoped.
Un détail connexe : .tick.lock
Une chose utile à savoir quand on commence à se demander « cette tâche a-t-elle vraiment tourné ? » : cron se protège des tickers qui se chevauchent avec un verrou de fichier dans ~/.hermes/cron/.tick.lock, ce qui empêche deux ticks d’exécuter deux fois le même lot de tâches. Cela n’a rien à voir avec ce changement, mais cela explique pourquoi vous ne verrez pas de lancements en double même quand l’ordonnanceur est occupé.
Résumé et statut
En bref : sur un gateway systemd dépourvu de session D-Bus utilisateur, cron échouait durement ; il dégrade désormais — isolation de processus conservée, isolation cgroup perdue, un avertissement par processus de gateway. cron.require_restart_safe_scope: true rétablit le comportement strict, et seul enable-linger (plus les variables d’environnement de l’unité pour les installations système) ramène vraiment l’isolation cgroup.
La chronologie compte : le correctif a rejoint main le 2026-09-12, après v0.21.2 (publiée le 2026-09-11), il n’est donc pas encore dans une version publiée — les notes de version v0.21.2 constituent la base stable actuelle. Et ce n’est pas un correctif de cache ni de nouvelle tentative : rien n’est réessayé ici. C’est un choix de mode de défaillance — échec dur avant, dégradation élégante maintenant, avec un interrupteur pour revenir à l’échec dur.
Si une tâche semble n’avoir jamais tourné, commencez par hermes cron doctor, un contrôle en lecture seule de toute la flotte, avant d’aller fouiller les journaux de l’ordonnanceur.