Las tareas cron de Hermes ahora degradan en lugar de fallar en gateways systemd sin sesión D-Bus de usuario
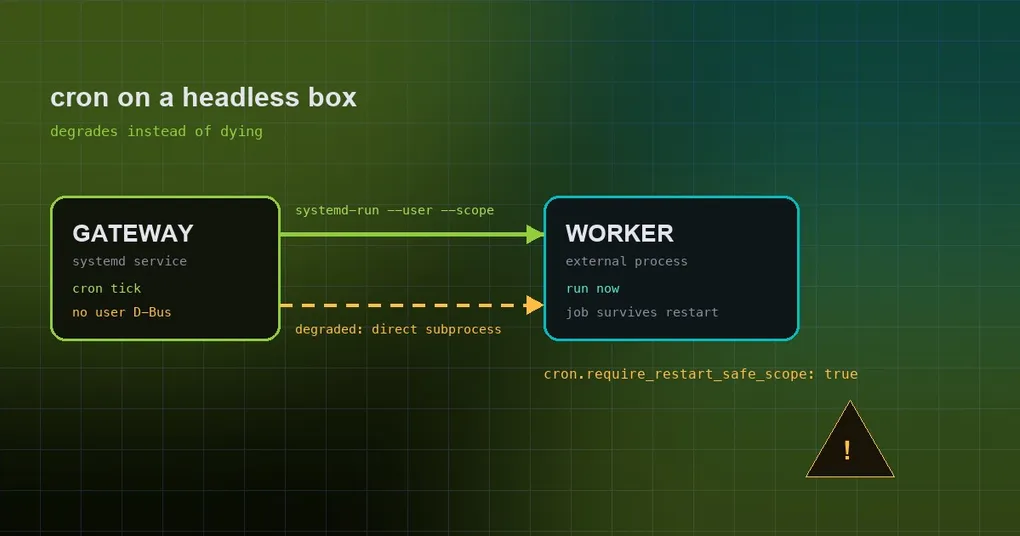
Instalaste Hermes como servicio systemd en un VPS o dentro de un contenedor Docker. El chat funciona, las herramientas funcionan, el bot sigue en línea. Lo único que nunca aparece es la tarea programada: el resumen diario que debería llegar todas las mañanas. En el log, justo en el minuto en que debería haberse disparado, siempre está la misma línea: el worker no pudo arrancar. Buscas ese error y el consejo es siempre el mismo, usar systemd --user, salvo que tu contenedor no tiene sesión de login ni nada a lo que un gestor de usuario pueda engancharse. El PR #109311 cierra exactamente esa brecha: en esos hosts las tareas cron antes fallaban en seco al despacharse, y ahora degradan y se ejecutan.
Qué significa de verdad una tarea “restart-safe”
Dicho simple: cuando una tarea llega a su hora, no se ejecuta dentro del proceso del gateway. Se entrega a un proceso worker externo aparte, que arranca dentro de un transient user scope (systemd-run --user --scope), es decir un cgroup desechable que sobrevive al gateway. Si reinicias el gateway a mitad de una tarea (una actualización, un cambio de configuración, un systemctl restart), la tarea sigue en marcha en lugar de morir con su proceso padre. En la documentación oficial esto aparece en la sección “Restart-safe workers under systemd”. Si quieres ver antes cómo encaja todo el planificador, tienes la guía completa de automatización con cron.
Por qué los hosts sin sesión fallaban en seco
Crear ese scope exige una sesión systemd de usuario, y una sesión de usuario exige una sesión D-Bus de usuario. Los contenedores normalmente no tienen sesión de login; las imágenes LXC reducidas tampoco; y una cuenta de servicio que corre sin linger habilitado tampoco. Esos hosts simplemente no pueden ofrecerla: la documentación nombra exactamente esos tres casos — contenedores, LXC reducidos y usuarios de servicio sin linger. Antes del arreglo el resultado era tajante: cada tarea cron que llegaba a su hora fallaba en el momento del despacho, sin ninguna vía de escape. Si ejecutas Hermes en un contenedor, las notas de despliegue compartido en contenedor repasan qué más se comporta distinto ahí.
El arreglo: degradar, y decir con precisión qué se degrada
El PR #109311 (“Cron jobs run on systemd gateways without a user D-Bus session”) entró en main el 2026-09-12. Es un rescate del #102431 de @kiwipaulrob, y el commit del arreglo conserva la autoría original. Etiquetas: type/bug, comp/cron, P1. Diff: +204 / −65 en 7 archivos.
La causa raíz era un valor centinela. En tools/process_registry.py, restart_safe_gateway_child_argv solo podía expresar dos resultados: “cabe en un scope” o “no se puede gestionar, déjalo en el proceso”. Un despacho degradado no tenía adónde ir más que a ese segundo cajón, así que colapsaba en el centinela no gestionado. Ahora devuelve GatewayChildDispatch(mode, argv), donde mode es uno de in_process, scoped o degraded: el despacho degradado tiene nombre propio y ya no se cuela por la puerta del centinela.
En cuanto al comportamiento, _launch_external_cron_worker de cron/scheduler.py arranca un worker externo tanto en scoped como en degraded, reutilizando el mecanismo de traspaso de propiedad que ya existía. La diferencia está solo en el nivel de aislamiento:
| Modo | Dónde corre la tarea | Aislamiento de proceso | Aislamiento de cgroup | Reinicio del gateway a mitad |
|---|---|---|---|---|
scoped |
Worker externo (transient user scope) | Se mantiene | Se mantiene | La tarea sigue corriendo |
degraded |
Worker externo (ejecuta el comando directamente) | Se mantiene | Se pierde | La tarea se mata |
Una ejecución en degraded además avisa, una sola vez por proceso del gateway y no una vez por tarea, para no ahogar el log. La documentación es explícita: reiniciar el gateway mientras esa tarea corre la mata, y el libro de ejecución (execution ledger) lo registra.
¿Prefieres fail-closed? Un interruptor
La nueva clave de configuración es cron.require_restart_safe_scope, y su valor por defecto es false. El comentario del propio código sobre ese valor por defecto lo dice sin rodeos: si no se activa, Hermes degrada a un subproceso externo directo (un aviso, sin aislamiento de cgroup). Ponla en true y recuperas el comportamiento antiguo — fail-closed, que lanza un error acompañado de la solución con enable-linger.
cron:
  require_restart_safe_scope: true
Hay un componente que ignora esta clave a propósito. hermes_cli/kanban_db_dispatch.py pasa require_restart_safe_scope=True, así que los workers de Kanban de larga duración se mantienen en fail-closed hagas lo que hagas en la configuración. Es deliberado: un worker pensado para correr durante horas está mejor fallando de forma ruidosa que corriendo en un modo donde un reinicio rutinario del gateway lo mata a medias.
La solución de raíz: dale una sesión al usuario del gateway
El interruptor solo elige cómo quieres fallar. Para recuperar el aislamiento de cgroup, el usuario del gateway necesita una sesión de usuario:
sudo loginctl enable-linger <gateway-user>En instalaciones a nivel de sistema, donde la unidad la gestiona el systemd del sistema y no un gestor de usuario, además hay que definir XDG_RUNTIME_DIR y DBUS_SESSION_BUS_ADDRESS en la unidad para que el proceso del gateway encuentre el bus de sesión, y luego reiniciar el gateway. Una vez que existe la sesión, las tareas recién despachadas vuelven a tener lo necesario para correr dentro de un transient scope scoped.
Un detalle de contexto: .tick.lock
Algo que conviene saber cuando empiezas a preguntarte “¿esta tarea se ejecutó de verdad?”: cron se protege de planificadores solapados con un bloqueo de archivo en ~/.hermes/cron/.tick.lock, que impide que dos ticks ejecuten dos veces el mismo lote de tareas. No tiene relación con este cambio, pero explica por qué no verás lanzamientos duplicados ni con el planificador ocupado.
Resumen y estado
En pocas palabras: en un gateway systemd sin sesión D-Bus de usuario, cron antes fallaba en seco; ahora degrada — se mantiene el aislamiento de proceso, se pierde el de cgroup, y hay un aviso por proceso del gateway. cron.require_restart_safe_scope: true recupera el comportamiento estricto, y solo enable-linger (más las variables de entorno de la unidad en instalaciones a nivel de sistema) devuelve de verdad el aislamiento de cgroup.
Los tiempos importan: el arreglo entró en main el 2026-09-12, después de v0.21.2 (publicada el 2026-09-11), así que todavía no está en una versión publicada; las notas de la versión v0.21.2 son la base estable actual. Y no es un arreglo de caché ni de reintentos: aquí no se reintenta nada. Es una elección de modo de fallo: antes fallo duro, ahora degradación elegante, con un interruptor para volver al fallo duro.
Si una tarea parece no haberse ejecutado nunca, empieza por hermes cron doctor, una comprobación de solo lectura para toda la flota, antes de meterte en los logs del planificador.