Hermes-Cron-Jobs degradieren jetzt, statt auf systemd-Gateways ohne User-D-Bus-Session hart zu scheitern
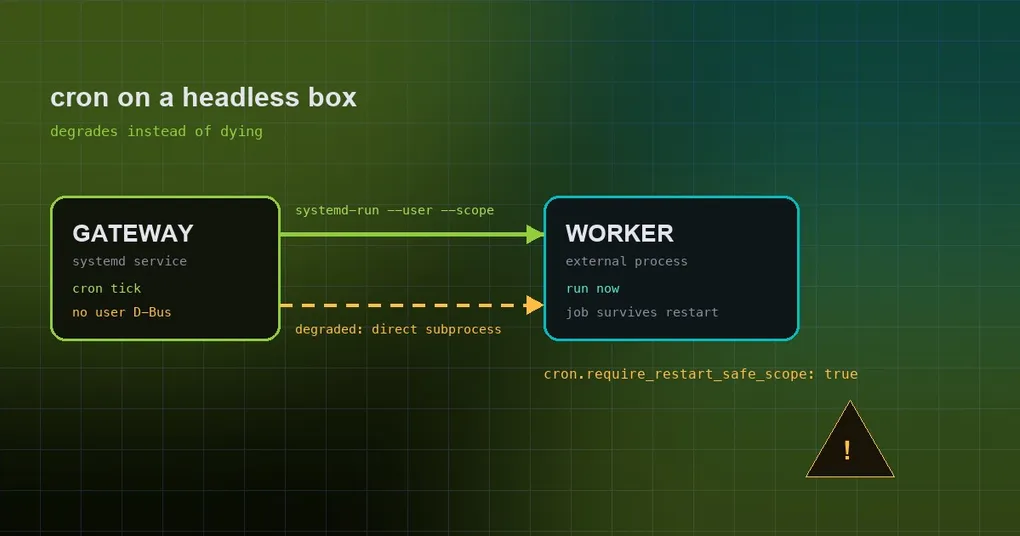
Du hast Hermes als systemd-Service auf einem VPS oder in einem Docker-Container installiert. Der Chat läuft, die Tools laufen, der Bot ist online. Nur der geplante Job taucht nie auf — die tägliche Zusammenfassung, die jeden Morgen kommen sollte. Im Log steht zur eigentlich fälligen Minute immer dieselbe Zeile: der Worker ließ sich nicht starten. Suchst du nach diesem Fehler, lautet der Rat jedes Mal, systemd --user zu verwenden — nur hat dein Container keine Login-Session und nichts, woran ein User-Manager andocken könnte. PR #109311 schließt genau diese Lücke: Auf solchen Hosts scheiterten Cron-Jobs früher hart beim Dispatch, jetzt degradieren sie und laufen trotzdem.
Was ein „restart-sicherer“ Job wirklich heißt
Einfach gesagt: Wenn ein Job fällig wird, läuft er nicht im Gateway-Prozess. Er wird an einen eigenen externen Worker-Prozess übergeben, der in einem transient user scope startet (systemd-run --user --scope) — einem Wegwerf-cgroup, das den Gateway überlebt. Startest du den Gateway mitten im Job neu (Upgrade, Konfigurationsänderung, systemctl restart), läuft der Job weiter, statt mit seinem Elternprozess zu sterben. In der offiziellen Dokumentation steht das im Abschnitt „Restart-safe workers under systemd“. Wer zuerst das Gesamtbild des Schedulers will, findet es im vollständigen Cron-Automation-Leitfaden.
Warum Headless-Hosts früher hart scheiterten
Dieses Scope zu erzeugen erfordert eine User-systemd-Session, und eine User-Session erfordert eine User-D-Bus-Session. Container haben meist keine Login-Session; schlanke LXC-Images haben keine; ein Service-Konto ohne aktiviertes linger ebenfalls nicht. Solche Hosts können sie schlicht nicht bereitstellen — die Dokumentation nennt genau diese drei Fälle: Container, schlanke LXC und Service-User ohne linger. Vor dem Fix war das Ergebnis unmissverständlich: Jeder fällige Cron-Job scheiterte beim Dispatch, ohne Ausweichroute. Wenn du Hermes in einem Container betreibst, findest du im Artikel zum gemeinsam genutzten Container-Deployment, was sich dort sonst noch anders verhält.
Der Fix: degradieren — und klar sagen, was degradiert wird
PR #109311 („Cron jobs run on systemd gateways without a user D-Bus session“) ging am 2026-09-12 in main ein. Es ist eine Rettung von @kiwipaulrobs #102431, und der Fix-Commit behält die ursprüngliche Autorschaft. Labels: type/bug, comp/cron, P1. Diff: +204 / −65 über 7 Dateien.
Die Ursache war ein Sentinel-Wert. In tools/process_registry.py konnte restart_safe_gateway_child_argv nur zwei Ergebnisse ausdrücken: „passt in ein Scope“ oder „nicht verwaltbar, bleibt im Prozess“. Ein degradierter Dispatch hatte keinen anderen Platz als diesen zweiten Topf und kollabierte damit in den unmanaged-Sentinel. Jetzt gibt die Funktion GatewayChildDispatch(mode, argv) zurück, wobei mode einen von in_process, scoped oder degraded annimmt — der degradierte Dispatch hat einen eigenen Namen und fällt nicht mehr durch.
Verhaltensseitig startet _launch_external_cron_worker in cron/scheduler.py sowohl bei scoped als auch bei degraded einen externen Worker und nutzt dabei den bestehenden Ownership-Handoff-Mechanismus. Der Unterschied liegt allein in der Isolationsstufe:
| Modus | Wo der Job läuft | Prozess-Isolation | cgroup-Isolation | Gateway-Neustart mittendrin |
|---|---|---|---|---|
scoped |
Externer Worker (transient user scope) | Bleibt | Bleibt | Job läuft weiter |
degraded |
Externer Worker (führt den Befehl direkt aus) | Bleibt | Geht verloren | Job wird gekillt |
Ein degraded-Lauf warnt außerdem — einmal pro Gateway-Prozess, nicht einmal pro Job, damit das Log nicht überläuft. Die Dokumentation ist eindeutig: Wird der Gateway neu gestartet, während so ein Job läuft, wird der Job gekillt, und das Execution-Ledger hält das fest.
Lieber fail-closed? Ein Schalter
Der neue Konfigurationsschlüssel heißt cron.require_restart_safe_scope und steht standardmäßig auf false. Der Kommentar zum Default im Quellcode sagt es unverblümt: Ohne ihn degradiert Hermes zu einem direkten externen Subprozess (eine Warnung, keine cgroup-Isolation). Auf true gesetzt kommt das alte Verhalten zurück — fail-closed, mit einem Fehler samt enable-linger-Abhilfe.
cron:
  require_restart_safe_scope: true
Eine Komponente ignoriert diesen Schlüssel bewusst. hermes_cli/kanban_db_dispatch.py übergibt require_restart_safe_scope=True, langlebige Kanban-Worker bleiben also fail-closed, egal wie du konfigurierst. Das ist Absicht: Ein Worker, der stundenlang laufen soll, scheitert besser laut als in einem Modus zu laufen, in dem ein routinemäßiger Gateway-Neustart ihn auf halber Strecke killt.
Die eigentliche Lösung: dem Gateway-User eine Session geben
Der Schalter wählt nur, wie du scheitern willst. Um die cgroup-Isolation wirklich zurückzubekommen, braucht der Gateway-User eine User-Session:
sudo loginctl enable-linger <gateway-user>Bei Installationen auf Systemebene — wo die Unit vom System-systemd statt von einem User-Manager verwaltet wird — setzt du zusätzlich XDG_RUNTIME_DIR und DBUS_SESSION_BUS_ADDRESS in der Unit, damit der Gateway-Prozess den Session-Bus findet, und startest den Gateway danach neu. Sobald die Session existiert, haben neu dispatchte Jobs wieder alles, was sie für einen scoped-Transient-Scope brauchen.
Ein verwandtes Detail: .tick.lock
Etwas, das man wissen sollte, sobald man sich fragt „Hat dieser Job überhaupt gelaufen?“: Cron schützt sich mit einem Dateilock unter ~/.hermes/cron/.tick.lock gegen überlappende Ticker, sodass zwei Ticks denselben Job-Stapel nicht doppelt ausführen. Mit dieser Änderung hat es nichts zu tun, erklärt aber, warum du auch bei beschäftigtem Scheduler keine doppelten Starts siehst.
Zusammenfassung und Status
Kurz gefasst: Auf einem systemd-Gateway ohne User-D-Bus-Session scheiterte Cron früher hart; jetzt degradiert es — Prozess-Isolation bleibt, cgroup-Isolation entfällt, eine Warnung pro Gateway-Prozess. cron.require_restart_safe_scope: true stellt das strenge Verhalten wieder her, und nur enable-linger (plus die Umgebungsvariablen der Unit bei System-Installationen) bringt die cgroup-Isolation tatsächlich zurück.
Der Zeitpunkt ist wichtig: Der Fix ging am 2026-09-12 in main ein, also nach v0.21.2 (veröffentlicht am 2026-09-11) — er ist damit noch in keinem Release enthalten; die Release Notes zu v0.21.2 sind die aktuelle stabile Basis. Und es ist kein Caching- oder Retry-Fix: Hier wird nichts wiederholt. Es ist eine Entscheidung über den Fehlermodus — früher harter Fehler, jetzt sanfte Degradierung, mit einem Schalter zurück zum harten Fehler.
Wenn ein Job aussieht, als wäre er nie gelaufen, starte mit hermes cron doctor — einer Read-only-Prüfung für die ganze Flotte —, bevor du dich durch die Scheduler-Logs gräbst.