As tarefas cron do Hermes agora degradam em vez de falhar em gateways systemd sem sessão D-Bus de usuário
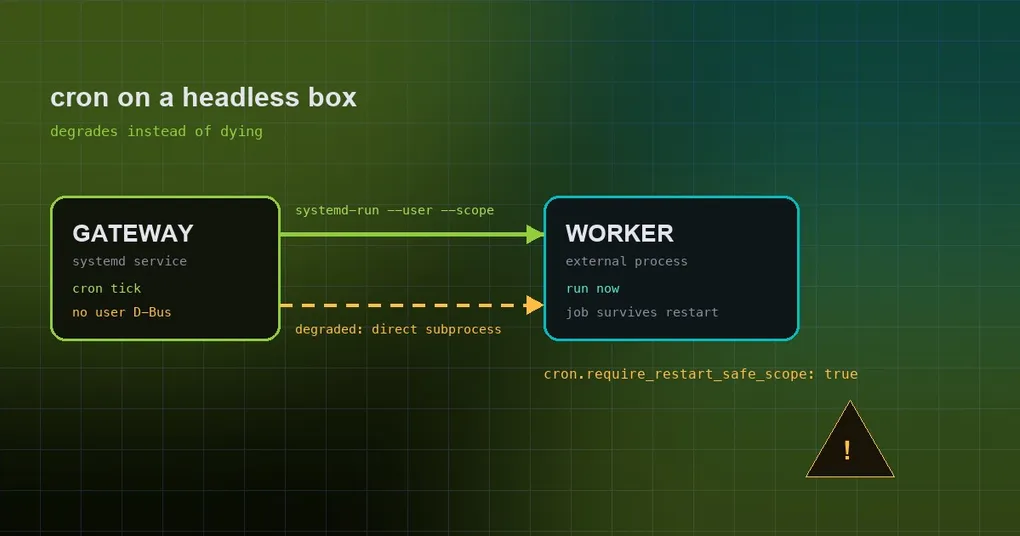
Você instalou o Hermes como serviço systemd em uma VPS ou dentro de um contêiner Docker. O chat funciona, as ferramentas funcionam, o bot segue no ar. A única coisa que nunca aparece é a tarefa agendada: o resumo diário que deveria chegar toda manhã. No log, no minuto em que ela deveria disparar, está sempre a mesma linha: o worker não conseguiu iniciar. Você pesquisa esse erro e o conselho é sempre o mesmo, usar systemd --user, só que seu contêiner não tem sessão de login nem nada onde um gerenciador de usuário possa se ancorar. O PR #109311 fecha exatamente essa lacuna: nesses hosts as tarefas cron antes falhavam de forma dura no despacho, e agora degradam e rodam.
O que uma tarefa “restart-safe” realmente significa
Em termos simples: quando uma tarefa chega na hora, ela não roda dentro do processo do gateway. Ela é entregue a um processo worker externo separado, iniciado dentro de um transient user scope (systemd-run --user --scope) — um cgroup descartável que sobrevive ao gateway. Reinicie o gateway no meio de uma tarefa (uma atualização, uma mudança de configuração, um systemctl restart) e a tarefa continua em vez de morrer junto com o processo pai. Na documentação oficial isso aparece na seção “Restart-safe workers under systemd”. Para entender antes como o agendador se encaixa por inteiro, veja o guia completo de automação com cron.
Por que hosts sem sessão falhavam de forma dura
Criar esse scope exige uma sessão systemd de usuário, e uma sessão de usuário exige uma sessão D-Bus de usuário. Contêineres normalmente não têm sessão de login; imagens LXC enxutas também não; uma conta de serviço rodando sem linger habilitado igualmente não. Esses hosts simplesmente não conseguem oferecê-la: a documentação cita exatamente esses três casos — contêineres, LXC enxuto e contas de serviço sem linger. Antes da correção o resultado era direto: cada tarefa cron que chegava na hora falhava no despacho, sem nenhum caminho alternativo. Se você roda o Hermes em contêiner, as notas de implantação em contêiner compartilhado mostram o que mais se comporta de forma diferente ali.
A correção: degradar, dizendo exatamente o que é degradado
O PR #109311 (“Cron jobs run on systemd gateways without a user D-Bus session”) entrou na main em 2026-09-12. É um resgate do #102431 de @kiwipaulrob, e o commit da correção mantém a autoria original. Rótulos: type/bug, comp/cron, P1. Diff: +204 / −65 em 7 arquivos.
A causa raiz era um valor sentinela. Em tools/process_registry.py, restart_safe_gateway_child_argv só conseguia expressar dois desfechos: “cabe em um scope” ou “não dá para gerenciar, deixa no processo”. Um despacho degradado não tinha para onde ir além dessa segunda caixa, então colapsava na sentinela não gerenciada. Agora ela retorna GatewayChildDispatch(mode, argv), em que mode é um entre in_process, scoped e degraded — o despacho degradado tem nome próprio e não cai mais na sentinela.
No comportamento, _launch_external_cron_worker em cron/scheduler.py inicia um worker externo tanto em scoped quanto em degraded, reaproveitando o mecanismo de transferência de propriedade que já existia. A diferença está só no nível de isolamento:
| Modo | Onde a tarefa roda | Isolamento de processo | Isolamento de cgroup | Reinício do gateway no meio |
|---|---|---|---|---|
scoped |
Worker externo (transient user scope) | Mantido | Mantido | A tarefa continua |
degraded |
Worker externo (executa o comando direto) | Mantido | Perdido | A tarefa é morta |
Uma execução em degraded também avisa — uma vez por processo de gateway, não uma vez por tarefa, para não afogar o log. A documentação é explícita: reiniciar o gateway enquanto essa tarefa roda a mata, e o registro de execução (execution ledger) registra isso.
Prefere fail-closed? Um interruptor
A nova chave de configuração é cron.require_restart_safe_scope, e o padrão dela é false. O comentário do próprio código sobre esse padrão é direto: sem ela, o Hermes degrada para um subprocesso externo direto (um aviso, sem isolamento de cgroup). Coloque em true e o comportamento antigo volta — fail-closed, lançando um erro com a solução via enable-linger.
cron:
  require_restart_safe_scope: true
Há um componente que ignora essa chave de propósito. O hermes_cli/kanban_db_dispatch.py passa require_restart_safe_scope=True, então workers Kanban de longa duração permanecem em fail-closed independentemente da sua configuração. Isso é intencional: um worker feito para rodar por horas falha melhor de forma barulhenta do que rodando em um modo em que um reinício de rotina do gateway o mata no meio do caminho.
A solução de verdade: dar uma sessão ao usuário do gateway
O interruptor só escolhe como você quer falhar. Para recuperar de fato o isolamento de cgroup, o usuário do gateway precisa de uma sessão de usuário:
sudo loginctl enable-linger <gateway-user>Em instalações no nível do sistema — em que a unit é gerenciada pelo systemd do sistema e não por um gerenciador de usuário — defina também XDG_RUNTIME_DIR e DBUS_SESSION_BUS_ADDRESS na unit, para que o processo do gateway encontre o barramento de sessão, e então reinicie o gateway. Com a sessão existindo, as tarefas recém-despachadas voltam a ter o que precisam para rodar dentro de um transient scope scoped.
Um detalhe relacionado: .tick.lock
Algo útil de saber quando você começa a perguntar “essa tarefa rodou mesmo?”: o cron se protege de tickers sobrepostos com um bloqueio de arquivo em ~/.hermes/cron/.tick.lock, o que impede que dois ticks executem o mesmo lote de tarefas duas vezes. Não tem relação com esta mudança, mas explica por que você não verá inicializações duplicadas mesmo com o agendador ocupado.
Resumo e status
Resumindo: em um gateway systemd sem sessão D-Bus de usuário, o cron antes falhava de forma dura; agora ele degrada — isolamento de processo mantido, isolamento de cgroup perdido, um aviso por processo de gateway. cron.require_restart_safe_scope: true restaura o comportamento estrito, e só o enable-linger (mais as variáveis de ambiente da unit em instalações no nível do sistema) traz o isolamento de cgroup de volta de verdade.
O momento importa: a correção entrou na main em 2026-09-12, depois da v0.21.2 (lançada em 2026-09-11), então ela ainda não está em nenhuma versão publicada — as notas de versão da v0.21.2 são a base estável atual. E não é uma correção de cache nem de retentativa: aqui nada é retentado. É uma escolha de modo de falha: falha dura antes, degradação graciosa agora, com um interruptor para voltar à falha dura.
Se uma tarefa parece nunca ter rodado, comece pelo hermes cron doctor, uma verificação somente leitura de toda a frota, antes de mergulhar nos logs do agendador.